---
title: "网页 class 变了,自动化脚本怎么定位元素?"
source: https://www.iowill.com/blog/2026/10/dynamic-class-locators/
date: 2026-10-10
updated: 2026-10-10
tags: [CSS选择器, DOM, Playwright, 浏览器自动化]
categories: [编程开发]
---
# 网页 class 变了,自动化脚本怎么定位元素?
评论按钮明明就在页面上,脚本却一直等到超时。如果你也遇到过这种情况,可以打开开发者工具,看看当初复制的 class 还在不在。
把新的类名换进去,往往又能跑了。可这样修几次之后就会发现,脚本好像一直在追着页面改。
前一篇写了[这些类名可能是怎么生成的](https://www.iowill.com/blog/2026/10/generated-class-names/)。不写死类名时,可以通过元素语义、属性和相对结构定位评论按钮与正文。本文用虚构的评论区 HTML 演示,昵称和属性都是示例。
## 类名变化与选择器失效
看到 `aK7mQ2pL` 这种名字,很容易把它理解成“每次打开网页都会随机生成”。但光看这串字符,还判断不了。
以 CSS Modules 的一种实现为例,css-loader 可以根据配置生成带哈希的类名,文件路径和名称等信息会参与生成。输入没变,结果不一定变;网站发了新版,相关输入变了,名称才可能跟着变化。[命名配置文档](https://github.com/webpack/css-loader#localidentname)里有具体说明。
页面也可能使用运行时样式,或者给不同访问展示不同版本。到底是哪一种,需要比较实际页面和资源,不能只凭使用了 React、Vue 就下结论。
不过,修脚本不必先查清整个网站的构建流程。既然这个 class 已经变过,就值得看看旁边还有什么可以用。
## 通过按钮名称定位
比如这个按钮:
```html
```
它有按钮角色,也有 `aria-label` 提供的名称。在 Playwright Python 里可以直接写:
```python
page.get_by_role("button", name="打开评论", exact=True).click()
```
这条定位不依赖 class。以后按钮换了颜色、换了样式类名,只要角色和名称没变,脚本就不用跟着改。
定位方式需要与实际页面结构对应。有些“按钮”只是一个绑定了点击事件的普通 `div`,没有按钮语义,照搬 `get_by_role("button")` 就找不到。Playwright 的[定位器文档](https://playwright.dev/python/docs/locators)也建议优先考虑用户可感知的属性和明确的测试约定。
## 通过 data 属性定位评论
展开评论区后,可能会看到这样的结构:
```html
```
这里已经把面板、评论、作者和正文标出来了,可以直接利用这些属性:
```python
panel = page.locator('[data-e2e="comment-panel"]:visible')
item = panel.locator('[data-e2e="comment-item"][data-id="demo-101"]')
author = item.locator('[data-e2e="comment-author"]').inner_text()
content = item.locator('[data-e2e="comment-content"]').inner_text()
```
这几行是先找面板,再找指定评论,最后取出它的作者和正文。`demo-101` 是这条演示记录的 ID,读取别的评论时自然要换成对应记录,不能把它当作列表通用选择器。
为什么不直接在整个页面找正文?因为页面里可能同时留着主页面评论区、弹层和隐藏的旧面板。不限定范围,匹配到的内容就可能来自另一个区域。
`data-e2e` 也没有什么特殊魔法。它属于网站自定义的 `data-*` 属性,名字和用途都由开发者决定,[HTML 本身并不保证它不会变](https://developer.mozilla.org/en-US/docs/Web/HTML/How_to/Use_data_attributes)。只是相较于随样式处理的类名,这种明确表示用途的标记更值得优先检查。
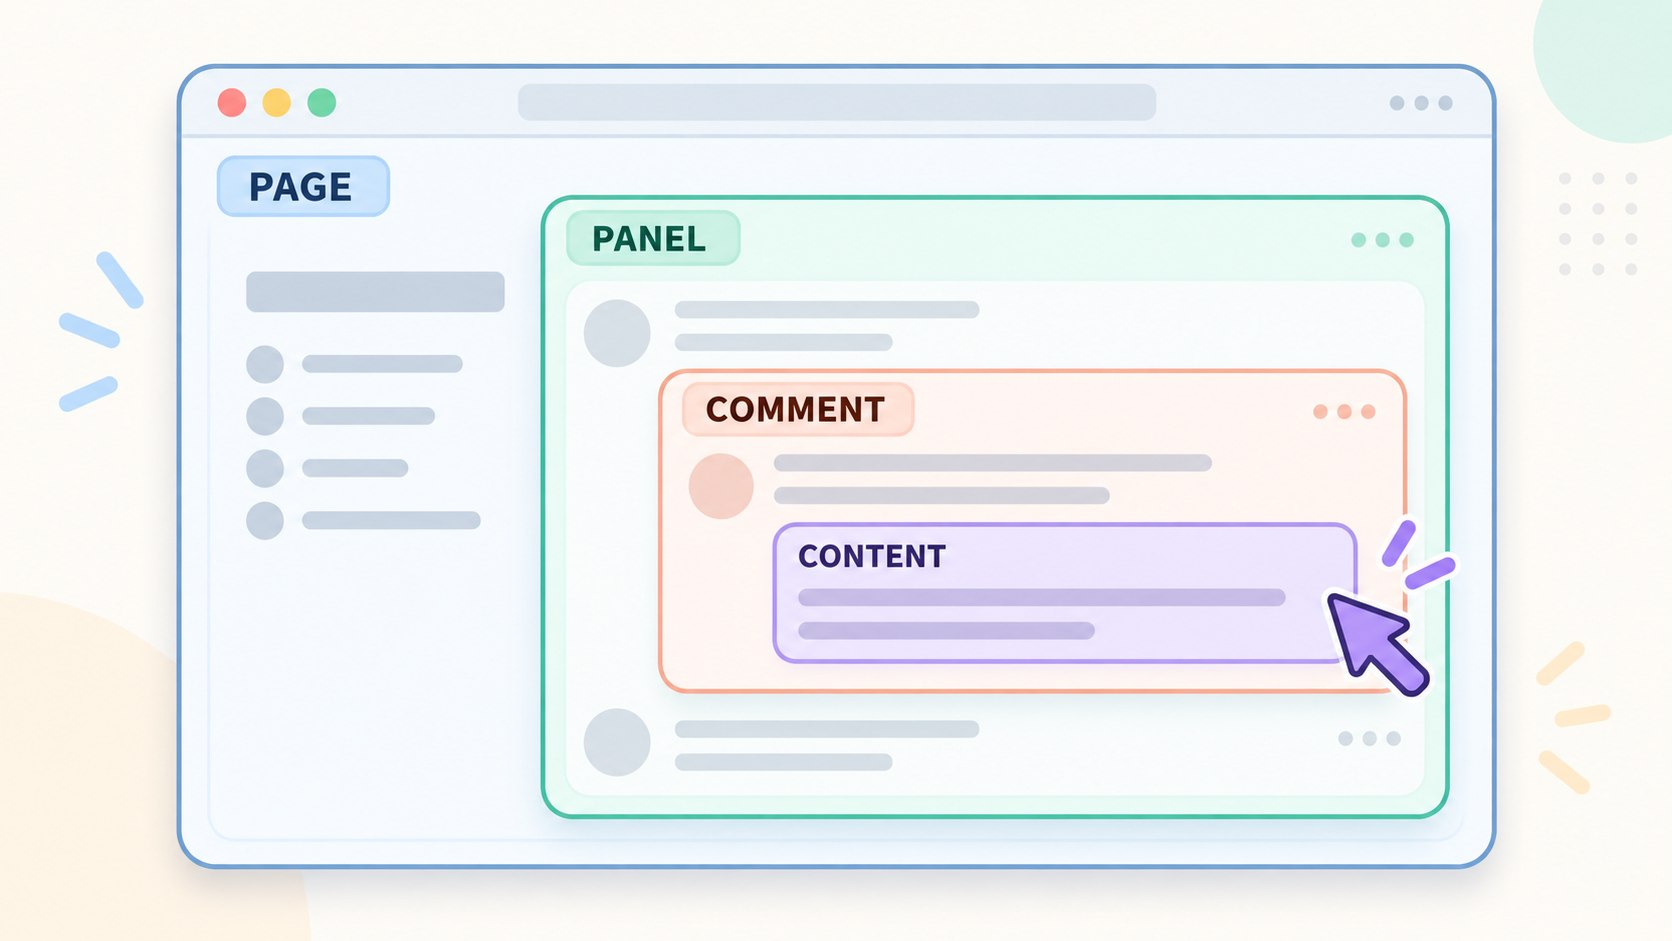
*先限定评论面板,再在单条评论内读取正文。*
## 相对路径与评论层级
没有好用的属性时,确实可以借助结构。比如先找到一条评论,再取作者信息后面的正文节点。
但如果复制出来的是这种路径:
```text
/html/body/div[2]/div[1]/div[3]/div[4]/span
```
就得小心了。中间随便多包一层 `div`,这条路径就可能失效。尽量把查找范围缩到目标记录里面,少依赖那些与内容无关的层级。
相邻关系也要检查。作者信息后面原本是正文,后来插入了一个提示条,脚本仍然可能读到文字,却已经读错了地方。
还有评论里的回复。一级评论下面嵌套了二级回复时,搜索父节点的全部后代,会连回复的作者和正文一起找到。出现多个匹配结果,先看它们分别来自哪里,别直接加个 `.first` 把报错压下去。
## 加载延迟也会导致定位超时
按钮点开了,列表却还没加载出来,这种情况也很常见。
排查时可以先停在出错的位置,看评论面板有没有展开,是加载中、空列表,还是已经显示了错误提示。节点如果在 iframe 里,还需要进入对应的 frame 定位。
对于确定有评论的测试页面,可以等第一条评论可见:
```python
expect(panel).to_be_visible()
expect(panel.locator('[data-e2e="comment-item"]').first).to_be_visible()
```
这里的 `.first` 只是用来判断列表开始显示,不是挑出某条业务记录。真实页面允许没有评论时,还要识别空状态,否则空列表也会一直等到超时。
第一条出现,也不代表全部加载完了。尤其是虚拟滚动列表,DOM 里可能只保留当前屏幕附近的内容,不能拿节点数量直接当评论总数。
## 验证:修改 class 后能否继续定位
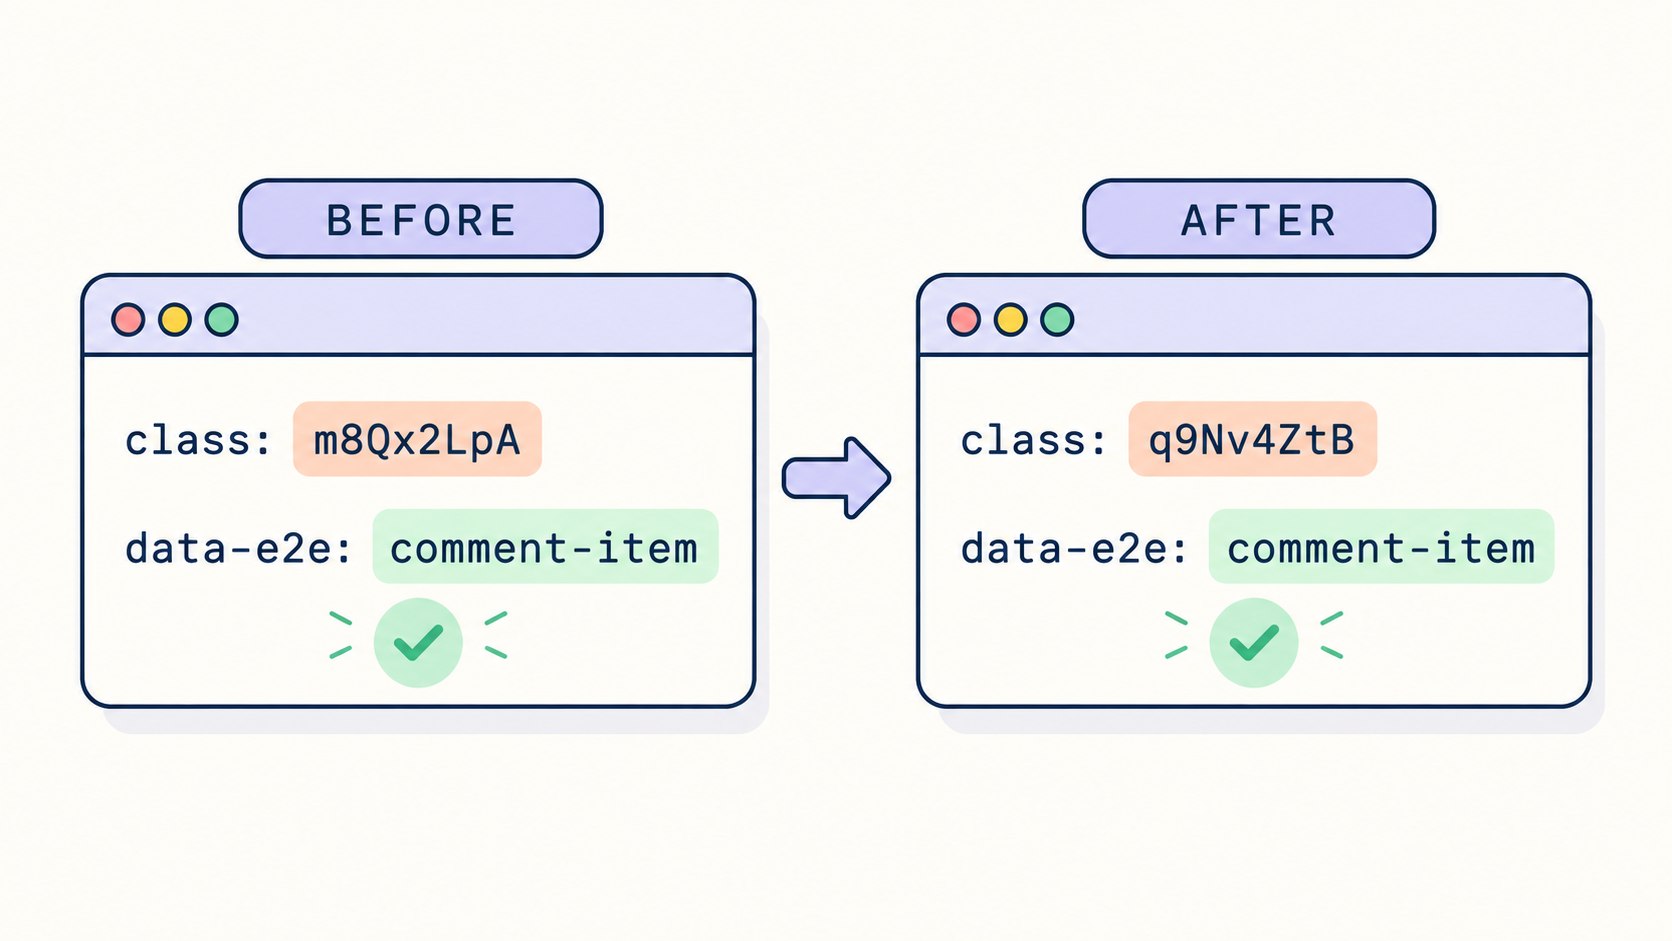
*这个实验只替换样式类名,定位所用的属性保持不变。*
使用最小示例页面验证前,安装依赖和浏览器:
```bash
python -m pip install playwright
python -m playwright install chromium
```
代码会打开评论面板,读取正文,然后把评论节点的 class 改掉,再读一次:
```python
from playwright.sync_api import sync_playwright, expect
HTML = """
"""
with sync_playwright() as p:
browser = p.chromium.launch()
page = browser.new_page()
page.set_content(HTML)
page.get_by_role("button", name="打开评论", exact=True).click()
panel = page.locator('[data-e2e="comment-panel"]:visible')
expect(panel).to_have_count(1)
expect(panel).to_be_visible()
item = panel.locator('[data-e2e="comment-item"][data-id="demo-101"]')
expect(item).to_have_count(1)
content = item.locator('[data-e2e="comment-content"]')
expect(content).to_have_text("这是一条演示评论。")
# 模拟样式类名发生变化,业务属性保持不变。
item.evaluate("el => el.className = 'q9Nv4ZtB'")
expect(page.locator('.m8Qx2LpA')).to_have_count(0)
expect(content).to_have_text("这是一条演示评论。")
print(content.inner_text())
browser.close()
```
这段示例已在本地运行通过,输出是:
```text
这是一条演示评论。
```
旧的 `.m8Qx2LpA` 已经匹配不到元素,按属性找到的正文仍然能读出来。原因也很简单:这次修改只动了 class,定位用到的属性还在。
写实际脚本时,可以把这类检查留着:面板是否唯一、目标字段是否存在、读到的内容是否属于当前记录。比起“没有抛异常就继续往下跑”,出问题时会好查得多。
至于评论去重,尽量使用页面实际提供的记录 ID,并带上所属页面、父评论等必要信息。两个人可能发一样的话,列表也可能在滚动时复用同一个节点,文字相同或位置相同,都不等于同一条评论。
维护选择器时,顺手记下它找的是哪个区域、正常应匹配几个元素。下次脚本再停住,就有东西可以对照,不用重新从一整页 DOM 里猜起。