这是一条演示评论。
# Billy 的博客 — full text --- --- title: "AI 绘图风格怎么定?从内容分类与标签到提示词" source: https://www.iowill.com/blog/2026/11/ai-image-style-prompts/ date: 2026-11-10 updated: 2026-11-10 tags: [AI 绘图, 内容创作, 提示词, 视觉设计] categories: [软件与工具] --- # AI 绘图风格怎么定?从内容分类与标签到提示词 **选择AI绘图风格,可以从内容分类和标签出发,再用图片用途确定主体、构图和材质。** 分类说明主题范围,标签补充对象与关系;封面与正文插图分别确定任务,再将需求写成可见的画面。 这套思路适用于社交媒体配图、演示文稿、课程材料、技术文档和产品概念图。本文整理了选择风格的方法、三组任务提示词,以及[82种风格的示例图与原创中文提示词](#style-library-cards),方便从具体任务找到可尝试的视觉方向。 风格库与卡片布局的灵感来自 [Workation Lab 的 AI Image Style Library](https://workationlab.com/ai-image-style-library)。本文的选择方法与中文提示词为作者整理;涉及工具能力的说明,分别引用Google、Adobe与Midjourney的官方文档。 ## 内容分类与画风分类 “数据库”“旅行”“产品介绍”说明内容讲什么;“水彩”“像素”“纸雕”说明画面怎样呈现。同一主题可以采用多种画风,选择取决于图片需要传达的信息。 例如,数据库备份既可以用技术示意图说明副本与恢复的关系,也可以用温暖插画为分享活动建立主题印象。两张图讲的是同一个主题,承担的任务不同。 | 信息层 | 要确定的问题 | 示例 | | --- | --- | --- | | 内容分类 | 属于哪个主题范围 | 技术知识、生活旅行、产品设计 | | 标签 | 本次内容涉及哪些对象或特征 | 数据库、备份、亲子、台灯 | | 使用任务 | 图片需要帮助读者完成什么 | 识别主题、理解关系、感受氛围、观察外观 | | 视觉方向 | 采用什么表现方式 | 扁平插画、等角示意、手绘、摄影感 | Google的Imagen指南把主体、背景或语境、风格分别列为提示词要素,可以据此拆开整理需求。[参考:Imagen提示词与图像属性指南](https://docs.cloud.google.com/vertex-ai/generative-ai/docs/image/img-gen-prompt-guide) 没有现成分类体系时,用一句话说明主题与用途即可。例如“为数据库恢复课程制作一张主题插画”,已经包含了内容范围和使用场景。  *图1:原创教学示意。分类与风格的对应为作者的编辑建议。* ## 不同分类适合什么封面与插图 封面用于识别主题和建立整体气质,正文插图用于说明具体对象、动作与关系。同一篇内容可以统一线条和配色,同时分别安排封面的概括性画面与正文的解释性画面。 下表是本文的编辑建议,用于选择候选方向。表中按内容主题分类,与后文风格库按绘画、材质和视角划分的7个分组不同。 | 内容方向 | 封面可尝试的风格 | 正文插图可尝试的风格 | 画面重点 | | --- | --- | --- | --- | | 技术原理与开发 | 扁平插画、等角场景 | 线稿、结构示意 | 对象、依赖与信息流 | | 系统运维与排障 | 等角微缩、简洁三维 | 分层示意、步骤对照 | 检查对象与状态变化 | | 算法与数据知识 | 几何扁平、积木式构成 | 数组、节点与步骤图 | 位置、连接和前后变化 | | 产品与工具介绍 | 棚拍感、轻量三维 | 功能拆解、操作示意 | 外形、材质与使用方式 | | 生活与旅行 | 水彩、明信片、胶片感 | 绘本、路线或场景图 | 地点、人物与共同活动 | | 阅读与文化内容 | 木刻、拼贴、复古印刷 | 线稿、叙事插画 | 文本主题与叙事氛围 | | 游戏与角色内容 | 卡通、像素、低多边形 | 动作、场景或机制示意 | 角色特征与玩法关系 | 封面尽量围绕一个主要视觉焦点组织画面,在缩略尺寸下检查主题是否仍可辨。正文插图则围绕当前段落的一件事展开,例如解释一次数据交接、一个对象的组成或两个状态的差异。 产品实物、界面操作和实际故障需要可核对的资料时,使用真实照片、截图或准确绘制的示意图;生成插画负责概念表达。算法中的数值、连线和状态,也需要按实际内容绘制与核对。 ### 本站五个分类的应用 以本站为例,已有配图基调是淡彩描边、圆润造型和柔和阴影。分类主要调整结构感、空间感与场景气质;下表的对象是选题示例,不把某个物件固定为一类文章的封面标志。 | 本站分类 | 示例标签 | 在统一画风中的侧重 | | --- | --- | --- | | 编程开发 | Python、Git、AI Agent | 封面突出模块、分支或协作关系;正文解释任务流与接口关系 | | 算法与数据结构 | LeetCode、数组、双指针 | 封面用简洁几何构成;正文用准确的数组、位置和步骤对照 | | 系统与运维 | Linux、Docker、DNS | 封面突出空间和层次;正文解释节点、请求路径及排查对象 | | 软件与工具 | DeepSeek、GEO、文档维护 | 封面强调使用场景或主要能力;正文说明功能、对比维度和操作 | | 游戏与实践 | 洛克王国、游戏攻略 | 封面采用与主题相符的角色或场景;正文结合实际素材说明玩法与获取条件 | 其他站点、课程和品牌可以使用自己的视觉规范。保持系列统一时,优先固定媒介、线条、配色等基础,再用每次的内容标签调整主体和动作。  *图2:原创教学示意,以Linux磁盘排查说明两种配图任务;并非运行截图,也不是后文未执行提示词的生成结果。* ## 把标签转成对象与关系 “可靠”“协作”“高效”表达了意图,但画面仍需要具体对象和动作。整理标签时,可以为每个关键词写出一层视觉解释。 | 内容标签 | 候选视觉表达 | 需要避免的误读 | | --- | --- | --- | | 数据备份 | 原始数据与独立副本、核对标记 | 把备份与实时同步混为一谈 | | 协作 | 不同角色围绕同一任务交换信息 | 多个人物只是站在一起,关系不清 | | 亲子 | 成人与儿童共同参与一个活动 | 只有儿童装饰元素,没有共同活动 | | 便携 | 物件与手部或携带场景的比例关系 | 用虚构尺寸和结构替代真实产品信息 | 多个标签需要有主次。“数据库、备份、恢复、安全、云计算”同时出现时,如果主要内容是恢复,就优先表现恢复所依赖的副本,其他元素用于补充情境。 “黑白线稿”“等角视图”这类标签本身已是视觉要求,可以直接放进风格或构图描述。“科技”“旅行”则仍是主题线索,需要结合具体任务确定画面。 ### 标签组合对应的视觉选择 同一分类内,标签可以继续缩小画面范围。技术名词用于确定对象与关系,材质词用于描述表面,情境词用于确定人物动作和氛围。 | 标签组合 | 可尝试风格 | 写进提示词的内容 | | --- | --- | --- | | Python、Git、协作 | 扁平插画、线稿 | 模块、分支与任务交接,突出这次要说明的关系 | | Linux、Docker、磁盘 | 等角微缩、结构线稿 | 服务器、容器或存储对象,区分主题意象与准确结构图 | | AI Agent、自动化 | 友好扁平、等角场景 | 输入、任务、工具与结果之间的联系,角色造型按内容选用 | | 数组、双指针、排序 | 几何扁平、步骤示意 | 元素位置与状态对照,具体数值和箭头后续准确绘制 | | 海边、亲子、周末 | 水彩、儿童绘本 | 成人与儿童共同进行的活动、海边环境和文案留白 | | 台灯、金属、阅读 | 棚拍感三维、材质草图 | 灯臂、连接处、磨砂表面和书桌情境 | | 安全、风险、异常 | 克制线稿、局部强调色 | 清楚的检查对象或异常位置,重点区域与背景形成区分 | 标签应服务于当前任务。例如“安全”可以用局部强调色标出检查点,也可以通过访问关系的示意表达;具体选哪种,取决于文章讲的是风险提醒还是机制说明。 ## 按使用场景安排画面 社交媒体配图需要快速传达主题,技术文档需要交代关系,产品概念图需要展示外形与材质。用途决定了信息密度、视觉重点和留白位置。 | 场景 | 优先解决的问题 | 可以考虑的方向 | | --- | --- | --- | | 社交媒体活动视觉 | 快速看出活动对象与氛围 | 明确主体、简洁背景、预留文案位置的插画 | | 演示文稿 | 与页面要点一起阅读 | 集中的视觉重心、清楚分组、与版式协调的构图 | | 技术文档与课程 | 看清步骤、对象及关系 | 结构化示意、有限装饰、可编辑的标注与连线 | | 产品概念展示 | 观察造型、材质和比例 | 摄影感、三维表达或方案草图 | 演示页可以指定主体放在右侧,给左侧文字留空间;产品展示可以指定斜前方视角,让连接部位和表面质感更容易观察。画幅与输出尺寸再按发布载体设置。 Adobe为Firefly分别提供构图参考与风格参考功能。构图关注元素的安排,风格关注画面观感,整理需求时也应分别说明。[参考:Firefly构图参考](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/match-image-composition-to-reference-image.html)、[Firefly风格参考](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/reference-images-for-styling.html) 技术图中的箭头、数量和标注需要逐项核对。准确的流程关系和文字,建议用可编辑的绘图或排版工具完成,再结合AI生成的视觉元素。 ## 用具体特征描述风格 “高级”“温暖”“有科技感”可以表达初步倾向,更具体的视觉特征有助于说明要保留什么、调整什么。 - **表现媒介**:线稿、水彩、扁平插画、三维材质、摄影感。 - **形状与线条**:几何或有机轮廓,清晰描边或柔和边缘,简化形体或局部细节。 - **色彩与明暗**:主色、饱和度、明暗关系、背景与主体的区分。 - **材质与光照**:纸张、磨砂、金属、织物,以及柔和或定向的光线。 - **构图与密度**:主体位置、视角、留白、空间层次和辅助元素数量。 Midjourney的基础提示词文档也按主体、媒介、环境、光照、色彩、情绪和构图等维度组织描述。[参考:Midjourney Prompt Basics](https://docs.midjourney.com/hc/en-us/articles/32023408776205-Prompt-Basics) 下面这段描述堆叠了多个方向,却没有说明各自作用的位置: ```text 科技感、温暖、写实、卡通、极简、复杂细节、电影感、白色背景。 ``` 如果希望技术主题显得清楚、温和,可以明确媒介、配色和细节范围: ```text 简化的技术主题插画,圆润几何形体,细描边,低饱和蓝绿主色, 少量暖色突出关键对象,浅色背景与柔和阴影,主体清楚,辅助元素少。 ``` “极简”与“复杂细节”也可以同时使用,但需要说明层次,例如整体留白充分,只在主体表面保留细密纹理。简单图标重点描述轮廓和颜色;产品概念图则可以多说明材质与光照。 ## 从分类与标签写出提示词 把主题、标签和使用任务连起来,可以按以下顺序整理提示词: ```text 内容主题与主要对象 +需要表达的动作、状态或关系 +图片用途和视觉重点 +表现媒介与少量关键风格特征 +构图、画幅和必要约束 ``` Adobe建议使用直接、具体的主体与描述性关键词。工具中的独立风格、构图或参考图设置,应与文本一起记录。[参考:Firefly提示词指南](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/writing-effective-text-prompts.html) 以下封面、正文插图与三组场景提示词均为本文编写的文字示例,尚未执行图像生成。 ### 同一主题的封面与正文插图 以“系统与运维”中的Linux磁盘空间排查为例,标签可以是“Linux、磁盘空间、故障排查”。封面概括空间紧张的主题,正文图分别解释检查对象。 封面提示词: ```text 用于Linux服务器磁盘空间排查文章的横向封面。 以淡彩描边的等角插画表现简化服务器,旁边放置接近满载的容量块面, 用少量暖橙色强调需要检查的区域,其余采用低饱和蓝绿配色。 主体清楚、周围留白,不放终端命令、故障数值或大段文字。 ``` 正文插图提示词: ```text 用于同一篇文章的排查对象说明图。 以简洁二维线稿分为容量与inode、文件分布、进程占用三个独立区域, 用统一线宽和配色表现磁盘、目录与进程等对象,保留标注空间。 文字和检查顺序在后续排版中加入,不生成终端输出、真实路径或告警数值。 ``` 这两张图共用配色与图形语言,分别承担主题识别和对象解释的任务。正文图仍需结合真实排查步骤补充标注;它表达的是检查对象的分组。 ### 数据库备份演示配图 分类为“技术知识”,标签为“数据库、备份、恢复”,用途是演示页主题插图。画面重点是副本与恢复的联系。 ```text 用于数据恢复主题演示页的扁平插画。一个简化数据库容器旁放置独立的备份副本, 副本带有核对标记,旁边用恢复动作的视觉符号呼应主题。 圆润几何形体与细描边,低饱和蓝绿主色,少量暖色强调备份副本。 主体集中在画面右侧,左侧预留页面文案空间,浅色背景,柔和阴影。 画面内仅保留图形,文字由后续排版加入。 ``` 生成后检查副本是否独立,以及恢复符号是否与删除、循环同步混淆。需要完整展示“原数据→备份→恢复目标”时,再制作可编辑的结构图。 ### 海边亲子活动配图 分类为“生活旅行”,标签为“海边、亲子、周末”,用途是社交媒体活动配图。成人与儿童共同参与的动作,比单独的海边装饰更能说明亲子关系。 ```text 海边亲子活动的手绘插画。一名成人与一名儿童在平缓的沙滩上一起观察贝壳, 动作自然,人物关系清楚,背景保留简化的海面与天空。 轻水彩质感,清晰柔和的轮廓,浅蓝与沙色为主,温暖轻松的氛围。 主体位于画面下半部,上方留出后续添加活动标题的空间。 ``` 换成课程封面时,可以保留海边与亲子主题,将主体改为观察动作或知识对象的特写。用于真实活动的时间、地点与参与条件,按实际资料另行排版。 ### 阅读台灯概念图 分类为“产品设计”,标签为“台灯、金属、阅读”,用途是讨论虚构台灯的外形与材质。 ```text 一盏用于阅读场景的虚构台灯概念图,简洁金属灯臂与圆形灯罩, 放置在整洁书桌的一侧,书本作为尺度与使用情境的辅助对象。 摄影感三维表达,磨砂金属材质,柔和定向光照,背景简洁, 从斜前方展示整体轮廓,主体边缘清楚,细节集中在灯罩与连接部位。 ``` 概念图用于讨论设计方向,不能作为实物照片、尺寸或性能证据。已有产品的展示图应以真实资料和参考图为基础,核对外观与结构。 ## 保持系列图片的风格一致 系列图片可以先固定媒介、线条、配色和留白习惯,再按每张图的主题调整主体与关系。 | 层次 | 固定或调整的内容 | | --- | --- | | 系列视觉约定 | 主要媒介、线条特征、色彩范围、材质倾向、留白习惯 | | 单张图片内容 | 主体、动作、场景、重点关系,以及与用途有关的构图变化 | 例如数据库、网络和存储课程可以采用相近的插画语言,分别用对应的对象表达主题。这样既有统一的视觉特征,也保留了各自的内容重点。 需要更明确的观感时,可以使用工具支持的风格参考。Midjourney将Style Reference用于色彩、媒介、纹理、光照等特征;人物身份、产品外形和构图还需要分别提出要求,并核对相应功能。[参考:Midjourney Style Reference](https://docs.midjourney.com/hc/en-us/articles/32180011136653-Style-Reference) ## 生成后的检查与记录 选择少量候选方向,在同一任务下逐步调整,比较起来更容易定位问题。 1. 固定主题、主体和用途,比较两种候选媒介。 2. 确定媒介后,调整色彩、构图或材质中的一个主要因素。 3. 同时查看完整图片和实际使用尺寸,检查缩小或裁切后的效果。 4. 记录工具、模型版本、输入、参考图、设置及选择理由。 Google的提示词指南建议围绕核心想法逐步调整描述。生成结果还会受到随机变化影响,单次满意的输出不代表同一提示词每次都能复现。[参考:Imagen迭代提示词说明](https://docs.cloud.google.com/vertex-ai/generative-ai/docs/image/img-gen-prompt-guide) | 检查维度 | 检查内容 | | --- | --- | | 内容对应 | 主要主题是否可辨,关键对象是否遗漏或混淆 | | 任务适配 | 是否服务于演示、说明、活动传播或概念讨论 | | 视觉协调 | 线条、材质、色彩是否符合系列要求 | | 事实与结构 | 数量、动作、产品细节和技术关系是否正确 | | 后续使用 | 是否方便裁切、缩小、配文和修改 | 记录可以采用下面这样的短表单,在实际生成后补齐工具与结果信息: ```yaml # 原创任务记录示例;尚未执行生成。 内容分类: 技术知识 标签: [数据库, 备份, 恢复] 用途: 演示页主题插图 核心信息: 备份副本与恢复的联系 候选风格: 扁平插画 视觉约定: 圆润形体、细描边、低饱和配色 构图要求: 主体居右,左侧预留文案空间 工具与模型版本: 实际执行时填写 提示词与参考输入: 实际执行时保存 结果与选择理由: 待生成后记录 ``` 下方风格库用于查找候选画风。选定风格后,将提示词中的`{主体}`替换成具体对象,再补充动作、场景、用途与构图;用实际结果检查这些描述是否清楚。 ## 82种风格与原创提示词速查 **82种风格,7个分类。**按中文名、英文名或提示词查找方向,选定后复制本文原创中文提示词,将 `{主体}` 替换成自己的对象。 风格英文名称与顺序参考[Workation Lab](https://workationlab.com/ai-image-style-library),中文显示名、提示词与示例图另行制作。示例统一使用小橙狐狸、白陶瓷杯与盆栽。 配图由AI按组联合生成后拆分为82张独立图片,不等同逐条提示词的独立复现结果;摄影与工艺类不代表实拍或实物。点击风格名称可同时收起图片与提示词。 搜索风格 全部 · 82 插画与绘画 · 12 角色与卡通 · 10 三维与材质 · 12 数字与未来 · 13 平面与印刷 · 12 氛围与流派 · 13 摄影与镜头 · 10 显示82种风格 展开当前结果收起当前结果重置筛选 没有匹配的风格,试试其他关键词或重置筛选。 **涂鸦速写**Sketch Doodle#01  AI生成示例 把{主体}画成随手记录的涂鸦,轮廓留有反复勾画的痕迹,旁边点缀少量箭头与小符号,保留纸面空白。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/01-sketch-doodle.png) **扁平插画**Flat Illustration#02  AI生成示例 用清楚的色块概括{主体},删去表面纹理,以前后形状的重叠表达空间,让画面在缩小时仍能看清主体。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/02-flat-illustration.png) **极简线稿**Minimal Line Art#03  AI生成示例 以少量连续细线描出{主体}的主要结构,减少内部装饰,让轮廓与大面积留白形成视觉重心。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/03-minimal-line-art.png) **水彩绘画**Watercolor#04  AI生成示例 先用淡色铺出{主体},让局部水色在纸面自然晕开,重点部位叠加较深颜色,背景保持轻盈。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/04-watercolor.png) **粉彩蜡笔**Pastel Crayon#05  AI生成示例 用柔软蜡笔描绘{主体},让色块边缘带有颗粒和擦过纸面的痕迹,以朴拙形状组织画面。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/05-pastel-crayon.png) **彩色铅笔**Colored Pencil#06  AI生成示例 以交错的彩色铅笔笔触塑造{主体},亮部保留纸张本色,暗部用多层轻涂积累,细节集中在视觉重点。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/06-colored-pencil.png) **油彩绘画**Oil Painting#07  AI生成示例 让{主体}具有油画的厚重感,用可见的颜料笔触塑造转折,明暗色层互相衔接,背景适度概括。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/07-oil-painting.png) **丙烯绘画**Acrylic Painting#08  AI生成示例 以不透明颜料描绘{主体},色块交界明确,局部留下刮擦和叠涂的肌理,整体保持鲜明的画面节奏。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/08-acrylic-painting.png) **水墨写意**Ink Wash#09  AI生成示例 用墨色的浓淡干湿描写{主体},结构重点用较实笔触,边缘逐渐散开,让空白参与空间表达。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/09-ink-wash.png) **木刻版画**Woodcut#10  AI生成示例 将{主体}处理成木版印制的图像,以刻痕组织亮部,以大片实色承托轮廓,保留手工刀法的方向感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/10-woodcut.png) **孔版印刷**Risograph#11  AI生成示例 将{主体}分成少量专色印层,层与层之间轻微错位,纸面带有细颗粒,色块交叠处出现新的色调。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/11-risograph.png) **点彩绘画**Pointillism#12  AI生成示例 用密集的小色点组织{主体},靠点的疏密与颜色变化塑造体积,远看形成完整轮廓,近看保留点状笔触。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/12-pointillism.png) **日系动画**Anime#13  AI生成示例 将{主体}表现为日系动画设定图,轮廓干净,明暗分区清楚,姿态或形体具有明确的叙事焦点。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/13-anime.png) **Q版角色**Chibi Cute#14  AI生成示例 把{主体}转成小巧可爱的Q版形象,放大最有辨识度的特征,压缩次要结构,用简单动作突出性格。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/14-chibi-cute.png) **模切贴纸**Sticker#15  AI生成示例 将{主体}设计为一枚可独立使用的贴纸,外缘留出均匀裁切边,内部造型清楚,背景保持简洁。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/15-sticker.png) **儿童绘本**Children’s Book#16  AI生成示例 围绕{主体}绘制儿童绘本画面,用容易理解的形状与温和配色组织情节,让动作关系一眼可读。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/16-children-s-book.png) **美式漫画**American Comic#17  AI生成示例 以美式漫画的分镜感呈现{主体},加强黑色轮廓与动作方向,用集中阴影突出画面中的关键瞬间。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/17-american-comic.png) **复古漫画**Retro Comic#18  AI生成示例 将{主体}放进旧式漫画印页,使用有限的印刷色与网点明暗,边缘带轻微旧纸质感,重点轮廓保持清晰。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/18-retro-comic.png) **橡皮管动画**Rubber Hose#19  AI生成示例 把{主体}转成早期橡皮管动画形象,以富有弹性的曲线表现肢体或结构,动作夸张,黑白块面鲜明。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/19-rubber-hose.png) **吉祥物角色**Mascot Character#20  AI生成示例 根据{主体}最醒目的特征设计吉祥物,先建立容易辨认的外轮廓,再用少量表情和配件传达角色性格。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/20-mascot-character.png) **趣味表情插画**Meme Illustration#21  AI生成示例 用一个夸张反应呈现{主体},将表情或动作作为笑点,减少无关背景,文案位置留给后续排版。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/21-meme-illustration.png) **四格漫画**4-Panel Comic#22  AI生成示例 围绕{主体}安排四格小故事,依次展示起因、变化、意外和收束,保持造型可辨,让每格承担一个动作。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/22-4-panel-comic.png) **三维公仔**3D Figure#23  AI生成示例 将{主体}做成可收藏的小型三维摆件,突出主要轮廓和底座关系,以柔和展示光表现可触摸的体积。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/23-3d-figure.png) **黏土定格**Clay Stop Motion#24  AI生成示例 用手捏黏土的方式塑造{主体},边缘略有不规则起伏,接合处保留手工痕迹,画面像定格动画的一帧。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/24-clay-stop-motion.png) **羊毛毡**Felt Style#25  AI生成示例 让{主体}呈现针毡制作的柔软外观,边缘露出细纤维,以蓬松的体块代替坚硬转折,背景衬托手工感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/25-felt-style.png) **立体纸雕**Paper Cut 3D#26  AI生成示例 将{主体}拆成前后几层纸片,层间通过投影区分距离,切边清楚,主要形状以正面或轻微侧视展示。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/26-paper-cut-3d.png) **低多边形**Low Poly#27  AI生成示例 用较少的多边形块面重建{主体},通过平面朝向的明暗差表达体积,保留醒目的轮廓与简化的细节。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/27-low-poly.png) **积木玩具**Brick Toy#28  AI生成示例 把{主体}搭成积木玩具模型,让连接颗粒和模块划分可见,以桌面微缩场景展示拼搭结构。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/28-brick-toy.png) **拼豆手作**Perler Bead#29  AI生成示例 将{主体}转换成拼豆手工作品,形状沿规则网格排列,圆豆边缘略可辨,保留有限颜色和手工摆放感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/29-perler-bead.png) **马赛克拼贴**Mosaic#30  AI生成示例 用不同大小的彩色小片拼出{主体},片间保留细缝,靠碎片方向与色彩分区描绘轮廓和明暗。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/30-mosaic.png) **宝石镶嵌**Jeweled Mosaic#31  AI生成示例 将{主体}做成宝石镶嵌图案,以不同形状的亮面颗粒形成主体轮廓,金属分隔线连接细节,反光集中有序。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/31-jeweled-mosaic.png) **金属浮雕**Metal Relief#32  AI生成示例 把{主体}压印在金属板上,用高低起伏表现造型,边缘呈现细密雕纹,斜侧光突出浮雕深度。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/32-metal-relief.png) **毛线钩织**Crochet#33  AI生成示例 将{主体}设计为钩织毛线制品,让线圈方向顺着形体变化,拼接部位可见,整体像柔软的手工小摆件。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/33-crochet.png) **陶瓷摆件**Ceramic Figure#34  AI生成示例 用陶瓷摆件的方式表现{主体},形体饱满,釉面反光沿曲面移动,底部与桌面的接触关系清楚。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/34-ceramic-figure.png) **像素绘画**Pixel Art#35  AI生成示例 以清晰像素格绘制{主体},先保证小尺寸轮廓可辨,再用有限色阶补充体积,让边缘保持像素节奏。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/35-pixel-art.png) **8位游戏**8-bit Game#36  AI生成示例 将{主体}转成早期8位游戏图形,使用粗颗粒轮廓和较少色彩,以直接的明暗对比表达关键特征。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/36-8-bit-game.png) **16位游戏**16-bit Game#37  AI生成示例 为{主体}设计16位游戏场景或精灵,保留像素轮廓,在局部增加渐层和环境细节,形成较丰富的层次。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/37-16-bit-game.png) **蒸汽波**Vaporwave#38  AI生成示例 将{主体}放在带有旧数字媒介气息的空间里,用粉紫与青色组织画面,加入空旷透视和轻微失真的怀旧感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/38-vaporwave.png) **千禧数码**Cyber Y2K#39  AI生成示例 让{主体}呈现千禧年前后的数码未来想象,结合半透明塑料、反光饰面与圆滑界面形状,构图利落。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/39-cyber-y2k.png) **赛博朋克**Cyberpunk#40  AI生成示例 围绕{主体}构建高密度未来都市,技术设施与生活痕迹并置,局部灯光穿过潮湿空气,空间层次清楚。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/40-cyberpunk.png) **合成器浪潮**Synthwave#41  AI生成示例 将{主体}置于复古电子音乐视觉中,以紫蓝色空间、明亮地平线和规则几何节奏组织画面。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/41-synthwave.png) **霓虹发光**Neon Glow#42  AI生成示例 用局部发光线条强调{主体}的主要边缘,让光晕只集中在视觉重点,其余区域保持较暗且简洁。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/42-neon-glow.png) **全息投影**Holographic#43  AI生成示例 将{主体}表现为悬浮的全息影像,轮廓带透明叠层与色散,少量扫描纹理帮助区分实体背景和投影。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/43-holographic.png) **故障艺术**Glitch Art#44  AI生成示例 让{主体}的局部轮廓出现错层、色道偏移与断裂片段,保留核心形象可辨,让故障集中在指定区域。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/44-glitch-art.png) **液态金属**Liquid Metal#45  AI生成示例 用流动的镜面金属重塑{主体},曲面连续,反射随弯曲变化,背景用简单色面衬托金属的流动轮廓。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/45-liquid-metal.png) **科幻蓝图**Sci-Fi Blueprint#46  AI生成示例 把{主体}表现为概念蓝图,按主要部件分区,用细线与辅助视图说明结构,精确标注在后续编辑中加入。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/46-sci-fi-blueprint.png) **等角视图**Isometric#47  AI生成示例 以等角视角展示{主体},平行方向保持一致,将主要模块分层安排,让物件之间的空间关系容易阅读。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/47-isometric.png) **剪影海报**Silhouette Poster#48  AI生成示例 将{主体}压缩为醒目的剪影,以背景与轮廓的对比建立主题,保留一个最重要的动作或外形特征。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/48-silhouette-poster.png) **旅行明信片**Travel Postcard#49  AI生成示例 围绕{主体}设计旅行明信片画面,用有辨识度的景物建立地点印象,色调略带旧印刷感,留出寄语区域。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/49-travel-postcard.png) **复古海报**Vintage Poster#50  AI生成示例 把{主体}处理为复古海报的视觉中心,以少量大色块组织前后层次,保留醒目的标题空间与印刷颗粒。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/50-vintage-poster.png) **瑞士国际风格**Swiss Style#51  AI生成示例 以瑞士国际风格组织{主体}相关视觉,采用清楚网格与非对称留白,图像和文字区域各有明确对齐关系。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/51-swiss-style.png) **包豪斯**Bauhaus#52  AI生成示例 用圆、矩形与直线概括{主体},通过基础色块和有秩序的组合表达主题,让结构本身成为视觉重点。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/52-bauhaus.png) **孟菲斯**Memphis#53  AI生成示例 围绕{主体}加入活泼的几何图案,曲线、斜线与小色块交错排列,在秩序中制造跳跃的装饰节奏。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/53-memphis.png) **粗粝平面**Brutalist#54  AI生成示例 让{主体}置于粗粝直率的平面版式中,使用强烈块面和明显对齐差异,保留未经抛光的材料或印刷感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/54-brutalist.png) **报纸编辑**Newspaper Editorial#55  AI生成示例 用报纸编辑版面的方式安排{主体},图像采用适合黑白印刷的层次,周围预留分栏、标题和说明文字区域。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/55-newspaper-editorial.png) **杂志专题**Editorial Magazine#56  AI生成示例 将{主体}作为杂志专题的主视觉,安排清楚的图文层级与充足留白,用精简配色保持页面整体感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/56-editorial-magazine.png) **丝网印刷**Screen Print#57  AI生成示例 把{主体}转换成丝网印刷图案,颜色分层平铺,局部保留油墨覆盖与套色边缘,主体轮廓保持有力。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/57-screen-print.png) **纸片拼贴**Collage#58  AI生成示例 用剪裁纸片、照片碎片和色纸重组{主体},通过重叠与切边形成层次,让素材之间保留可见的拼贴关系。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/58-collage.png) **贴纸拼贴**Sticker Bomb#59  AI生成示例 围绕{主体}组合多枚涂鸦贴纸,保留不同裁切轮廓和覆盖顺序,视觉重心明确,密集处与空白区交替出现。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/59-sticker-bomb.png) **黑板粉笔**Chalkboard#60  AI生成示例 用粉笔在深色板面上描绘{主体},线条带擦拭和粉尘痕迹,用简单轮廓与少量强调色组织说明。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/60-chalkboard.png) **黑白极简**Monochrome Minimal#61  AI生成示例 仅用黑、白与少量灰阶表达{主体},让轮廓、明暗和空白承担层次,减少装饰并保留清楚的视觉焦点。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/61-monochrome-minimal.png) **奶油暖居**Creamy Cozy#62  AI生成示例 将{主体}放在温和的浅色空间中,以奶油色、圆润转折和漫射光建立放松气氛,材质细节适度保留。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/62-creamy-cozy.png) **糖果配色**Candy Color#63  AI生成示例 用明快的糖果色表现{主体},局部采用圆润高光,背景与主体的颜色彼此区分,画面轻巧而有活力。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/63-candy-color.png) **梦核氛围**Dreamcore#64  AI生成示例 将{主体}置于带有童年记忆感的梦境空间,尺度和距离略显不合常理,光线柔软,画面保持安静的悬浮感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/64-dreamcore.png) **怪核氛围**Weirdcore#65  AI生成示例 让{主体}出现在熟悉却略有错位的场景中,保留低清晰度媒介痕迹,以不协调的尺度或位置制造异样感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/65-weirdcore.png) **暗黑学院**Dark Academia#66  AI生成示例 围绕{主体}安排旧书、深色木质或古典空间线索,以克制的暖暗色调突出沉静、专注的学习氛围。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/66-dark-academia.png) **童话幻想**Storybook Fantasy#67  AI生成示例 将{主体}放进童话式场景,以柔软形体和有叙事意味的小细节组织画面,让环境与主体产生温和互动。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/67-storybook-fantasy.png) **奇幻角色扮演**Fantasy RPG#68  AI生成示例 把{主体}作为奇幻角色或场景的核心,明确能力、装备或环境线索,以前景到远景的层次支持冒险叙事。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/68-fantasy-rpg.png) **蒸汽朋克**Steampunk#69  AI生成示例 为{主体}加入蒸汽机械设定,让管道、阀门和手工加工部件围绕功能组织,使用偏暖的金属与灯光表现时代感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/69-steampunk.png) **柴油朋克**Dieselpunk#70  AI生成示例 将{主体}置于重工业与复古未来并存的环境,采用结实机械轮廓、使用痕迹和偏冷金属色,强调重量感。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/70-dieselpunk.png) **原子朋克**Atompunk#71  AI生成示例 用20世纪中叶设计中的未来想象重塑{主体},采用圆弧外形、轨道符号与乐观的明亮配色,形成复古科幻气质。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/71-atompunk.png) **太阳朋克**Solarpunk#72  AI生成示例 让{主体}与绿植、清洁能源和可步行空间协同出现,以自然采光和宜居尺度表达积极的生态未来想象。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/72-solarpunk.png) **电影剧照感**Cinematic Still#73  AI生成示例 将{主体}安排在一个叙事瞬间中,选择明确的取景范围与焦点位置,让环境细节、光线方向共同交代情境。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/73-cinematic-still.png) **产品棚拍感**Studio Product#74  AI生成示例 为{主体}设计棚拍式展示图,以可控灯面突出外形和表面质感,背景简洁,接触阴影帮助说明物体体积。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/74-studio-product.png) **35毫米胶片感**35mm Film#75  AI生成示例 将{主体}表现为35毫米底片拍摄的画面,保留自然颗粒与适度色偏,构图像一次被及时记录的日常观察。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/75-35mm-film.png) **即时成像感**Polaroid#76  AI生成示例 为{主体}制作即时成像相片的视觉效果,保留相纸边框、柔和层次与略显不均的显色,让画面像随手保存的片段。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/76-polaroid.png) **鱼眼视角**Fisheye#77  AI生成示例 用鱼眼视角观察{主体},让靠近镜头的部分明显放大,边缘空间呈弯曲透视,视觉重点靠近画面中心。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/77-fisheye.png) **微距特写**Macro Photography#78  AI生成示例 以近距离特写表现{主体}的局部结构,将焦点放在一小片纹理上,背景逐渐虚化,让尺度感来自细节。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/78-macro-photography.png) **时尚专题**Fashion Editorial#79  AI生成示例 将{主体}作为时尚专题的核心,姿态、服装或物件摆放经过明确设计,光线与背景共同建立鲜明的视觉态度。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/79-fashion-editorial.png) **街头纪实感**Street Documentary#80  AI生成示例 把{主体}放在真实生活感的街道场景中,以观察者视角捕捉自然动作,保留环境信息和不过度修饰的光线。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/80-street-documentary.png) **高调商业视觉**High-Key Commercial#81  AI生成示例 用明亮均匀的展示光表现{主体},背景接近浅色,保留细部轮廓和必要阴影,呈现轻盈清洁的商业视觉。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/81-high-key-commercial.png) **低调电影光影**Low-Key Cinematic#82  AI生成示例 让{主体}大部分处于暗部,只用局部光照刻画关键轮廓与材质,借有限亮面建立画面焦点和叙事情绪。 复制提示词[查看单图 ↗](https://img.iowill.com/file/软件与工具/AiImageStylePrompts/styles/82-low-key-cinematic.png) ## 参考资料 资料核对日期:2026年11月7日。Workation Lab提供选题与布局灵感;官方文档分别支持相应工具的说明。本文未进行跨模型效果对比。 1. [Workation Lab:AI Image Style Library](https://workationlab.com/ai-image-style-library):风格发现与选题灵感。 2. [Google Cloud:Prompt and image attribute guide](https://docs.cloud.google.com/vertex-ai/generative-ai/docs/image/img-gen-prompt-guide):主体、语境、风格与迭代描述。 3. [Midjourney:Prompt Basics](https://docs.midjourney.com/hc/en-us/articles/32023408776205-Prompt-Basics):主体、媒介、光照、色彩和构图等描述维度。 4. [Adobe Firefly:Writing effective text prompts](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/writing-effective-text-prompts.html):具体、直接的提示词表达。 5. [Adobe Firefly:Match image composition to reference image](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/match-image-composition-to-reference-image.html):构图与结构参考。 6. [Adobe Firefly:Reference images for styling](https://helpx.adobe.com/firefly/web/work-with-images/generate-images/reference-images-for-styling.html):风格参考的用途。 7. [Midjourney:Style Reference](https://docs.midjourney.com/hc/en-us/articles/32180011136653-Style-Reference):风格参考与主体要求的区分。 --- --- title: "Chrome WebRTC 防泄露测试:用本地 STUN 验证网络策略" source: https://www.iowill.com/blog/2026/11/chrome-webrtc-stun-policy-validation/ date: 2026-11-09 updated: 2026-11-09 tags: [Chromium, Playwright, WebRTC, 网络隐私, 软件测试] categories: [编程开发] --- # Chrome WebRTC 防泄露测试:用本地 STUN 验证网络策略 **验证 WebRTC 网络策略,需要让页面具备创建连接的能力,再同时观察 STUN 服务端收到的数据报与页面产生的 ICE 候选。** 如果先把 `RTCPeerConnection` 禁用了,之后没有数据包,只能说明没有发生这次连接,不能据此证明底层网络策略生效。 本文给出只在本机运行的教学实验,通过“关闭—开启—再次关闭”建立对照。2026年11月6日,在 Windows、Playwright 1.60.0、完整 Chrome **155.0.8059.85 的无头模式**下,三次实验的 STUN Binding 请求数为 **1、0、1**,测试映射候选也依次出现、消失、恢复。 这些结果只支持该浏览器版本、本地 STUN 路径和观察窗口的结论,不是匿名性认证,也不证明所有站点、企业策略或执行环境中的地址获取方式均被覆盖。旧文[WebRTC 泄漏机制与排查](https://www.iowill.com/blog/2026/10/webrtc-ip-leak/)已经解释了基础概念,本篇集中讨论怎样取得可核验的实验依据。 文中的 dyDM 案例对应固定开发源码,不表示正式安装包已经交付相同能力。下方独立实验直接启动指定 Chrome,并未通过 dyDM 的完整业务启动链路;本地实验结果与私有项目整体验收分别记录。 ## 网络策略与页面接口限制应分别验收 网络策略影响浏览器尝试使用哪些连接路径;页面接口限制影响页面是否能创建相关对象。两个控制层可以配合,但不应互相冒充验证证据。 | 测试目的 | 保持什么条件 | 主要观察 | | --- | --- | --- | | 网络策略是否改变测试路径 | 页面 API 可用,仅切换网络策略 | STUN 收包、候选类型与收集结束 | | 页面 API 限制是否生效 | 独立配置初始化脚本 | 页面第一个脚本看到的对象 | | 组合运行与兼容性 | 明确记录两层配置 | 目标任务是否完成、哪些功能受限 | [RFC 8828](https://www.rfc-editor.org/rfc/rfc8828.html)讨论 WebRTC 的 IP 地址处理要求,可用于理解策略的目标;浏览器具体接口和行为仍需结合实现验证。Chrome 的隐私 API 文档列有 `disable_non_proxied_udp` 这一策略值,但不能由某个参数字符串出现在启动列表,就推断所有 Chromium 产品均采用了它。[Chrome privacy 文档](https://developer.chrome.com/docs/extensions/reference/api/privacy#type-IPHandlingPolicy)  *图1:原创分层验证示意,未表示所有页面环境都已覆盖。* ## STUN 测试映射地址不是真实公网 IP ICE 收集候选并检查可用路径,STUN 是其使用的工具之一。通过 STUN 获得的 server-reflexive 候选,通常简称 `srflx`,与本地接口相关的 `host` 候选、中继候选不同。[RFC 8445](https://www.rfc-editor.org/rfc/rfc8445.html)、[RFC 8489](https://www.rfc-editor.org/rfc/rfc8489.html) 为了让实验不依赖公网服务,下面的响应器绑定 `127.0.0.1`,收到 Binding 请求后,返回固定的 `203.0.113.42` 作为测试映射地址。它属于[RFC 5737的文档地址段](https://www.rfc-editor.org/rfc/rfc5737.html),**不是本次测出的公网出口**,也不代表这条候选能够建立真实公网通信。 响应器只实现本实验需要的回复,不是完整 STUN 服务端。把一个可辨识结果返回给浏览器,目的是检查请求与候选生成这条链路是否发生。 STUN 成功响应需要沿用请求的事务 ID,并按 XOR-MAPPED-ADDRESS 的格式编码地址和端口。随便返回一个 IP 文本,不能用来判断浏览器是否正确收到了 STUN 响应。示例实现依据 RFC 8489 的报文与属性格式,没有将它宣称为协议一致性测试套件。 ## 用关—开—关排除无效对照 只有“开启后没收到包”,证据不充分:浏览器可能未创建连接、响应器可能没启动、采集过程也可能提前结束。 三次测试都使用新的浏览器进程和临时 Context,API 屏蔽始终关闭,只切换网络启动参数: | 阶段 | 网络策略 | 预期检查 | | --- | --- | --- | | 第一次 | 关闭 | 收到请求,产生固定测试映射的 srflx 候选 | | 第二次 | 开启 | 在观察窗口内没有新增请求,也没有测试映射候选 | | 第三次 | 再次关闭 | 请求与候选恢复,确认测试链路仍然正常 | 等待以 ICE 收集结束或最长四秒为边界。四秒不是网络世界的通用安全阈值,只是这个本地、可立即响应的夹具设置。实验若不能建立正向对照,应先报告对照失败,而不是把全程零包当作防护成功。  *图2:原创实验设计示意。实际结果见下方版本和观察表。* ## 可独立运行的本地实验 在独立目录保存下方完整代码为 `probe.py`。需要 Python 3.10 及以上、Playwright,以及本机已安装的完整 Chrome: ```bash python -m pip install playwright==1.60.0 python probe.py ``` 脚本使用 `channel="chrome"`,不会自动下载或替换本机 Chrome。没有安装该浏览器时应先处理环境;直接把 channel 改成测试 Chromium,得到的是另一个环境的结果,需要单独记录。此脚本不读取账号目录、Cookie 或真实代理配置。 ```python """Original loopback-only STUN teaching experiment; not an Internet STUN server.""" import importlib.metadata import ipaddress import json import platform from pathlib import Path import socket import struct import threading from playwright.sync_api import sync_playwright COOKIE=0x2112A442 TEST_IP='203.0.113.42' SCRIPT='''async (port) => { const pc = new RTCPeerConnection({iceServers:[{urls:`stun:127.0.0.1:${port}`} ]}); const candidates=[]; try { const finished=new Promise(resolve => { pc.onicecandidate=e => { if(e.candidate)candidates.push({type:e.candidate.type,address:e.candidate.address}); }; pc.onicegatheringstatechange=()=> {if(pc.iceGatheringState==='complete')resolve();}; setTimeout(resolve,4000); }); pc.createDataChannel('test'); await pc.setLocalDescription(await pc.createOffer()); await finished; return {state:pc.iceGatheringState,types:candidates.map(c=>c.type),hasTestMapping:candidates.some(c=>c.type==='srflx' && c.address==='203.0.113.42')}; } finally {pc.close();} }''' def run(): stop=threading.Event();count=[0];lock=threading.Lock() sock=socket.socket(socket.AF_INET,socket.SOCK_DGRAM);sock.bind(('127.0.0.1',0));sock.settimeout(.1) port=sock.getsockname()[1] def serve(): while not stop.is_set(): try:data,peer=sock.recvfrom(4096) except socket.timeout:continue if len(data)<20:continue kind,length,cookie,transaction=struct.unpack('!HHI12s',data[:20]) if kind!=1 or cookie!=COOKIE or len(data)<20+length:continue with lock:count[0]+=1 attribute=struct.pack('!HHBBHI',0x20,8,0,1,peer[1]^(COOKIE>>16),int(ipaddress.IPv4Address(TEST_IP))^COOKIE) sock.sendto(struct.pack('!HHI12s',0x101,len(attribute),COOKIE,transaction)+attribute,peer) thread=threading.Thread(target=serve);thread.start() results=[] try: with sync_playwright() as pw: for enabled in (False,True,False): args=['--disable-background-networking'] if enabled:args+=['--webrtc-ip-handling-policy=disable_non_proxied_udp','--force-webrtc-ip-handling-policy=disable_non_proxied_udp'] browser=pw.chromium.launch(channel='chrome',headless=True,args=args) try: context=browser.new_context();page=context.new_page() with lock:before=count[0] observed=page.evaluate(SCRIPT,port) with lock:received=count[0]-before item={'network_policy':enabled,'headless':True,'browser':browser.version,'stun_requests':received,**observed} results.append(item) if enabled:assert received==0 and not observed['hasTestMapping'],item else:assert received>0 and observed['hasTestMapping'],item finally:browser.close() browser=pw.chromium.launch(channel='chrome',headless=True) try: context=browser.new_context() context.add_init_script("Object.defineProperty(window,'RTCPeerConnection',{value:undefined,configurable:false,writable:false});") page=context.new_page();page.goto('data:text/html,') assert page.evaluate('window.firstObservation')=='undefined' finally:browser.close() finally: stop.set();thread.join(timeout=2);sock.close() record={'python_environment':platform.system()+' local host; loopback UDP only; no account or Internet STUN','python':platform.python_version(),'playwright':importlib.metadata.version('playwright'),'browser_channel':'chrome','trials':results,'page_api_first_script':'undefined','scope':'One headless Chrome build; artificial TEST-NET mapping; not an anonymity or all-site protection claim'} Path(__file__).with_name('verification-results.json').write_text(json.dumps(record,ensure_ascii=False,indent=2)+'\n',encoding='utf-8',newline='\n') print(json.dumps(record,ensure_ascii=False,indent=2)) if __name__=='__main__':run() ``` 程序将结果写入同目录的 `verification-results.json`。服务端只绑定回环地址,结束时停止线程并关闭 socket;输出仅保留候选类型与是否出现文档测试映射,不保存本地接口地址列表。 本次实际运行结果如下。三次均完成 ICE 收集,没有依靠超时把尚未结束的过程当作成功: | Chrome 155.0.8059.85,无头模式 | STUN 请求数 | 候选类型 | 固定测试映射 | | --- | --- | --- | --- | | 策略关闭 | 1 | host、srflx | 出现 | | 策略开启 | 0 | 无 | 未出现 | | 策略再次关闭 | 1 | host、srflx | 恢复 | 表格是本次运行记录,不是建议值或模拟指标。响应器返回的是人工地址,因此不能把表格写成真实公网 IP 泄漏与修复测试。 ## 页面 API 限制验证的是另一个结果 示例末尾还独立检查了页面首次脚本:通过 `BrowserContext.add_init_script()`,在文档脚本运行前限制 `RTCPeerConnection`,页面保存的首次观察结果为 `undefined`。 [Playwright 初始化脚本文档](https://playwright.dev/python/docs/api/class-browsercontext#browser-context-add-init-script)说明了相应生命周期。注册初始化脚本与事后在开发者工具修改全局对象不同;已经运行的脚本可能保留旧引用。 这个附加用例只验证示例数据页面的首次脚本,不代表本次已测试跨源 iframe、popup、Worker、扩展脚本或任意 CSP。真实应用如果依赖这些路径,需要分别设置可观察断言;不能把方法调用成功当作覆盖清单已经完成。 对象限制也有兼容性成本。视频会议、设备采集、直播连麦等正常功能可能受影响,`mediaDevices` 等额外限制尤其需要按用途选择。策略关闭后,已经安装进旧页面的属性限制也不一定可撤销,重新创建浏览器是更清楚的生效边界。 ## 完整 Chrome 与测试内核需要分别记录 个人项目的历史开发资料记录过一种反例:测试内核中的结果符合预期,完整 Chrome 的 STUN 验证却未通过。当前私有源码基线 `56e25be7f9792a4245f343408bbb061df59bbf7e` 保留了以下两个启动参数: ```text --webrtc-ip-handling-policy=disable_non_proxied_udp --force-webrtc-ip-handling-policy=disable_non_proxied_udp ``` 本文本次实测也使用这一组合,但没有分别测量两个参数各自的贡献,不能从组合成功推导两个参数单独都必需或都有效。它们不是本文承诺所有浏览器长期支持的稳定公共接口;版本升级后应复测实际行为。 同样,`disable_non_proxied_udp` 不会把一个只支持 TCP 的本地代理变成 UDP 转发器。没有实现 UDP ASSOCIATE 或其他 UDP 传输,就不能宣传为“所有 WebRTC 流量已经通过当前 SOCKS5 代理”。 ## 结果能支持哪些结论 本次实验支持的结论是:在记录的完整 Chrome 无头版本中,指定参数组合改变了本地 STUN 测试路径,关闭后能恢复;附加页面用例中,初始化脚本在首次脚本前限制了指定对象。 它没有检查有窗口模式、所有浏览器产品、真实上游代理、远端 STUN/TURN、企业管理策略、实际业务账号或全部 JavaScript 环境。也没有用一次运行证明长期稳定性。 当 IP 检测页仍显示非预期地址时,应继续核对页面实际调用的接口域名、代理规则和当前运行快照。网络检测接口直连、旧配置仍被使用、上游自身分流,都可能造成类似表象;“IP 不对”不是 WebRTC 问题的充分证据。 ## 参考资料 资料核对与本地实验日期为2026年11月6日。私有项目历史反例与本次原创夹具结果分别叙述;本篇不复现其全部内部测试。 1. [RFC 8828:WebRTC IP Address Handling Requirements](https://www.rfc-editor.org/rfc/rfc8828.html),地址处理目标和策略背景。 2. [RFC 8445:ICE](https://www.rfc-editor.org/rfc/rfc8445.html),候选与连通性检查。 3. [RFC 8489:STUN](https://www.rfc-editor.org/rfc/rfc8489.html),Binding报文和映射地址属性。 4. [Chrome:privacy API](https://developer.chrome.com/docs/extensions/reference/api/privacy#type-IPHandlingPolicy),IP handling策略值。 5. [Playwright:BrowserContext.add\_init\_script](https://playwright.dev/python/docs/api/class-browsercontext#browser-context-add-init-script),初始化脚本时机。 6. [Playwright:Browsers](https://playwright.dev/python/docs/browsers),配套浏览器与品牌浏览器的运行选择。 7. [RFC 5737:文档示例IPv4地址](https://www.rfc-editor.org/rfc/rfc5737.html),人工映射地址的性质。 --- --- title: "Python 配置管理实践:原子写入、并发冲突与运行快照" source: https://www.iowill.com/blog/2026/11/python-config-atomic-conflicts-snapshots/ date: 2026-11-08 updated: 2026-11-08 tags: [Python, 并发编程, 软件测试, 配置管理] categories: [编程开发] --- # Python 配置管理实践:原子写入、并发冲突与运行快照 **原子替换可以避免读者看到一份写到一半的配置,却不能阻止旧草稿完整地覆盖新配置。** 解决丢失更新,需要把读取最新值、比较基线、合并修改与写入作为一个受协调的过程。配置保存成功后,运行中的任务是否采用新值,则是另一项需要明确设计的行为。 桌面程序里,这些问题经常同时出现:两个窗口都打开设置,一个修改代理规则,另一个更新账号资料;浏览器任务又在后台使用旧配置。只给 JSON 写入加一个临时文件,无法同时解决这些状态之间的关系。 本文用个人项目的路由设置解释设计取舍,源码阅读基线为 `56e25be7f9792a4245f343408bbb061df59bbf7e`。可运行代码是独立原创教学示例,不读取项目真实配置,也不是完整的跨进程配置数据库。 案例对应开发源码中的特定保存路径,不代表正式安装包已经交付全部能力,也不代表应用所有配置写入都已使用同一事务约定。 ## 配置完整、更新正确与运行生效分别检查 | 问题 | 典型故障 | 对应的处理方向 | | --- | --- | --- | | 文件完整性 | 程序退出时文件只写了一半 | 同目录临时文件、刷新及替换 | | 更新一致性 | 后保存的旧窗口抹掉前一次修改 | 局部更新、基线比较与并发协调 | | 运行生效 | 磁盘值改变,旧任务仍使用原值 | 快照、版本与明确的重启或热更新约定 | 这三项可能分别验证。一份可以成功解析的 JSON 仍可能包含过时值;一次正确保存也不意味着运行中的连接已切换。 ## 原子替换为什么仍会丢更新 假设初始配置包含路由 A 和语言中文。两个窗口各自复制一份: ```text 窗口 A:读取 v1 → 把路由改成 B 窗口 B:读取 v1 → 把语言改成英文 A 保存完整配置:路由 B,语言中文 B 再保存旧副本:路由 A,语言英文 ``` 两次写入都可以使用 `os.replace()`,两次文件都完整,A 的更新还是丢了。原子替换负责一次文件替换,不会自动判断写入者的读取基线是否已经过时。 [Python 的 os.replace 文档](https://docs.python.org/3/library/os.html#os.replace)说明了替换语义及跨文件系统等限制。实际设计中,临时文件放在目标目录,可以避免意外跨文件系统;文件刷新、目录项持久化和断电恢复仍受系统及文件系统影响,不能简单宣传为“绝不丢数据”。  *图1:原创更新过程示意;这是可复现的操作交错,不是性能或压力测试结果。* ## 保存时重新读取,只更新自己负责的字段 局部保存的作用,是不把用户没有编辑的旧字段写回。修改路由的窗口应在提交时读取最新配置,把新的路由段合入其中,而不是重新序列化打开窗口时整份应用配置。 但仅仅“重读后局部写入”仍不够:如果另一个窗口也修改了路由,本窗口还需要知道它的草稿是不是过时。因此编辑器保存打开时的基线,提交时比较相关字段。 | 提交时的变化 | 合理处理 | | --- | --- | | 只有无关账号资料改变 | 保留最新资料,继续保存本窗口修改 | | 路由段与打开时不同 | 提示冲突,要求重新核对 | | 本窗口要改的账号绑定被别人修改 | 检查对应账号的旧绑定,拒绝不明覆盖 | | 本窗口没有改动的高级选项发生变化 | 不用旧值覆盖它 | 基线不仅可能包含值,还可能包含字段是否存在和类型。缺失、显式 `null`、`false` 与整数 `0` 不应未经约定就视为同一种配置状态。 这是乐观并发控制的一种思路:允许用户先编辑,提交时才检查是否仍基于有效版本。HTTP 的 [If-Match 条件请求](https://www.rfc-editor.org/rfc/rfc9110.html#name-if-match)提供了类似的“先验证条件再执行修改”机制,但它不意味着本地 JSON 文件天然拥有 HTTP 的并发保障。 ## 同进程锁需要覆盖整个提交过程 如果比较完基线就释放锁,另一个线程仍可能在真正写入之前改变配置。因此锁需要覆盖重读、检查、合并与写入,而不只是最后一行 `os.replace()`。 [threading 的 Lock](https://docs.python.org/3/library/threading.html#lock-objects)可以协调同一进程中使用同一把锁的线程。它不会锁住任意外部编辑器;其他进程或绕过入口的写入者,也不会因为这里有锁就自动参与约定。 以下完整例子限定为:路由段已经存在且是字典,所有示例写入者通过同一保存入口操作,运行环境为 Python 3.8 及以上。将其保存为 `config_example.py` 后运行 `python config_example.py`,数据仅写入临时目录。 ```python from copy import deepcopy import json import os from pathlib import Path import tempfile from threading import Lock LOCK = Lock() class ConflictError(RuntimeError): pass def atomic_write(path, data): temporary = None try: with tempfile.NamedTemporaryFile( mode="w", encoding="utf-8", newline="\n", dir=path.parent, delete=False, ) as stream: temporary = Path(stream.name) json.dump(data, stream, ensure_ascii=False) stream.flush() os.fsync(stream.fileno()) os.replace(temporary, path) finally: if temporary is not None: temporary.unlink(missing_ok=True) def save_routing(path, base, replacement): with LOCK: latest = json.loads(path.read_text(encoding="utf-8")) if latest["routing"] != base: raise ConflictError("routing changed; reload before saving") updated = deepcopy(latest) updated["routing"] = deepcopy(replacement) atomic_write(path, updated) return updated if __name__ == "__main__": with tempfile.TemporaryDirectory() as directory: path = Path(directory) / "example.json" initial = {"routing": {"mode": "direct"}, "language": "zh"} atomic_write(path, initial) base = deepcopy(initial["routing"]) # 模拟无关字段在窗口打开后被更新。 latest = deepcopy(initial) latest["language"] = "en" atomic_write(path, latest) saved = save_routing(path, base, {"mode": "proxy"}) assert saved["language"] == "en" assert saved["routing"]["mode"] == "proxy" before = path.read_bytes() try: save_routing(path, base, {"mode": "other"}) except ConflictError: pass else: raise AssertionError("stale draft was accepted") assert path.read_bytes() == before ``` 示例检查了无关字段保留、合法更新和过时草稿被拒绝。异常捕获只针对预期的冲突,其他错误继续报告。它没有实现完整输入校验、跨进程锁、崩溃恢复或存储设备故障模拟。 生产实现还应保证所有写入路径遵循同一约定。若要求多个进程共享、频繁并发写入或更复杂的事务,应该评估支持所需事务语义的存储,而不是不断增加“保存失败再读一次”的分支。[SQLite 的隔离说明](https://www.sqlite.org/isolation.html)可以作为评估事务及连接并发行为的起点,迁移本身仍需设计。 私有案例仍有这项限制:路由编辑器通过 `update_config()` 在同一锁内重读、检查和保存,但 `save_accounts()`、`save_dm_config()` 等路径仍先读取整份配置,再单独调用加锁的保存函数。因此,路由编辑器保护了自己的提交过程,却不能阻止其他写入者稍后写回旧副本;不能据此宣称整个应用已经消除了丢失更新。 2026年11月7日,对提交 `895a6f9` 的配置模块进行了临时目录内的隔离交错验证。使用无账号的示意配置与标记字段,在旧保存路径读完后插入一次事务更新,再让旧保存路径继续执行: ```text save_accounts 读取:标记值 old update_config 保存:标记值 new save_accounts 写回先前副本 最终文件:标记值 old ``` 验证中确认 `new` 曾经落盘,最终又恢复成 `old`。这是人工安排交错得到的结果,不是线上故障记录、随机并发压力测试或真实账号数据。私有源码不能由读者公开复核;前面的独立教学示例用于说明正确保存路径的有限行为,不能替代项目全部写入路径的验收。 ## 运行快照使配置生效范围可预测 浏览器运行时改规则,可能出现旧连接继续走原路径,新连接突然走新路径的情况。私有案例选择在启动时生成快照,让已运行浏览器保持原版本,新浏览器读取新配置。  *图2:原创状态示意。保存和运行生效是两个步骤,热更新需要额外设计。* 这里有三个状态: - 草稿属于编辑窗口,修改和预览不直接落盘。 - 已保存配置属于应用状态,提交时检查并保留相关约定。 - 运行快照属于一次任务,明确何时生成、由谁持有、何时释放。 快照必须独立于编辑中的可变对象。简单的字典浅拷贝可能继续共享内部列表,`dataclass(frozen=True)` 也不会自动让内部字典或列表深度不可变。[dataclasses 文档](https://docs.python.org/3/library/dataclasses.html#frozen-instances)描述的是属性赋值限制。可以根据数据规模和使用方式选择独立深拷贝、不可变结构或规范化序列化值。 版本标识可以帮助日志说明任务采用了哪份配置,但不应把一个哈希前缀写成认证、防篡改或权限机制。它首先是关联配置快照的线索。 ## 设置界面应表达真正的生效约定 案例的当前界面把路由和 WebRTC 放进同一弹窗,但两者不共享作用域:规则组可由账号选择,WebRTC 选项仍是全局配置。同一个保存按钮只表示一次提交,不表示这些字段拥有相同作用对象。 “默认组”“未匹配动作”“完全没有配置时的初始值”也需要分开命名。隐藏调试选项时保留其值,不等于可以省略提示:如果隐藏值仍生效,产品说明就应让用户知道。 保存成功后,可以明确提示“新启动的浏览器生效”。已有任务要立即改变,则应提供独立、可解释的操作。刷新标签页是否会重建相关状态,需要依据实际实现判断,不能由按钮文字推断。 ## 配置回归测试应保护哪些行为 验证目标应该围绕结果,而不只检查序列化函数被调用: | 场景 | 应保留的行为 | | --- | --- | | 两个窗口修改相同路由段 | 后保存者收到冲突,已保存内容不被覆盖 | | 另一个窗口只修改无关资料 | 新资料保留,相关字段可正常提交 | | 配置段缺失与配置损坏 | 按各自约定处理,不静默混用 | | 保存后继续使用旧任务 | 旧快照保持,新任务采用新值 | | 隐藏再展开高级选项 | 值保留,实际生效行为有说明 | | 写入失败 | 原文件与草稿按约定保留,错误可观察 | 本文示例仅实证其中有限的本地保存行为。私有项目源码中的检查路径、历史测试记录和正式软件可用性需要分开记录,不能把静态阅读写成完整产品验收。 ## 参考资料 资料核对日期为2026年11月6日。示例和图解均为原创教学材料;案例的配置语义以固定提交的实现为依据。 1. [Python:os.replace](https://docs.python.org/3/library/os.html#os.replace),文件替换及系统边界。 2. [Python:threading Lock](https://docs.python.org/3/library/threading.html#lock-objects),线程内同步。 3. [Python:dataclasses 冻结实例](https://docs.python.org/3/library/dataclasses.html#frozen-instances),不可变性的范围。 4. [RFC 9110:If-Match](https://www.rfc-editor.org/rfc/rfc9110.html#name-if-match),条件修改与丢失更新的相关机制。 5. [SQLite:Isolation](https://www.sqlite.org/isolation.html),事务与连接并发边界。 --- --- title: "HTTP、HTTPS 与 SOCKS5 代理有什么区别?隧道与 DNS 解析详解" source: https://www.iowill.com/blog/2026/11/http-https-socks5-proxy-differences/ date: 2026-11-07 updated: 2026-11-07 tags: [DNS, HTTP, HTTPS, SOCKS5, 代理] categories: [系统与运维] --- # HTTP、HTTPS 与 SOCKS5 代理有什么区别?隧道与 DNS 解析详解 **HTTP、HTTPS 和 SOCKS5 代理的区别,首先在于客户端如何与代理通信,而不是目标网站地址里有没有 `https://`。** HTTP 代理可以承载到 HTTPS 网站的隧道;HTTPS 代理给客户端到代理的连接增加 TLS;SOCKS5 通过自己的握手提交目标地址和命令,本身不自动提供内容加密。 判断配置时,应分别确认代理协议、目标协议、目标域名由谁解析,以及客户端实际实现了哪些功能。只看端口号或“支持 SOCKS5”这几个字,无法回答全部问题。 本文以标准、浏览器及 curl 官方资料解释机制,辅以个人项目的脱敏实现案例。案例源码阅读固定到 `56e25be7f9792a4245f343408bbb061df59bbf7e`;没有对公网代理商进行速度、匿名性或可用性评测。文中的报文是教学示例,不是实际抓包。 案例描述开发源码中的能力,不表示某个正式安装包已交付相同功能。协议标准、浏览器能力与项目实际实现分别判断。 ## 代理服务器与目标网站是两个连接对象 浏览器访问 `https://www.example.com/`,代理地址配置为 `http://127.0.0.1:18080`。两个 URL 的 scheme 分别说明不同对象:前一个是目标网站,后一个是代理入口。 ```text 客户端 → 代理服务器 → 目标网站 ↑ ↑ 代理协议 目标协议 ``` 这是正向代理的讨论范围。网站运维中的反向代理代表服务器接收客户端请求,职责与这里不同;基本分类可参见 [MDN 的代理与隧道说明](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Proxy_servers_and_tunneling)。如果关注站点迁移,可另外阅读[反向代理与重定向的区别](https://www.iowill.com/blog/2026/10/reverse-proxy-vs-redirect/)。 端口只是约定。8080 不必然是 HTTP 代理,1080 也不能证明当前进程实现 SOCKS5。连接到监听端口后,双方实际交换的协议必须一致。 ## HTTP 代理怎样访问 HTTPS 网站 HTTP 代理处理普通 HTTP 请求时,可以接收包含目标完整 URL 的请求。访问 HTTPS 目标则通常先建立 CONNECT 隧道: ```http CONNECT www.example.com:443 HTTP/1.1 Host: www.example.com:443 ``` 这里的空行是报文头结束;实际 HTTP/1.1 报文使用 CRLF。上游接受隧道后,客户端才通过这条字节通道与网站执行 TLS 握手。CONNECT 本身不会替浏览器完成目标网站的证书验证。 [RFC 9110](https://www.rfc-editor.org/rfc/rfc9110.html#name-connect)规定了 CONNECT 的隧道语义和成功响应后的处理。实现一个健壮客户端,还需要处理响应头边界、错误状态、超时与连接关闭,不能只搜索响应字符串里是否包含“200”。 因此,把 HTTP 代理称为“只能访问 HTTP 网站”并不准确。相反,也不能因为目标 HTTPS 内容经过隧道加密,就认为客户端与代理之间的一切都被加密:若代理连接本身是明文 HTTP,CONNECT 中的目标主机信息仍暴露给能够观察这段连接的一方。 ## HTTPS 代理增加的是到代理的 TLS 配置 HTTPS 代理时,客户端首先和代理服务器建立 TLS,再在受保护的连接中发送代理协议。对于 HTTPS 目标,可以把两层关系理解为: ```text 到代理的 TLS └─ CONNECT 隧道 └─ 到目标网站的 TLS ``` 外层保护客户端到代理这一跳,内层保护客户端到目标网站的通信。两处服务器身份、证书链与失败原因应分别处理。[TLS 1.3 标准](https://www.rfc-editor.org/rfc/rfc8446.html)说明了 TLS 的安全目标;不能用“有 TLS”代替对连接对象和信任关系的说明。 在本文的隧道转发案例中,代理没有终止目标网站的 TLS,不需要安装自定义根证书。企业审计代理可能另有 TLS 解密设计,那需要明确的证书信任与管理安排,不能混同为所有 HTTPS 代理的默认行为。  *图1:原创概念示意;代理连接加密与目标连接加密分别判断。* ## SOCKS5 先协商,再提交目标 SOCKS5 使用独立的二进制握手。下面只展示无认证 TCP CONNECT 的简化过程: ```text 客户端 → 代理:版本、认证方法列表 代理 → 客户端:选定认证方法 客户端 → 代理:CONNECT、目标地址类型、地址、端口 代理 → 客户端:成功或失败应答 成功后:双向转发应用字节 ``` [RFC 1928](https://www.rfc-editor.org/rfc/rfc1928.html)定义了 IPv4、域名和 IPv6 地址类型,也定义了 CONNECT、BIND 与 UDP ASSOCIATE 等命令。协议定义了能力,不等于任意标注 SOCKS5 的产品都实现了全部能力。 个人项目中的本地入口只实现需要的无认证 TCP CONNECT,没有 UDP ASSOCIATE,也没有用户名密码认证。它能承载 HTTPS 连接,是因为后续目标 TLS 在字节通道中建立,并不是 SOCKS5 自动给通道加了 TLS。 该案例的上游 HTTP、HTTPS 和 SOCKS5 连接也没有实现用户名密码认证,配置校验会拒绝认证字段。浏览器原生支持的某种认证不会自动传递给本地路由层,因此不能把需要账号密码的上游地址直接当作已经支持的配置。 如果客户端尝试使用服务不支持的认证方法或命令,应收到明确失败。添加一个密码输入框,不能替代协议实现;TCP 代理工作,也不能证明 WebRTC 的 UDP 路径已被转发。 ## 三种代理放在同一张表里比较 | 比较项 | HTTP 代理 | HTTPS 代理 | SOCKS5 | | --- | --- | --- | --- | | 客户端到代理的交互 | HTTP 代理请求 | TLS 中的 HTTP 代理请求 | SOCKS5 协商与命令 | | 到代理的连接是否自动带 TLS | 否 | 是,仍需正确校验证书 | SOCKS5 自身不提供 TLS | | 能否承载 HTTPS 目标 | 可通过 CONNECT | 可通过受保护的 CONNECT | 可通过 TCP CONNECT 字节通道 | | 客户端提交的目标 | HTTP 请求目标或 CONNECT authority | 同左,但到代理这一跳有 TLS | IPv4、IPv6 或域名 | | UDP 能力 | 不能仅从普通 HTTP CONNECT 推断 | 不能仅从普通 HTTPS CONNECT 推断 | 标准有 UDP ASSOCIATE,实现需另行确认 | | 认证支持 | 看代理和客户端实现 | 看代理和客户端实现 | 需双方支持相同方法 | 表格描述本文涉及的传统代理方式,不涵盖所有新扩展或隧道协议。它也不是性能排名:延迟、吞吐和稳定性需要在固定客户端、链路、负载和服务端条件下实际测量。 ## DNS 解析位置由客户端行为决定 SOCKS5 请求可以提交域名,也可以提交已经解析好的 IP。前者让代理有机会解析目标域名,后者则可能已经在客户端完成了目标解析。 curl 正好提供了清楚的对照。以下命令是使用形式示意,需有可用的本地 SOCKS5 服务,本文没有连接这个虚构端口执行公网请求: ```bash # curl 在本地解析目标域名。 curl --proxy socks5://127.0.0.1:1080 https://example.com/ # curl 把目标主机名交给代理解析。 curl --proxy socks5h://127.0.0.1:1080 https://example.com/ ``` `socks5h` 是 curl 表达解析选择的 URL scheme,不是另一版 SOCKS 协议,也不能直接套用到所有客户端。[everything curl 的 SOCKS 说明](https://everything.curl.dev/usingcurl/proxies/socks.html)直接列出了这个区别。 浏览器有自己的实现。[Chromium 文档](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md)说明了 Chrome 对不同代理类型的目标解析行为。不能把 curl 的同名配置语义推断为所有浏览器的行为;多级转发时,还要检查每一跳究竟收到什么目标形式。 另一个常被遗漏的问题是代理服务器自身的域名。即便目标域名交给远端处理,客户端连接 `proxy.example.net` 时,仍可能需要解析这个代理主机。DNS 请求自身又使用哪条网络路径,需要结合系统与应用解析器配置单独观察。 对本文的多级转发案例,可以进一步按实际分支判断: | dyDM 收到目标域名后的动作 | 目标域名如何处理 | | --- | --- | | 直连目标 | 本机通过系统解析器解析,再建立 TCP 连接 | | HTTP/HTTPS 上游 | 目标域名保留在 CONNECT 的目标中,交由上游处理 | | SOCKS5 上游 | 使用域名地址类型提交目标,交由上游处理 | Chromium 把目标域名交给本地 SOCKS5,只说明浏览器将这一步委托给本机 dyDM,并不等于已经交给远端。上游代理自身若配置为域名,dyDM 仍要在本机解析它;表中的“交由上游”也不证明上游使用哪种 DNS 服务或 DNS 流量已通过指定隧道。该区分依据固定源码与[Chromium 的 SOCKSv5 解析说明](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md#socksv5-proxy-scheme),没有用公网抓包验证全部解析路径。  *图2:原创解析位置示意,不表示所有客户端采用同一种 DNS 策略。* ## 多级代理必须逐跳检查 在浏览器固定连接本地 SOCKS5、应用再转发到 HTTP 上游的案例中,至少有两次代理协商:浏览器与本地入口进行 SOCKS5 握手,本地入口与上游进行 CONNECT。 当前案例还对普通 HTTP 目标使用 CONNECT 建立 TCP 隧道。这是该实现的传输选择,不是所有 HTTP 代理访问普通 HTTP 目标都必须这么做。上游若只允许部分目标端口,即使协议名称与地址正确,也可能拒绝请求。 一次检查至少应区分: 1. 本地端口是否存在,且讲的是预期协议。 2. 代理认证方法是否匹配。 3. CONNECT 或 SOCKS5 目标连接是否被接受。 4. 若连接代理需要 TLS,它的证书是否有效。 5. 目标网站 TLS 是否成功。 6. 实际目标请求和出口是否符合规则。 连接超时、认证拒绝、上游不允许目标端口和目标证书错误,不应全部归类成“网站账号失效”。同样,代理地址可连通也不代表它能够访问所有目标。 ## 配置选择应围绕实际需求 已有 HTTP 代理基础设施,需要浏览器访问 HTTP/HTTPS 网站时,可以先检查客户端和服务端是否满足现有方式;需要保护到代理的网络一跳时,评估 HTTPS 代理与证书管理;应用希望通过统一地址协议提交 TCP 目标时,可以评估 SOCKS5 的实际支持范围。 选型不只比较协议名称,还要记录认证、解析、证书、允许端口、失败策略及 UDP 要求。若目标是隐私保护,网页请求出口、DNS、WebRTC 与其他应用流量仍需要分别验证,不能靠其中一项成功替代其余证据。 ## 参考资料 资料核对日期为2026年11月6日;原创报文和连接图为教学内容,私有案例不作为协议标准。 1. [RFC 9110:CONNECT](https://www.rfc-editor.org/rfc/rfc9110.html#name-connect),HTTP隧道语义。 2. [RFC 1928:SOCKS5](https://www.rfc-editor.org/rfc/rfc1928.html),协商、地址与命令。 3. [RFC 8446:TLS 1.3](https://www.rfc-editor.org/rfc/rfc8446.html),TLS安全目标及连接边界。 4. [Chromium:Proxy support in Chrome](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md),浏览器的具体代理行为。 5. [everything curl:SOCKS proxy](https://everything.curl.dev/usingcurl/proxies/socks.html),curl的本地与代理侧解析选项。 6. [MDN:Proxy servers and tunneling](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Proxy_servers_and_tunneling),代理角色与隧道概念。 --- --- title: "Playwright 如何按域名分流?代理规则与浏览器配置实践" source: https://www.iowill.com/blog/2026/11/playwright-domain-proxy-routing/ date: 2026-11-06 updated: 2026-11-07 tags: [Chromium, Playwright, Python, 代理] categories: [编程开发] --- # Playwright 如何按域名分流?代理规则与浏览器配置实践 **Playwright 按域名分流,可以让浏览器连接一个固定代理入口,再由入口根据目标主机选择直连或不同上游。** 简单场景也可以使用浏览器已有的代理和绕过配置;只有需要多组规则、明确的匹配顺序与失败策略时,才值得增加应用自己的路由层。 多个账号的浏览器目录解决 Cookie、站点存储等会话隔离;域名分流解决连接路径。目录独立不等于出口不同,指定一个代理端口也不等于页面关联的所有请求都采用预期路径。 本文结合个人桌面工具 dyDM 的私有实现,统一以提交 `56e25be7f9792a4245f343408bbb061df59bbf7e` 为代码阅读基线。公开原理与原创教学示例供读者复核,私有项目的历史网络测试不作为本次重测结果。本文不提供完整生产代理服务,也不接管整机流量。 这里的实现对应开发源码,不表示正式安装包已经包含全部能力。2026年11月7日复核到的提交 `895a6f9` 已包含可选的本地代理拒绝连接后直连,差异在失败策略一节单独说明。 ## 浏览器原生代理配置适合哪些场景 [Playwright 网络文档](https://playwright.dev/python/docs/network#http-proxy)提供浏览器级和 BrowserContext 级代理配置。一个会话始终使用同一个出口时,直接配置已经足够;需要独立会话时,再结合不同 Context 或持久化目录管理。 以下是配置形式示意,`127.0.0.1:19090` 是虚构端口,需要由真实可用的代理服务提供。代码没有实现代理,也不是执行后即可联网的完整程序: ```python # Chromium Context 配置片段;browser 由调用方提供。 context = browser.new_context( proxy={ "server": "socks5://127.0.0.1:19090", "bypass": "<-loopback>", } ) ``` Chromium 默认让 `localhost`、回环及部分链路本地目标绕过代理。这里的 `<-loopback>` 用于取消这组隐式绕过规则,让访问本地目标的连接也进入案例的规则判断;它不是“绕过本地代理服务器”。这与 dyDM 的租约配置一致,尤其影响本地夹具验证。该语法针对 Chromium,不应直接推广到所有浏览器;是否代理本地资源应由应用明确决定。[Chromium 的隐式绕过规则说明](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md#implicit-bypass-rules) 如果只有少量“这些目标绕过代理”的条件,也应先评估原生 `bypass` 是否已经满足要求。不要把每个项目都写一个本地服务当作 Playwright 的必要步骤。 私有案例选择增加路由层,原因是它同时需要按账号引用规则组、支持精确例外和后缀规则、保留运行版本,并在命中代理却连接失败时返回错误。这些是应用约定,不能自动由一个地址输入框表达。 `context.route()` 则用于请求拦截、修改、模拟或继续处理 HTTP 请求,与建立通用 TCP 代理是不同层次。这里讨论的是连接下一跳,不是通过模拟响应改变页面内容。 ## 用一次新连接理解本地路由入口 假设浏览器请求 `https://www.example.com/article`,需要新建连接。应用给浏览器的地址是本地 SOCKS5 入口,用户真正配置的上游则是另一个 HTTP 代理端口: ```text 浏览器 → 本地 SOCKS5 入口 127.0.0.1:19090 → 按 www.example.com 选择代理 A → HTTP 上游 127.0.0.1:18080 → www.example.com:443 ``` SOCKS5 请求包含目标地址与端口;本地入口从中得到 `www.example.com:443`,并不读取 HTTPS 中的 `/article`。主机名如何编码、IPv4/IPv6/域名地址类型如何区分,见 [RFC 1928](https://www.rfc-editor.org/rfc/rfc1928.html)。如果客户端交来的是 IP,当前案例不会通过反向 DNS 或 TLS SNI 恢复原始域名。 命中 HTTP 上游后,应用发送 CONNECT;上游接受隧道,再向浏览器报告 SOCKS5 连接成功。目标网站的 TLS 仍由浏览器完成,应用只转发字节,不安装解密证书。[RFC 9110 的 CONNECT 定义](https://www.rfc-editor.org/rfc/rfc9110.html#name-connect)用于支持这一协议解释,不能据此证明某个上游实际可达。 如果新连接的目标没有命中代理规则,应用可以直接连接目标。**浏览器仍经过本地入口,入口之后的动作才是直连。** 这与浏览器完全绕过本地入口不同。  *图1:原创连接示意,描述一次新建 TCP 连接,不是抓包结果。* 一个页面还会加载接口、图片、媒体和登录资源。这些连接使用各自的目标主机匹配规则,不能因为主页面属于 `example.com`,就假设另一个接口域名也会走同一个代理。连接复用还会影响新规则何时有机会参与选择。 ## 规则先后顺序比名称更重要 规则组至少需要表达:匹配对象、启用状态、动作、优先顺序和未匹配动作。服务器与规则组采用稳定 ID,账号引用 ID,名称只用于展示;改名不应破坏绑定。 例如希望一个接口直连、其余子域走代理: | 顺序 | 匹配条件 | 动作 | | --- | --- | --- | | 1 | 精确域名 `api.example.com` | 直连 | | 2 | `example.com` 本域及子域 | 代理 A | | 未匹配 | 没有启用规则命中 | 直连 | 精确例外必须放在宽泛后缀前。后缀判断也要遵守标签边界:`a.example.com` 属于该后缀,`notexample.com` 不属于。 下面是独立教学示例,只支持精确域名和域名后缀,输入限制为合法 ASCII 域名;不是从私有项目复制的完整匹配器。将它保存为 `rules_example.py`,运行 `python rules_example.py`: ```python def choose_action(host, rules, fallback="direct"): host = host.strip().rstrip(".").lower() for rule in rules: if not rule["enabled"]: continue pattern = rule["pattern"] if rule["match"] == "exact": matched = host == pattern elif rule["match"] == "suffix": matched = host == pattern or host.endswith("." + pattern) else: raise ValueError("unsupported match type") if matched: return rule["action"] return fallback rules = [ {"enabled": True, "match": "exact", "pattern": "api.example.com", "action": "direct"}, {"enabled": True, "match": "suffix", "pattern": "example.com", "action": "proxy-a"}, ] assert choose_action("API.EXAMPLE.COM.", rules) == "direct" assert choose_action("cdn.example.com", rules) == "proxy-a" assert choose_action("notexample.com", rules) == "direct" assert choose_action("other.test", rules, "proxy-b") == "proxy-b" ``` 真实实现还需在保存阶段校验类型、目标引用、ID、端口及域名,处理 IDNA 和 IP 字面值,并让预览与运行时复用同一套匹配逻辑。不能把未校验数据直接交给示例函数,再把错误解释成默认直连。 ## 未匹配直连与代理失败直连是两种策略 未匹配动作是用户事先选定的规则;命中代理后再改为直连,则是连接失败时改变了路径。 ```text 没有规则命中 → 执行该组的未匹配动作 已经命中代理,但连接或握手失败 → 返回连接错误 ``` 私有案例选择第二种情况不尝试直连。这个结论只描述应用中对应连接分支的行为,不能扩大成浏览器或系统所有网络路径都获得了相同保证。 上述流程和图2对应 `56e25be` 基线。后续开发版本(核对至 `895a6f9`)允许对单个本地代理明确开启 `direct_on_local_refused`:旧配置缺失该字段时保持关闭;只有代理地址为回环 IP、连接代理自身端口明确被拒绝,且尚未发送代理协议数据时,才尝试一次直连目标。远程代理、连接超时、认证或 CONNECT 拒绝、证书错误,以及连接建立后的故障,都不触发这一例外。每个新连接仍先尝试原代理,不会永久切换到直连。 回退采用系统路由,实际出口可能是本地网络,也可能受 VPN 或其他隧道影响,不能保证仍使用指定代理出口。需要固定代理出口时应保持关闭;此选项也不表示应用会自动重放已经提交的业务操作。 配置缺失和配置损坏也要区分。缺少整个配置段,可以按明确的初始约定创建默认组;已经存在却解析失败、格式版本未知或引用不存在时,应阻止相应启动并提示修复。把两者都处理成空字典,会让一个配置错误悄悄变成路径选择。  *图2:原创规则示意;图中域名、动作和服务器名称均为教学数据。* PAC 也需要分别检查脚本获取失败、旧脚本重新获取和返回代理不可达等条件。[Chromium 代理文档](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md)描述了这些机制及条件差异。案例中的历史 PAC 反例解释了项目取舍,但不构成“PAC 在所有环境都不可靠”的结论。 ## 保存新规则为什么不改变旧浏览器 案例采用启动快照:浏览器启动时读取账号最新绑定,校验规则,固定配置版本,取得对应本地入口,然后再创建浏览器。已运行的浏览器继续使用自己的版本,新启动的浏览器才采用保存值。 这样可以避免一个正在运行的任务在新旧路径间突然切换。它不是热更新的唯一设计;如果产品确实需要立即切换,应另外处理已有连接、重试、任务状态和用户确认,不能把“保存成功”直接等同于所有连接已更新。 默认组表示账号没有单独绑定时继承哪个组;未匹配动作表示当前组没有规则命中时怎么办。默认组同样可以包含代理规则,不能把“默认”当作“直连”的别名。 浏览器会话也不应因为继承规则而复制。重新登录可以继承原账号的规则来源,同时使用独立候选目录;规则归属与 Cookie 归属分别管理。 ## 验证入口、上游和出口需要不同证据 | 检查 | 可以支持的结论 | 仍不能证明 | | --- | --- | --- | | 浏览器访问本地专用探针并返回正确版本 | 到达预期入口和快照 | 远端代理可达 | | 上游夹具收到连接,目标端记录对应请求 | 指定连接经过该上游 | 所有页面子资源都被覆盖 | | 关闭上游后,目标端没有收到绕过请求 | 已测失败路径未转直连 | 系统全部流量都无法绕过 | | 指定检测接口返回预期地址 | 该次接口请求的出口符合预期 | WebRTC、其他应用和 DNS 路径相同 | “页面返回 200”可能来自代理,也可能来自直连,不能单独证明规则有效。排查 IP 不符时,应先确认实际检测接口的域名、当前快照和命中规则,再检查上游出网与其他网络路径。 当前案例的本地服务处理 TCP,不实现 SOCKS5 UDP ASSOCIATE,不自动接管 Python 下载或整机网络。WebRTC 的限制与验证需另行进行,可先参考[已有的 WebRTC 泄漏机制文章](https://www.iowill.com/blog/2026/10/webrtc-ip-leak/)。 本地入口还增加了应用自身的资源责任:监听器、并发连接、握手和空闲超时、DNS 查询、取消和退出都需要管理。只绑定回环地址,也不等于获得本机用户隔离。本文介绍连接模型和规则约定,不声称私有实现已完成打包环境及长期压力验证。 ## 参考资料 资料核对日期为2026年11月6日。前述规则示例为作者原创;私有案例仅提供脱敏机制描述,不以内部链接充当公开证据。 1. [Playwright:HTTP Proxy](https://playwright.dev/python/docs/network#http-proxy),代理配置层次。 2. [Playwright:BrowserContext](https://playwright.dev/python/docs/api/class-browsercontext),会话与初始化能力。 3. [Chromium:Proxy support in Chrome](https://chromium.googlesource.com/chromium/src/+/HEAD/net/docs/proxy.md),浏览器代理和PAC行为。 4. [RFC 1928:SOCKS5](https://www.rfc-editor.org/rfc/rfc1928.html),目标地址、命令及协议边界。 5. [RFC 9110:CONNECT](https://www.rfc-editor.org/rfc/rfc9110.html#name-connect),HTTP隧道语义。 --- --- title: "AI Agent UI/UX 设计指南:视觉审美、交互体验与设计规范" source: https://www.iowill.com/blog/2026/11/ai-agent-ui-ux-design/ date: 2026-11-05 updated: 2026-11-05 tags: [AI Agent, UI设计, UX设计, 交互设计, 设计系统] categories: [编程开发] --- # AI Agent UI/UX 设计指南:视觉审美、交互体验与设计规范 AI Agent 可以生成界面代码,也可以参与布局、组件和交互方案的设计。要让这些产物适合实际使用,需要把用户任务、视觉方向、操作状态和项目规范一起交给它,并检查最终实现是否兑现了这些要求。 **用 AI Agent 做 UI/UX 设计,可以按“明确任务 → 确定视觉方向 → 定义交互状态 → 固化设计规范 → 实现与验证”的流程推进。** 审美需要具体的设计选择,交互需要完整的任务路径,规范则让这些决定在多个页面和多轮修改中持续生效。 本文面向使用 Agent 开发网页、后台和工具界面的开发者。以作者构造的任务管理页面贯穿说明,结合公开设计系统与无障碍资料,讨论设计说明、实现和审查。图示与规范片段均为原创教学示例;UX Engine 仅作工具案例,本文没有安装或运行其付费插件,也没有进行有无插件的效果对照实验。 ## 明确用户任务与界面范围 UI(用户界面)包含文字、颜色、控件和布局等可感知、可操作的呈现;UX(用户体验)的讨论还要覆盖用户如何理解任务、完成操作和处理问题。两者会在具体设计中相互影响:按钮的位置和样式影响发现与选择,失败后的提示和恢复方式也需要通过界面表达。 给 Agent 下任务前,先说明用户、场景、内容和平台。一个供运营人员高频使用的批量任务后台,与面向首次访问者的产品介绍页,通常需要不同的信息密度和视觉重点。网页、桌面程序和原生手机应用也有各自的组件与平台约定,不能仅凭一张参考图复用全部交互。 本文的教学案例是一页**导出任务管理界面**:用户创建导出任务,查看正在执行的任务,并处理失败项。页面展示任务名称、状态、创建时间和当前可用操作。示例中的设计目标是让用户看清哪些任务需要处理,并找到下一步。 这个目标会影响后续决定:执行失败的任务需要明确的恢复入口;运行中的任务需要说明状态;完成的任务可以提供下载结果。界面是否需要大幅装饰、统计卡或侧栏,应由这些任务和实际内容决定。 ## 把审美要求变成具体设计选择 “高级一点”“更简洁”“不要像模板”可以表达偏好,但不足以决定字号、信息密度和组件关系。给 Agent 的视觉要求应继续说明:希望形成什么气质、哪些内容优先、参考中的哪些特征值得保留,以及哪些既有样式需要沿用。 ### 排版与层级:先安排阅读顺序 在任务页面中,可以让页面标题先说明位置,让任务名称承担内容识别,让状态和操作说明帮助决策,再将时间等辅助信息放到次一级。层级可以通过位置、字号、字重、颜色与留白共同表达,不需要让每个区域都争夺注意力。 对这一教学页面,我会先采用克制、清晰的工具型排版:正文使用易读的常规字重,任务名适度强调,标题与内容之间保留明显分组。中文字体回退、长任务名、数字与英文混排也要进入样张,而非只用几条整齐的短占位文字。 [Carbon 的排版文档](https://carbondesignsystem.com/guidelines/typography/overview/)将字号、字重和行高组合为可复用样式,并区分产品界面与更具表现力的内容场景。可以借鉴其建立层级的方法;字体和具体尺寸仍应按产品需求选择。 ### 留白与密度:让相关内容形成分组 任务名与它的状态应被看成一组,不同任务之间则要有足够区分。若组件之间的距离比同组内容的距离还小,用户就需要额外判断信息属于哪里。 可以先选择一组间距值,再约定组内、组间和页面边缘分别使用哪些值。这样既便于 Agent 实现,也方便发现例外。高频后台可以保留较高密度,但应优先减少无用字段、重复标签和装饰占位,再决定是否收紧行距与空间。 [Carbon 的间距系统](https://carbondesignsystem.com/guidelines/spacing/overview/)用间距令牌支持布局一致性,并通过距离表达关系和层级。它提供的是一种具体设计系统的做法,不意味着所有项目都必须采用同一组数值。 ### 色彩与材质:解释每一种强调的用途 可以为页面背景、内容表面、主要文字、辅助文字、主要操作和危险操作分别定义角色。品牌强调色与状态色也需要区分,避免让“品牌使用绿色”与“任务执行成功”在同一处产生含义冲突。 状态应有文字或其他明确线索,不能只依赖色差;阴影、描边、圆角和渐变也应承担分组、层次或品牌表达的作用。统一使用大圆角不自动等于有质感,完全去掉装饰也不自动等于专业。 可读性有可核对的要求。例如,[WCAG 2.2 的文本对比度解释](https://www.w3.org/WAI/WCAG22/Understanding/contrast-minimum.html)说明了普通文本、大文本及相关例外。检查时需要核对实际前景和背景,而不能仅凭“看起来颜色够深”。至于偏好温暖还是冷静、紧凑还是舒展,仍要结合产品定位与目标用户讨论。 ### 图标、图片与动效:保持同一种表达 图标的线宽和尺寸应协调,重要操作优先使用明确名称;图片或插画需要与产品内容建立联系。动效可以帮助理解展开、排序或反馈的变化,但应控制等待成本,并考虑减少动态效果的用户偏好。 向 Agent 指定参考时,可以写“参考这张页面的低饱和背景、紧凑列表与明显标题层级”,再补充希望保留的项目组件。这样比要求完整复制某个知名产品更容易讨论取舍,也能保留自己的产品气质。  原创设计示意:把审美要求对应到排版、空间、色彩与操作。图中内容为虚构教学样张,不是 UX Engine 的生成结果或产品实测截图。 ## 让交互体验覆盖完整任务 视觉方案需要与任务状态一起设计。列表、按钮和提示文案应当反映系统当前能做什么,而不只是填满页面上的位置。 | 场景 | 用户需要知道什么 | 教学页面的处理方案 | | --- | --- | --- | | 首次加载 | 内容尚未返回,页面在工作 | 保留布局结构并表达加载状态;不提前显示“没有任务” | | 尚无任务 | 为什么为空,怎样开始 | 说明任务用途,提供创建任务入口 | | 搜索无结果 | 当前条件没有匹配项 | 保留搜索条件,提供调整或清空条件的操作 | | 刷新失败但已有内容 | 当前展示是否仍可信 | 保留已有任务,提示刷新失败及必要的时间信息,提供重试 | | 任务运行中 | 执行到了哪里,可以做什么 | 展示真实可获得的阶段或进度;取消能力由实际任务系统决定 | | 部分任务失败 | 哪些成功,哪些还需处理 | 分别保留成功结果和失败原因,提供针对失败项的恢复入口 | [Carbon 的空状态指南](https://carbondesignsystem.com/patterns/empty-states-pattern/)区分首次无数据、用户操作后的无结果以及错误情境,并建议提供适合当前情况的下一步。这些情况可以共用视觉结构,但说明和操作需要随原因变化。 ### 反馈应说明发生了什么,以及接下来能做什么 “操作失败”通常还缺少用户决策所需的信息。对于导出任务,可以在已确认原因的前提下说明输入需要修改、权限不足或服务暂时不可用,并分别给出可执行的下一步;不知道原因时,不应编造“网络异常”。 表单校验失败时,应帮助用户找到问题并保留适合继续编辑的输入。[GOV.UK 的校验错误模式](https://design-system.service.gov.uk/patterns/validation/)说明了保留已填内容、关联错误摘要与字段提示的做法;它的具体校验策略属于该设计系统,应结合项目研究和控件环境采用。 动态反馈还要考虑辅助技术能否感知。[WCAG 状态消息解释](https://www.w3.org/WAI/WCAG22/Understanding/status-messages.html)讨论了不转移焦点时,怎样让状态变化可以通过适当语义被识别。实现时要控制反馈频率,不能让每一帧进度更新都变成一次打断。 ### 批量、取消与撤销需要对应真实能力 “全选”要说明选择的是当前页还是全部匹配任务。筛选改变、翻页或部分执行失败后,选择范围与反馈数量也需要保持一致。 取消运行通常意味着请求停止后续工作;撤销则涉及恢复已经发生的结果。这两者的实现条件不同。如果后端无法恢复已删除数据或外部副作用,界面上就不能仅靠一个“撤销”按钮承诺恢复。 [WCAG 对重要提交错误预防的解释](https://www.w3.org/WAI/WCAG22/Understanding/error-prevention-legal-financial-data.html)列出了可逆、检查和确认等方式。产品应根据操作后果选择保护方案,而不是对所有动作机械增加确认框,或对所有删除机械取消确认。 ### 手机与键盘路径需要单独检查 窄屏可以调整字段顺序、将辅助信息收进详情,并让主要操作保持可发现。桌面悬停才出现的入口,应有触控与键盘可达的替代路径;表格是否横向滚动、转为列表或提供详情,需要按比较任务决定。 本文示例将重要按钮的触控区域目标设为至少 44×44 CSS 像素,作为作者的项目设计约定。[WCAG 2.2 SC 2.5.8](https://www.w3.org/WAI/WCAG22/Understanding/target-size-minimum.html)描述的是 24×24 CSS 像素的最小目标及其间距等例外,不能把两者当成同一条统一阈值。 弹窗还需要合理的初始焦点、内部键盘顺序和关闭后的焦点去向。[WAI-ARIA APG 的模态对话框模式](https://www.w3.org/WAI/ARIA/apg/patterns/dialog-modal/)提供了相关交互指导。加上一个 `role` 属性并不能代替实际焦点管理与测试。 ## 将设计决定整理成项目规范 设计规范要把已作出的决定连接到可复用实现。颜色表之外,还需要布局规则、文字层级、组件用法、状态、文案、响应式行为和例外条件。 设计令牌(Design Tokens)可以为重复使用的设计决定命名,让样式和文档使用共同词汇。[DTCG 2025.10 格式模块](https://www.designtokens.org/TR/2025.10/format/)定义了在工具间交换设计令牌的格式;它是社区组报告,并非 W3C 正式标准。项目可以借鉴令牌方法,不必为了写一份设计说明就引入完整的交换工具链。 下面是作者为教学页面自拟的 CSS 变量片段。它展示语义命名与复用,不是 UX Engine 配置,也不保证覆盖完整主题或无障碍要求: ```css :root { --surface-page: #f5f7fa; --surface-panel: #ffffff; --text-primary: #18212f; --text-secondary: #526071; --action-primary: #245b4a; --action-danger: #a52a39; --space-1: 0.25rem; --space-2: 0.5rem; --space-3: 1rem; --space-4: 1.5rem; --radius-panel: 0.75rem; } .task-list { display: grid; gap: var(--space-3); } ``` `DESIGN.md` 可以承接这些决定,但应先检查项目是否已有相同职责的文档、样式变量和组件库,确定唯一维护入口。以下同样是教学片段,尺寸和约定需要按真实产品调整: ```text 设计对象:导出任务管理网页,面向需要处理异常任务的运营人员。 视觉方向:清晰、克制;任务信息优先,装饰服务于分组和识别。 排版:沿用项目字体;正文16px,辅助信息14px,页面标题28px。 空间:组内8px,组件内16px,区块间24px;例外说明用途。 颜色:使用语义令牌;状态同时提供文字;核对实际对比度。 组件:复用已有按钮、输入和弹窗;主要操作与危险操作区分。 状态:区分首次加载、无数据、无结果、刷新失败和部分成功。 输入:校验失败保留可继续编辑的内容,错误与对应字段关联。 交互:运行中的可用操作由任务状态决定,不虚构进度或撤销能力。 适配:重要触控区域目标44px;窄屏明确字段优先级,允许长文本换行。 键盘:操作有名称,焦点可见,弹窗关闭后回到合理位置。 修改:新页面复用规范;新增令牌或组件先说明理由并更新入口。 ``` 规范应允许有依据的例外。例如,数据比较页面可能需要更高密度,营销页面可能需要更强的视觉表现。例外应指出场景和范围,避免同一种组件在不同页面因为多轮生成而逐渐变成不同实现。 **自然语言规范是 Agent 的上下文,不是程序层面的强制保证。** 关键约束仍需通过组件复用、静态检查、浏览器检查和行为测试验证。 ## 给 Agent 的设计任务要包含输入与验收条件 一个可执行的设计任务,可以同时提供页面目标、现有实现、参考特征和约束。以下是作者建议的任务说明模板,读者需要替换为自己的项目资料: ```text 目标:让用户发现导出失败的任务,并理解原因和可用的恢复操作。 范围:现有任务列表网页;沿用原接口、权限与任务状态语义。 先阅读:项目说明、现有设计规范、按钮/输入/弹窗组件和相邻页面。 视觉方向:低饱和背景、清晰层级、适度紧凑;说明参考中的具体特征。 交互要求:覆盖加载、无数据、无结果、刷新失败、运行中和部分成功。 实现要求:复用语义令牌和组件,明确窄屏、键盘及长文本方案。 先交付:任务与假设摘要、布局说明、关键状态和准备修改的文件范围。 完成后:提供实现、实际完成的验证、观察结果和仍需人工判断的问题。 ``` 对于既有页面的小幅调整,可以只补充本次变化、必须遵守的既有约定与验收条件,不必每次重新定义整套设计系统。对于新页面或目标模糊的任务,则需要在实现前澄清会影响正确性的关键问题。 ## 从设计说明到实现与审查 | 阶段 | 给 Agent 的输入 | 应得到的产物或判断 | | --- | --- | --- | | 理解任务 | 用户、场景、真实内容、平台和约束 | 任务说明、关键假设、待解决问题 | | 确定方向 | 已有规范、参考特征和内容优先级 | 布局与视觉选择及其理由 | | 定义细节 | 主要路径、异常路径、组件能力 | 关键组件、状态表、文案和恢复方案 | | 实现 | 已确认的设计与代码边界 | 可运行界面、复用组件和必要规范修改 | | 审查 | 实际内容、视口、输入方式与验收任务 | 已观察的问题、修复与验证证据 | 建议先检查少量关键页面与状态,再扩展相同设计语言。只看正常状态的一张截图,容易漏掉长文本、失败反馈、主题切换和窄屏条件下的实际问题。  原创流程示意:每个阶段都有明确输入和产物,审查结果反馈到实现与规范。该图表达作者建议,不表示已经运行的 Agent 或用户研究结果。 ## UX Engine 如何辅助这套流程 像 UX Engine 这样的技能工具,可以将设计检查组织为重复调用的流程。[Agent Skills 的公开说明](https://agentskills.io/home)将技能描述为包含 `SKILL.md` 和可选资源的目录,Agent 在需要时加载相应指令。这可以解释通用的知识与流程注入方式,不能据此推断某个付费包的内部实现。 截至本文资料核对日期 2026-11-05,[designmotionhq 官网](https://designmotionhq.com/)展示的 UX Engine 2.4 包含意图、层级、状态、表单、反馈、审查、设计系统、视觉和响应式等技能方向,并列出 `/ux-design`、`/ux-audit`、`/ux-review`、`/restyle` 四个命令。可以分别关注新页面设计、已有页面问题、代码变化和视觉调整;实际调用与客户端支持应以对应版本说明为准。 这类工具的价值需要通过实际交付判断:是否读到了已有规范,是否保留业务行为,是否补全必要状态,是否让设计选择有据可查。厂商演示与自建项目上的模型评审不等于目标用户研究,本文也没有复现这些结果。 即使不依赖特定插件,明确的任务说明、组件规范、状态表与审查流程仍可以作为 Agent 的工作输入。工具负责帮助执行和组织检查,产品目标、风格取舍与验收结论仍需要项目负责者判断。 ## 将视觉审查与可用性验证分开记录 视觉审查可以检查文字层级、对齐、间距、密度、颜色角色及组件一致性;浏览器检查可以观察窄屏、长文本、主题与焦点状态;行为验证则需要检查操作是否产生正确结果、失败是否保留必要信息,以及恢复路径是否真的有效。 如果声称某次改版改善了实际体验,还需要相应证据。[GOV.UK 的可用性测试指南](https://www.gov.uk/service-manual/user-research/using-moderated-usability-testing)建议让实际或潜在用户尝试明确、可信的任务,并观察他们如何完成。任务说明应提供目标,避免直接告诉参与者按哪个按钮。 在教学页面中,可以设定“找到昨天失败的导出任务,确认原因并尝试恢复”这一目标。观察用户是否理解任务状态、是否找得到入口、哪里需要解释;如果记录耗时、错误或完成情况,还需说明样本、条件、任务差异和限制。 本文没有开展这类用户测试。两张图只能解释设计方法,不能证明任务完成时间缩短或用户更喜欢某种风格。Agent 自查、静态检查和截图比较各有用途,结论应与实际完成的验证对应。 ## 常见问题 ### AI Agent 能自己决定产品审美吗? 可以让 Agent 根据目标与参考提出方案和理由,再由项目负责人确认方向。对于偏好或品牌取舍,应保留选择依据;对于文字可读性、控件语义和任务行为,则使用相应检查。不能把模型对截图的偏好直接当作目标用户的判断。 ### 写一份 DESIGN.md 就够了吗? 还需要让它与实际令牌、组件和审查流程保持对应。文档写着复用组件,代码却在每个页面另造按钮,规范就没有落实。修改规范时也应检查既有页面是否受影响。 ### 设计规范会让界面失去特色吗? 规范可以保存已经选择的产品特色,包括排版气质、色彩、密度和动效,而不只是限制差异。需要避免的是将某套通用模板的外观直接当作所有产品的目标。 ## 参考资料 以下资料支持相邻段落中的具体机制或设计建议。Carbon、GOV.UK 与 UX Engine 各自的多篇页面属于同源材料;W3C Understanding 与 APG 为解释和实现指导,引用时保留相应范围。本文未进行插件对照实验或用户效果研究。 1. [Carbon:Typography](https://carbondesignsystem.com/guidelines/typography/overview/)。排版层级与样式复用。 2. [Carbon:Spacing](https://carbondesignsystem.com/guidelines/spacing/overview/)。间距与分组。 3. [W3C:Understanding SC 1.4.3](https://www.w3.org/WAI/WCAG22/Understanding/contrast-minimum.html)。文本对比度与例外。 4. [Design Tokens Format Module 2025.10](https://www.designtokens.org/TR/2025.10/format/)。设计令牌交换格式及社区组报告身份。 5. [Carbon:Empty states](https://carbondesignsystem.com/patterns/empty-states-pattern/)。空状态分类与下一步。 6. [GOV.UK:Recover from validation errors](https://design-system.service.gov.uk/patterns/validation/)。输入保留与错误恢复。 7. [W3C:Understanding SC 4.1.3](https://www.w3.org/WAI/WCAG22/Understanding/status-messages.html)。状态消息。 8. [W3C APG:Dialog (Modal) Pattern](https://www.w3.org/WAI/ARIA/apg/patterns/dialog-modal/)。模态焦点与键盘交互。 9. [W3C:Understanding SC 2.5.8](https://www.w3.org/WAI/WCAG22/Understanding/target-size-minimum.html)。目标尺寸、间距及例外。 10. [W3C:Understanding SC 3.3.4](https://www.w3.org/WAI/WCAG22/Understanding/error-prevention-legal-financial-data.html)。重要提交的错误预防。 11. [Agent Skills Overview](https://agentskills.io/home)。技能机制。 12. [UX Engine 产品官网](https://designmotionhq.com/)。工具案例的公开范围。 13. [GOV.UK:Using moderated usability testing](https://www.gov.uk/service-manual/user-research/using-moderated-usability-testing)。任务设计与用户观察。 --- --- title: "AI Agent 改完代码后,如何做回归测试?从缺陷复现到行为评估" source: https://www.iowill.com/blog/2026/11/regression-testing-ai-agents/ date: 2026-11-03 updated: 2026-11-03 tags: [AI Agent, 回归测试, 自动化测试, 软件测试] categories: [编程开发] --- # AI Agent 改完代码后,如何做回归测试?从缺陷复现到行为评估 AI Agent 改完代码后,回归测试用于确认:**这次修改满足新要求的同时,已有的关键行为仍然符合约定。** 新增搜索功能能够找到结果,还需要检查原有筛选、默认参数、排序和数据处理是否保持正常。 [IBM 对回归测试的介绍](https://www.ibm.com/cn-zh/think/topics/regression-testing)强调了代码修改后检查已有功能的目的。把这个原则用于 AI 辅助开发,重点是建立可重复的验证依据,而不是依赖 Agent 的“已修复”说明。 本文主要讨论编码 Agent 修改软件后的验证流程,后半部分再讨论 **Agent 本身作为被测应用** 的情况。Python 示例为作者编写的本地教学案例,没有运行真实模型,也不代表某个商业 Agent 的检出能力或真实项目事故。资料核对日期为 **2026 年 11 月 3 日**。 ## 回归测试、缺陷复测与测试层次 一次修改通常需要回答两类问题:原来的缺陷是否已经修复,以及与它有关的既有行为是否受到影响。二者都重要,覆盖范围却不相同。 | 验证目的 | 关注的问题 | 列表筛选示例 | | --- | --- | --- | | 缺陷复测 | 原先失败的条件是否恢复正确 | 停用状态筛选是否只返回停用项 | | 回归测试 | 修改后,已有约定是否仍成立 | 默认查询、启用筛选、顺序和输入数据是否保持正常 | | 新功能测试 | 新要求是否实现 | 关键词搜索及与状态筛选的组合是否正确 | 这些目的可能由同一组测试共同覆盖,不必为每个概念复制一套相同用例。一个缺陷修复后的测试,也可以长期保留为回归用例。 “回归”说明为什么测试;单元、集成、端到端说明测试覆盖的层次;手动与自动化说明如何执行。一个端到端用例可以承担回归验证,单元测试也可以保护原有接口。IBM 的文章涉及多种方法,实际选择应结合变更影响、风险与执行成本,不需要每次更新都套用全部分类。 ## Agent 修改代码时需要保护哪些约定 编码 Agent 可以阅读实现、生成补丁、补充测试并调用工具。但它仍可能漏掉调用方依赖的隐含条件,尤其是默认值、空值、布尔值、兼容字段和异常路径。 例如,需求是“给任务列表增加关键词搜索”,原有行为包括: - `enabled=None` 不按状态筛选。 - `enabled=True` 只返回启用项,`enabled=False` 只返回停用项。 - 未填写关键词时,保持原有查询结果和顺序。 - 查询不修改传入的数据。 如果验收只检查“输入 Alpha 后能搜到任务”,便可能漏掉 `False` 筛选失效的问题。测试依据应来自需求、公共接口和已确认的行为;旧版本中的已知缺陷不应该因为“以前就是这样”而被固定成正确答案。 [Google Testing Blog 关于行为测试的文章](https://testing.googleblog.com/2013/08/testing-on-toilet-test-behavior-not.html)建议主要围绕公共接口验证行为,让测试不依赖经常变化的实现细节。对 Agent 编写的补丁,同样应检查业务结果,而不只是验证某个辅助函数是否被调用。 ## 布尔筛选的回归测试示例 这个例子只处理内存中的虚构任务。参数范围限定为 `enabled` 取 `None`、`True` 或 `False`,`keyword` 为字符串,不展开完整接口的输入校验。 新增搜索时,一种可能的错误是把条件写成: ```python if enabled: result = [task for task in result if task["enabled"] is enabled] ``` `False` 和 `None` 都不会进入这段分支,但它们在约定中代表不同含义。只测试 `enabled=True` 就发现不了这个问题。 在独立示例目录中创建修正后的 `example.py`。空关键词不筛选名称,非空关键词忽略大小写,返回结果沿用输入顺序: ```python def select_tasks(tasks, *, enabled=None, keyword=""): result = tasks if enabled is not None: result = [task for task in result if task["enabled"] is enabled] if keyword: needle = keyword.casefold() result = [task for task in result if needle in task["name"].casefold()] return [task["id"] for task in result] ``` 将以下内容保存为同一目录中的 `test_example.py`: ```python from copy import deepcopy import unittest from example import select_tasks TASKS = [ {"id": "t1", "name": "Alpha", "enabled": True}, {"id": "t2", "name": "Alpha backup", "enabled": False}, {"id": "t3", "name": "Beta", "enabled": True}, ] class SelectTasksTests(unittest.TestCase): def test_filter_combinations(self): cases = [ (None, "", ["t1", "t2", "t3"]), (True, "", ["t1", "t3"]), (False, "", ["t2"]), (None, "ALPHA", ["t1", "t2"]), (False, "alpha", ["t2"]), (True, "beta", ["t3"]), (False, "beta", []), (None, "missing", []), ] for enabled, keyword, expected in cases: with self.subTest(enabled=enabled, keyword=keyword): self.assertEqual( select_tasks(deepcopy(TASKS), enabled=enabled, keyword=keyword), expected, ) def test_does_not_modify_input(self): tasks = deepcopy(TASKS) before = deepcopy(tasks) select_tasks(tasks, enabled=False, keyword="alpha") self.assertEqual(tasks, before) if __name__ == "__main__": unittest.main() ``` 在这两个文件所在目录运行: ```bash python -m unittest -v ``` 示例只使用 Python 标准库。`subTest` 把不同参数组合单独标记,某个组合失败时能够定位相应条件;其行为见 [Python unittest 文档](https://docs.python.org/3/library/unittest.html#distinguishing-test-iterations-using-subtests)。这里有两个测试方法,其中一个包含多组子测试,不能把方法数量直接当作覆盖范围。 作者在隔离临时目录中核对了三个版本:新增关键词之前的基线、刻意使用 `if enabled:` 的错误版本,以及上面的修正版本。原有筛选用例在基线中通过,在错误版本中能够暴露 `False` 的退化;修正后,原有约定和新增组合均通过。错误版本是人工构造的演示,不是某个 Agent 的实际输出。 这些结果只验证列出的输入组合和输入不被修改的约定,没有验证界面、数据库、并发或真实模型行为。为更大的应用增加回归覆盖时,需要继续沿调用链选择测试。  *图1:作者原创教学示意,对应上面的虚构任务案例;不是Agent实际输出或运行截图。* ## 按变更影响选择回归范围 回归范围应由依赖关系和风险决定,不能只按修改了几行代码来判断。共享解析函数的一行改动,可能同时影响导入、导出和界面展示。 | 修改位置 | 适合优先检查的行为 | 可能需要补充的验证 | | --- | --- | --- | | 筛选、排序或参数转换 | 默认值、空结果、边界与旧调用方式 | 组合条件和调用方集成 | | 配置或数据格式 | 旧格式读取、保存后重读、失败时的数据保留 | 迁移与恢复路径 | | 界面和浏览器交互 | 可见状态、按钮操作、错误提示 | 不同窗口尺寸、主题与真实交互路径 | | 后台任务与资源管理 | 启动、取消、完成和重复执行 | 监听器、线程、连接及退出清理 | | 模型、提示词或工具定义 | 既有任务能否继续完成 | 工具参数、权限边界、最终状态与质量评估 | 这张表是选测建议,不是已经在某个项目上执行的测试清单。局部纯函数可以从快速用例开始;涉及共享接口、数据迁移或核心流程时,再扩大到集成与关键端到端路径。发布前还需要符合项目约定的完整检查。 界面回归应验证用户实际看到和操作的结果。[Playwright 的最佳实践](https://playwright.dev/docs/best-practices)强调用户可见行为、测试隔离与稳定定位。针对界面布局的改动,仅通过一个纯函数测试,不能证明按钮可点击或窄屏内容没有被遮挡。 ## 测试失败时核对原因与基线 修改前运行相关测试,可以帮助区分已有失败与本次回归。已经完成修改时,也可以在独立工作目录中检查变更起点,保留当前现场;不应为了制造干净基线而丢弃未提交内容。 失败需要结合证据分类: - **预期未变,结果改变**:检查实现或调用关系是否退化。 - **需求明确改变**:依据批准后的新约定修改测试,同时评估兼容影响。 - **测试绑定实现细节**:调整不再适用的设置或断言,但继续保护真实行为。 - **结果偶发变化**:检查共享状态、执行顺序、清理、网络依赖,也排查产品中的竞态。 [pytest 的不稳定测试说明](https://docs.pytest.org/en/stable/explanation/flaky.html)列出了系统状态未受控、隔离不足及断言过严等原因。偶发失败不应自动归咎于环境,也不能靠重复运行到通过一次就宣告修复。 Agent 同时修改实现和测试时,需要检查断言差异。删除失败用例、放宽阈值或让预期值跟着错误实现变化,都会削弱原有保障。合理调整测试当然可以进行,但应能解释行为约定为什么改变,并留下相应依据。 ## Agent 本身需要额外的行为评估 如果应用本身包含 Agent,仅保护外围 Python 函数还不够。模型、提示词、工具描述或编排方式变化,都可能影响同一任务的完成方式。 [Anthropic 对 Agent 评估的介绍](https://www.anthropic.com/research/demystifying-evals-for-ai-agents)区分任务、单次尝试、执行记录和最终结果,也区分能力探索与回归评估。对已能处理的任务保留回归集,有助于发现新版本的退化;这不意味着所有 Agent 都使用同一阈值。 以下为作者建议的检查对象,需按实际应用定义成功条件: | 检查对象 | 可验证的结果示例 | | --- | --- | | 工具选择与参数 | 使用适合当前任务的工具,必填字段与目标对象正确 | | 权限边界 | 只读任务没有发起写入调用,相关业务状态保持不变 | | 错误处理 | 工具超时后按约定停止或有限重试,没有假报成功 | | 最终状态 | 需要生成的文件或记录确实存在,内容符合约定 | | 回答质量 | 事实有依据,完整性与表达满足明确的评价标准 | “任务已完成”这句回复不能替代文件、数据库或工具执行结果。相反,也不必要求每次尝试采用完全相同的工具顺序:只有业务确实依赖的顺序才应作为硬约束。 对于能够明确判定的结果,优先使用代码和状态断言;对开放式回答,可以结合清晰的评分标准、模型评审与人工抽查。模型评审也需要校准,不能让一个平均质量分掩盖越权调用等硬性失败。 比较版本时,应记录代码提交、模型标识、提示词与工具定义版本、测试数据、初始状态、运行条件和评价器。对存在随机性的任务安排多次尝试,记录失败分布及具体案例;一次成功不代表持续稳定,参数相同也不保证输出逐字一致。这是评估设计建议,本文没有实际调用模型来测量通过率。  *图2:作者原创概念示意;软件行为与Agent行为分别验证,本文未进行真实模型评测。* ## 把回归检查接入 Agent 开发流程 一套可执行的协作流程可以按以下顺序组织: 1. 明确新要求、需要保留的行为和不在本次范围内的内容。 2. 记录变更基线与已有失败,为实际缺陷保留能复现它的用例。 3. 实现最小相关修改,补齐新行为及受影响旧行为的测试。 4. 在隔离环境中运行相关检查,按证据处理失败,再检查最终差异。 5. 根据影响扩大必要验证;Agent应用另比较任务数据集、工具调用与最终状态。 6. 汇报通过、失败和未覆盖范围,按项目权限决定合并或发布。 测试环境应使用脱敏样本、临时目录与受控工具。不要为了验证重试或取消行为,直接反复执行真实发布、私信、付款等外部操作;模拟工具可以验证本地控制逻辑,真实服务的行为需要另外安排验证。 [LangSmith 对评估类型的说明](https://docs.langchain.com/langsmith/evaluation-types)将发布前的离线评估与生产中的在线观察分开。上线后发现的真实失败可以脱敏后加入后续回归集;生产监测也不能反过来替代发布前检查。 让 Agent 参与生成用例、分析影响和整理结果,可以减少部分重复工作,但通过率、检出率或节省时间都需要实际测量。本文引用 IBM 关于AI辅助测试的讨论作为背景,没有把它当作特定产品的效率证明。 需要把上述流程与审查、任务隔离连接起来,可以继续阅读[AI Code Review与人工代码审查](https://www.iowill.com/blog/2026/10/ai-code-review-vs-human-code-review/)和[什么时候创建Git任务分支](https://www.iowill.com/blog/2026/10/when-to-create-git-branch/)。回归测试提供已验证行为的证据,合并与生产发布仍按项目约定执行。 ## 参考资料 资料于2026年11月3日核对。IBM为用户指定的概念参考,工具官方文档用于说明相应能力;Anthropic与LangSmith资料属于其评估实践。本文流程与教学代码为作者整理,不宣称复现了这些机构的产品效果。 1. [IBM:什么是回归测试?](https://www.ibm.com/cn-zh/think/topics/regression-testing),概念、影响分析与方法背景。 2. [Google Testing Blog:Test Behavior, Not Implementation](https://testing.googleblog.com/2013/08/testing-on-toilet-test-behavior-not.html),围绕公共行为设计测试。 3. [Python:unittest](https://docs.python.org/3/library/unittest.html#distinguishing-test-iterations-using-subtests),标准库测试与子测试。 4. [Playwright:Best Practices](https://playwright.dev/docs/best-practices),用户可见行为与测试隔离。 5. [pytest:Flaky tests](https://docs.pytest.org/en/stable/explanation/flaky.html),不稳定测试的原因与处理思路。 6. [Anthropic:Demystifying evals for AI agents](https://www.anthropic.com/research/demystifying-evals-for-ai-agents),Agent评估的对象、尝试、结果与回归集。 7. [LangChain:Evaluation types](https://docs.langchain.com/langsmith/evaluation-types),离线与在线评估的分工。 --- --- title: "CDN 会误拦 AI Search 吗?从 WAF 规则到抓取日志排查" source: https://www.iowill.com/blog/2026/10/cdn-ai-search-blocking/ date: 2026-10-30 updated: 2026-10-30 tags: [AI搜索, CDN, Cloudflare, GEO, WAF] categories: [系统与运维] --- # CDN 会误拦 AI Search 吗?从 WAF 规则到抓取日志排查 **会发生与站长期望不一致的拦截,但“AI 没有引用我的网站”不足以证明 CDN 误拦。** 需要确认请求是否真的发出、是谁发出的、命中了哪条规则,以及返回的是正文还是验证页面。 CDN 负责分发内容,WAF 与机器人防护负责按规则处理请求。同一平台把这些能力放在一起,不代表每一次访问失败都由同一个功能引起。连接超时、源站报错、主动禁止训练抓取和规则误判,需要分别判断。 本文面向使用 CDN 的博客维护者,以 Cloudflare 为主要配置背景,资料核对日期为 **2026 年 10 月 30 日**。内容是官方机制与排查方法整理,**没有取得足以确认本站 AI 搜索请求被误拦的完整日志,也没有对本站执行防护规则变更**。文中的命令、条件示例不代表官方机器人实测结果。 ## 搜索抓取、用户读取与训练抓取的区别 允许搜索发现网站,同时限制训练用途,是可以分别表达的内容策略。机器人名称与用途应查对应服务的官方资料,不宜把带有“AI”的请求全部归为一类。 | 服务标识 | 官方说明的主要用途 | 排查时关注什么 | | --- | --- | --- | | OAI-SearchBot | ChatGPT 搜索相关抓取 | 搜索访问策略与对应来源范围 | | GPTBot | 可能用于基础模型训练的内容抓取 | 是否符合站长的训练用途政策 | | ChatGPT-User | 某些由用户操作触发的页面访问 | 不等于自动搜索抓取,robots规则可能不适用 | | PerplexityBot | 帮助网站出现在 Perplexity 搜索结果中 | 机器人自己的来源范围与访问策略 | | Perplexity-User | 用户提问触发的页面读取 | 与自动抓取分开核对,官方说明通常忽略robots规则 | [OpenAI 的机器人文档](https://developers.openai.com/api/docs/bots)区分了搜索、训练与用户触发访问,并发布对应 IP 范围;[Perplexity 的文档](https://docs.perplexity.ai/docs/resources/perplexity-crawlers)同样区分两类请求。表中的标识是用途线索,**仅凭 User-Agent 字符串不能确认身份**。 Cloudflare 的[现行 AI 机器人策略文档](https://developers.cloudflare.com/bots/additional-configurations/block-ai-bots/)列出 Search、Agent、Training 等行为分类,以及整站阻止、含广告页面阻止和不增加阻止的选项。兼具搜索与训练用途的抓取也需要按实际分类检查,不能由机器人名称自行推断。 旧教程中的单一“Block AI bots”开关不能概括全部现行设置。该文档同时包含旧选项与迁移说明;操作时应以账号实际控制台、套餐和已启用策略为准,不从一张旧截图推定本站当前配置。 ## 误拦需要同时满足策略与请求证据 假设你希望某个经过验证的搜索机器人访问公开文章,但一条“阻止自动化访问”的自定义规则将它拒绝,这才是需要调查的策略冲突。若你本来就决定禁止该类请求,规则按预期阻止它,便不应仅因对方是 AI 服务而称为误拦。 这是判断方法示例,不是本站事故记录。需要核对的证据包括: - **预期策略**:允许哪种用途、哪些机器人、哪些公开路径。 - **实际请求**:时间、主机名、路径、来源身份和请求标识能否对应。 - **处理结果**:命中规则、动作与返回内容是否符合预期。 - **复测差异**:有限调整后,同类请求是否取得完整正文。 CDN 缓存命中时,请求可能直接由边缘响应,源站没有对应访问日志不等于被拦截。反过来,源站收到请求,也不证明最终传给读取工具的是可用正文。应把边缘与源站记录放到同一次请求链路中检查。  原创概念示意,不表示Cloudflare内部精确执行顺序,也不是实测截图。 ## HTTP 状态、挑战页面与连接错误的判断 | 观察结果 | 可以先确认什么 | 仍需核对什么 | | --- | --- | --- | | DNS、TCP 或 TLS 阶段失败 | 尚未拿到正常 HTTP 响应 | 网络路径、解析与连接;不能直接认定WAF拦截 | | 403 | 访问被拒绝 | 是边缘规则、源站权限还是其他服务返回 | | 429 | 请求遇到限流类响应 | 哪一层限流、阈值与请求频率是否对应 | | 5xx | 链路或服务出现错误 | 边缘与源站各自的状态、事件和可用性 | | 200,但内容为验证页、登录页或空壳 | 传输成功不等于文章可读 | 最终正文、跳转链路、渲染和访问前提 | Cloudflare 对其 Challenge Page 提供明确标识:响应头中出现 `cf-mitigated: challenge`,响应类型为 `text/html`。[官方检测说明](https://developers.cloudflare.com/cloudflare-challenges/challenge-types/challenge-pages/detect-response/)支持用该字段识别此类挑战。 这个标识用于 Cloudflare 的挑战页,不是所有拦截的统一标志。没有它,不能反推“绝对没有WAF处理”;同样,`Content-Type: text/html` 本身也不能区分正常文章和验证页。 ## 用 GET 保存响应头与正文 在 Linux / macOS shell 中,可对自己管理的公开文章执行一次低频检查。Windows PowerShell 中使用 `curl.exe`,避免命令别名差异。将示例域名与路径替换为目标地址: ```bash curl --connect-timeout 10 --max-time 30 \ --silent --show-error \ --dump-header response.headers \ --output response.html \ 'https://example.com/blog/article/' ``` 文件保存在当前目录。检查响应头中的状态、`Content-Type`、`Location`、`CF-Ray` 与 `cf-mitigated`,再打开 `response.html` 查看实际内容。仅运行 HEAD 请求不能检查正文;本例也不把所有非200状态一概当成失败原因。 本命令没有自动跟随跳转。若收到3xx,核对 `Location` 后继续检查最终地址,并保留前后响应;不要把第一跳正常当成最终文章正常。普通 curl 成功,只能说明这次请求路径可用,不能代替其他服务出口的结果。 需要比较 UA 条件时,可以另存一组响应: ```bash curl --connect-timeout 10 --max-time 30 \ --silent --show-error \ --user-agent 'OAI-SearchBot' \ --dump-header simulated-ua.headers \ --output simulated-ua.html \ 'https://example.com/blog/article/' ``` **这是手动修改请求头的模拟请求,不是真实 OAI-SearchBot。** 它最多帮助发现按UA字符串处理的差异,不能验证官方来源身份,也不能据此创建仅凭UA放行的安全例外。两次结果还可能受时间、缓存或请求频率影响,需要继续关联日志。两条命令的响应保存方式已在本地模拟HTTP服务中核验,覆盖普通正文、按UA返回模拟挑战和保留跳转;这不验证真实Cloudflare规则或官方机器人。 ## 在安全事件中核对具体规则 Cloudflare 的[Security Events](https://developers.cloudflare.com/waf/analytics/security-events/)用于查看被安全产品处理或标记的请求,不是所有访问的完整流水。其日志可能采样;一个请求也可能对应多条安全事件。因此,列表没有命中项,并不能单独证明请求没有到达。 排查时,我会按以下顺序缩小范围: 1. 统一发生时间和时区,确认主机名、原始路径及最终跳转地址。 2. 用请求标识、路径、来源等条件定位事件,记录实际产品、规则ID与动作。 3. 对照服务商公开来源范围或其支持的身份验证方式,不把控制台中的机器人名称当作唯一证据。 4. 查看源站或托管平台日志,同时检查缓存命中,避免把“未回源”误判为“被挡住”。 5. 如果日志缺失,检查查询窗口、采样与套餐能力;证据不足时保留待验证结论。 [AI Crawl Control 的管理文档](https://developers.cloudflare.com/ai-crawl-control/features/manage-ai-crawlers/)还说明,面板中的失败请求可能来自其他规则或响应错误;免费套餐中的相关识别依赖UA字符串。运营统计中的分类与安全放行所需的身份依据,应分别判断。 可用这张表保存证据,空项写“未取得”,不要按猜测补齐: | 证据项 | 建议记录内容 | | --- | --- | | 时间与目标 | 含时区的时间、主机名、路径和跳转链路 | | 请求身份 | UA、官方来源核对方式及结果 | | 边缘处理 | 请求标识、命中产品、规则ID、动作、缓存信息 | | 实际响应 | 状态、关键响应头、正文是否为目标文章 | | 源站情况 | 是否收到对应请求、返回结果与日志范围 | | 变更与复测 | 原规则、有限调整、恢复办法及同条件结果 | 公开案例时应脱敏账号、凭据、不必要的真实来源地址和后台信息。本文没有把这张待填写表当成已发生的日志。 ## Allow 与 Skip 的作用范围 在 AI Crawl Control 中选择 Allow,不代表请求自动绕过其他WAF规则。Cloudflare 的[产品交互文档](https://developers.cloudflare.com/ai-crawl-control/configuration/ai-crawl-control-with-waf/)明确讨论了这种情况:允许的机器人仍可能被更早执行的自定义规则阻止。 调整应针对已经确认的规则和请求范围。我的建议是: 1. 保存原规则、优先级和相关开关,确定可以恢复的配置。 2. 明确目标机器人与用途,使用其对应的当前官方来源范围或平台支持的验证方式;不要混用不同机器人的地址列表。 3. 只为需要公开的主机、路径和请求方式设置必要例外,不把后台或其他接口一并放开。 4. 核对命中规则属于哪个阶段,再决定修改条件或使用适当的跳过能力。 5. 复测目标请求,也检查原本需要限制的请求仍受到限制。 [Cloudflare 的 Skip 文档](https://developers.cloudflare.com/waf/custom-rules/skip/)说明,它可以跳过部分安全功能,但**不能跳过 Bot Fight Mode**。不要把它与 Super Bot Fight Mode 混为一谈;勾选哪些功能、规则顺序与套餐能力都影响实际结果。 Perplexity 的官方配置示例还要求各机器人分别匹配自己的来源范围,并指出 Skip 只作用于其后执行的相应规则。与其复制一条“包含某名称就放行”的宽泛规则,更应先找出真实命中的产品与阶段。 这些是调整方法,不是要求关闭全站防护。本篇发布不包含对本站WAF、机器人开关或访问策略的修改。  作者整理的排查方法示意;缺少证据时保留待验证结论。 ## robots.txt、索引与最终引用分别验证 `robots.txt` 表达抓取偏好,不是访问授权机制。[RFC 9309](https://www.rfc-editor.org/rfc/rfc9309.html)明确区分了这两件事:允许抓取不等于WAF必须放行,写入Disallow也不是保护私有数据的权限控制。 例如,下列片段只演示“允许某搜索抓取、限制某训练抓取”的区别,不是本站现行配置;使用时需与已有规则合并核对: ```text User-agent: OAI-SearchBot Allow: / User-agent: GPTBot Disallow: / ``` 这两组设置不替代其他产品的策略。用户触发的读取还要按服务各自说明判断,不能假定所有请求都以相同方式处理robots规则。更新文件后,也不能期待所有抓取系统立即重新访问。 恢复访问后的验收应分层记录: - **连接与响应**:请求到达,取得目标地址的正常响应。 - **正文读取**:返回内容包含可读标题、主体和必要上下文。 - **索引状态**:相关搜索系统是否已经处理该页面。 - **答案引用**:在具体问题、时间与产品下,是否出现准确引用。 Google 对[AI Overviews 与 AI Mode 的官方说明](https://developers.google.com/search/docs/appearance/ai-features)要求页面已被索引且具备在搜索中显示摘要的资格,同时强调符合要求也不保证抓取、索引或展示。这是Google搜索的适用条件,不能扩展为所有AI产品的统一规则。 因此,CDN排查的直接目标是:找到与预期不符的处理,恢复必要的正文访问,并留下复测证据。后续是否进入索引、被哪一次回答引用,需要另外观察;开启某个开关不是引用率承诺。 关于内容被引用后的信源分布,可继续阅读[拆解GEO信源生态与集中度](https://www.iowill.com/blog/2026/10/geo-source-ecosystem-concentration/);内容导览文件的作用与限制见[llms.txt文章](https://www.iowill.com/blog/2026/10/llms-txt-for-hexo-blog/)。这些内容入口不能替代访问链路的核验。 ## 参考资料 资料于2026年10月30日核对。以下为官方产品文档与标准;它们支持各自的机制说明,不代表独立复现了本站误拦,也不把同一厂商的多页文档当成多次独立效果验证。 1. [OpenAI:Overview of OpenAI Crawlers](https://developers.openai.com/api/docs/bots),搜索、训练与用户触发访问的区别。 2. [Perplexity:Perplexity Crawlers](https://docs.perplexity.ai/docs/resources/perplexity-crawlers),用途、来源范围与WAF配置边界。 3. [Cloudflare:Block AI Bots](https://developers.cloudflare.com/bots/additional-configurations/block-ai-bots/),行为分类、选项及旧设置迁移说明。 4. [Cloudflare:Manage AI crawlers](https://developers.cloudflare.com/ai-crawl-control/features/manage-ai-crawlers/),面板识别、统计与管理动作。 5. [Cloudflare:Detect a Challenge Page response](https://developers.cloudflare.com/cloudflare-challenges/challenge-types/challenge-pages/detect-response/),挑战响应标识。 6. [Cloudflare:Security Events](https://developers.cloudflare.com/waf/analytics/security-events/),事件范围、采样与字段。 7. [Cloudflare:AI Crawl Control with Cloudflare WAF](https://developers.cloudflare.com/ai-crawl-control/configuration/ai-crawl-control-with-waf/),执行顺序与Allow仍被拦的情况。 8. [Cloudflare:Configure a custom rule with the Skip action](https://developers.cloudflare.com/waf/custom-rules/skip/),跳过范围与Bot Fight Mode限制。 9. [RFC 9309:Robots Exclusion Protocol](https://www.rfc-editor.org/rfc/rfc9309.html),robots规则及非授权属性。 10. [Google:AI features and your website](https://developers.google.com/search/docs/appearance/ai-features),Google AI搜索的资格与不保证展示的边界。 --- --- title: "Git 什么时候应该创建新分支?从功能开发、Bug 修复到版本维护" source: https://www.iowill.com/blog/2026/10/when-to-create-git-branch/ date: 2026-10-29 updated: 2026-10-29 tags: [Git, 分支管理, 开发工作流, 版本控制] categories: [编程开发] --- # Git 什么时候应该创建新分支?从功能开发、Bug 修复到版本维护 新功能、Bug修复和文档修改是否需要新分支,取决于任务边界、验收要求和仓库工作流。 **新分支更适合对应一个需要独立开发、审查和集成的任务,而不是对应一轮对话、一个文件或一次提交。** 对个人项目和AI辅助开发,我推荐的默认做法是:独立功能或修复在修改前开短期任务分支,同一任务的补测、文档和审核修复继续留在原分支。 这是一套轻量协作约定,不是Git强制要求。若仓库明确采用直接提交主线的流程,应遵守其权限与验证规则;如果推送会自动部署,还要单独确认部署授权。 本文依据2026年10月29日核对的Git与GitHub官方文档,并对几个常见操作做了隔离仓库验证。命令中的远端、分支和版本名均是示例;没有在真实项目中执行分支恢复、生产推送或版本发布。 ## 新建分支与复用分支的适用场景 **具有独立目标、可单独验收并决定是否合并的改动,通常适合使用独立任务分支。** [Pro Git的分支工作流章节](https://git-scm.com/book/en/v2/Git-Branching-Branching-Workflows)介绍了围绕单一特性或相关工作创建主题分支的做法。[GitHub flow](https://docs.github.com/en/get-started/using-github/github-flow)也采用轻量的分支、审查和合并流程。这两项资料支持任务分支的组织方式,不代表所有项目都必须建立相同的长期分支结构。 | 场景 | 推荐的默认处理 | 判断重点 | | --- | --- | --- | | 新功能、独立Bug修复 | 修改前创建任务分支,即使只有一个提交 | 能否单独验收与集成 | | 独立重构、性能优化、依赖升级、数据迁移 | 创建独立分支 | 是否需要独立评估兼容性与回退 | | 风险不确定的实验 | 使用实验分支 | 未验证的方案不要混进稳定主线 | | 当前任务未完成,又开始无关任务 | 新任务用新分支,必要时另建worktree | 保留现场,避免夹带未完成工作 | | 同一功能的补测、文档和审核修复 | 继续当前任务分支 | 是否仍服务同一个验收目标 | | 只读代码、诊断、运行已有测试 | 不因只读操作创建分支 | 需要保存修复时再决定分支 | | 独立文档修改 | 通常使用docs分支 | 仓库规则或明确授权允许时可直接提交主线 | | 已发布版本紧急修复 | 从实际发布基线创建hotfix分支 | 不夹带主线上尚未发布的功能 | 改动行数不能单独决定是否创建分支。一条条件表达式也可能影响数据写入;多个文件的修改也可能只是同一功能的完整交付。分支边界应跟着任务和验收条件走。  作者建议示意:以独立目标与验收边界判断,不按文件或提交数量机械划分。 ## 分支创建时机与基线选择 独立任务的分支应在修改开始前创建。创建前确认当前分支、未提交修改和目标集成线,再选择基线,避免从无关的功能分支派生。 | 工作目标 | 通常考虑的起点 | 需要确认的条件 | | --- | --- | --- | | 下一轮正常集成的新功能或修复 | 已同步的目标集成分支 | 是否存在未同步或未集成的本地提交 | | 当前线上版本的紧急修复 | 实际发布标签或对应维护分支 | 标签是否确实对应运行中的版本 | | 多条版本线分别维护 | 各自维护线 | 修复需要同步到哪些后续版本 | | 明确依赖未合并任务B的任务C | B的任务分支 | 记录依赖、审查范围和合并顺序 | 以下示例假设目标集成线为`origin/main`,fetch配置能正常更新该引用,且工作区已确认干净: ```bash git status --short git branch --show-current git fetch origin git log --oneline --left-right main...origin/main git switch --no-track -c feat/report-export origin/main ``` `git fetch`用于获取远端对象并按配置更新引用,不自动将改动合入当前工作分支;详见[git-fetch文档](https://git-scm.com/docs/git-fetch)。`main...origin/main`只展示两者的提交差异,不处理差异。若本地main还有本次必须包含的提交,应明确它们的集成安排,不能默认从origin/main创建分支就已包含这些工作。 `--no-track`明确不把新任务分支的上游自动设成origin/main。之后需要推送时,再明确指定同名任务分支和相应权限。这一选项与新建/切换语义见[git-switch文档](https://git-scm.com/docs/git-switch)。 如果任务针对实际发布的`v1.4.2`,则示意为: ```bash git switch -c hotfix/session-expiry v1.4.2 ``` 版本名仅作示例,执行前必须确认真实基线。它不会自动把修复同步到其他维护线,也不会创建新版本或发布标签。 ## 分支、提交、标签与worktree的区别 | 对象 | 用途 | 不应混为一谈的事情 | | --- | --- | --- | | 分支 | 用一个引用组织持续演进的提交历史 | 不等于一个文件夹或一轮聊天 | | 提交 | 记录一次代码快照及其历史关系 | 一个任务分支可以有多个提交 | | 标签 | 标识一个特定历史点,常用于版本基线 | 不等于持续承载开发的分支 | | worktree | 为同一仓库提供额外工作目录 | 不等于账号、端口、数据库或运行环境隔离 | 同一功能经过“实现→补测试→修审查问题→补文档”,通常仍在同一任务分支里。每次开新对话就切新分支,会把一个验收目标拆散;把不相关任务长期塞进同一分支,则会让审查和集成难以单独决定。 大型目标可以在设计允许的情况下拆成可独立验证、不会破坏既有行为的小增量,分批合并。主干开发资料强调短期分支与及时集成,详见[Short-Lived Feature Branches](https://trunkbaseddevelopment.com/short-lived-feature-branches/);它是一种工作流观点,不能机械转化为所有团队统一的天数或分支数量指标。 ## 未提交修改的分支处理 main上尚未提交的报表导出修改,经确认均属于同一任务时,可以从当前HEAD创建分支: ```bash git status --short git diff git diff --cached git switch -c feat/report-export git status --short ``` **从当前HEAD新建分支,不会自动清空工作区,也不会替你将不同任务拆开。** 本文在隔离仓库中验证:这种场景下,已有的工作区修改、暂存内容和未跟踪文件均保留,main指向的提交没有改变。 这与切换到另一条已有历史不同。涉及会被覆盖的本地改动时,Git通常会拒绝切换;不要把拒绝提示直接理解为需要强制切换,也不要把它当成所有未跟踪数据的备份保证。确认文件归属和保存状态后,再选择提交、显式暂存方案或独立工作目录。 例如,一半是本次Bug修复,另一半是尚未完成的新功能,仅执行新建分支并不能把它们分离。需要按文件或代码块整理;无法可靠拆开时,先保留当前现场,用另一个worktree处理独立任务更清楚。 ## main已有提交的分支处理 处理已有提交前,应检查提交历史及共享状态,避免破坏性恢复。 从当前提交建立新引用并切换到该分支: ```bash git branch feat/report-export git switch feat/report-export ``` 在示例中,执行前的main指向提交C;执行后,main和feat/report-export仍同时指向C。新建分支没有将C从main“搬走”。这可由[git-branch文档](https://git-scm.com/docs/git-branch)中的创建语义解释,本文也做了隔离验证。 如果后续还要整理main,应继续确认:这些提交是否已推送、是否被他人基于其开发、仓库是否允许调整历史。已共享历史的修正,需要按协作规则安排新的修正提交或集成方案;不能为了让提交图看起来整齐就擅自重写。 以上操作仅为现有提交建立任务引用,不会恢复main。main的整理方式取决于实际提交关系和共享状态,不能直接套用强制重置或强制推送命令。 ## 使用worktree并行处理任务 功能A的工作区仍有未提交修改,而独立修复B需要并行处理时,可以保留原目录,在额外工作目录中创建B的任务分支: ```bash git worktree add --no-track -b fix/session-expiry ../project-session-fix origin/main ``` 示例要求origin/main已经按目标基线核对,分支名未被占用,目标目录可用于新工作树。本文在隔离仓库中确认:原目录的未提交修改保持不变,新目录使用独立分支且工作区干净。 [git-worktree文档](https://git-scm.com/docs/git-worktree)说明了额外工作树及分支占用限制。通常不要将同一分支同时检出到多个工作树;不同任务各自使用分支与目录,减少互相干扰。 但这种隔离主要针对工作目录与索引。仓库对象和部分引用、配置仍共享;两个实例也可能连接同一个数据库、占用同一个端口,或写同一份账号数据。需要运行时隔离时,应另行配置数据目录、端口和输出,不能直接复制真实Cookie或大型浏览器目录到工作树里。 worktree只是组织并行工作的工具,不是增加未完成任务数量的理由。长期不集成的分支仍会逐渐偏离目标主线,额外目录也需要明确负责人、用途和清理条件。  原理示意:worktree隔离工作文件与索引,不自动隔离数据库、账号和端口。 ## 分支审核、合并与清理 合并前后的检查与清理步骤如下: 1. 重新获取目标分支的状态,检查相对于目标的实际差异;依赖分支要区分继承改动与本次新增改动。 2. 完成相关审查、敏感信息检查和与改动相称的测试,补齐受影响的文档与变更日志。 3. 如果目标分支已经变化,按项目规定同步,并判断是否需要补充集成验证。 4. 按既有权限与仓库规则合并,核对实际集成提交、CI及必要验证结果。 5. 确认没有未合并提交或未保存文件后,再清理任务分支和worktree。 同步和合并方式由项目规则决定。Git的[合并文档](https://git-scm.com/docs/git-merge)说明了冲突等行为;创建了任务分支并不意味着合并时不会冲突,也不意味着可以随意rebase共享分支。 [GitHub保护分支文档](https://docs.github.com/en/repositories/configuring-branches-and-merges-in-your-repository/managing-protected-branches/about-protected-branches)提供审查、状态检查等可配置要求。这些是托管平台的保护措施,不能只靠分支命名实现,也不能将CI通过当作业务行为已全部验证。 本地删除分支时,`git branch -d`会根据上游或当前HEAD检查合并关系,不能将它当成“已合入指定目标分支”的完整证明。使用squash等方式集成后,提交祖先关系也可能与原分支不同。删除被拒绝时先确认实际集成结果,不应立即改用强制删除;worktree清理也先确认没有待保存文件。 **任务分支推送不等于主线合并,主线合并也不天然等于正式发版。** 如果仓库工作流会因推送或合并直接部署生产环境,就必须先取得该部署范围的授权。版本号、标签、Release和软件分发分别按项目所有者确认的范围执行,不能以“只是推送”绕过发布决定。 ## 分支策略的常见问题 ### 长期开发分支与发布分支的适用条件 个人项目无需默认建立长期develop分支或为每次发版创建release分支。本文推荐主分支保持可验证、可交付,独立任务用短期分支;多版本并行维护、发布冻结或其他明确需求出现时,再决定是否建立release或维护分支。项目已采用其他流程时,先理解其交付方式和约束。 ### 分支、提交与版本的关系 一个任务可以包含实现、测试、文档等多个相关提交;一次版本发布也可能汇总多个任务。分支名里的feat或fix不直接决定SemVer版本级别,兼容性影响需要另行评估。 ### AI协作中的任务与分支划分 AI协作按任务目标与工作目录划分分支。同一任务的顺序实现、审查和修复可以复用分支;真正并行、可能互相修改文件的独立任务,需要协调范围并使用合适的分支与工作树。工具角色不同,并不自动意味着任务边界不同。 需要独立开发、验收和集成的任务,应在修改前建立任务分支;同一任务的补充修改继续使用原分支。分支划分以变更边界为依据。 ## 参考资料 以下资料于2026年10月29日查阅。Git手册用于核对命令语义,GitHub资料用于说明该平台工作流,主干开发资料代表其作者体系的实践建议;同源文档不当作多次独立效果验证。 1. [Pro Git:Branching Workflows](https://git-scm.com/book/en/v2/Git-Branching-Branching-Workflows),主题分支与长期分支的组织方式。 2. [GitHub:GitHub flow](https://docs.github.com/en/get-started/using-github/github-flow),轻量分支、审查与合并工作流。 3. [Git:git-switch](https://git-scm.com/docs/git-switch),新建/切换分支、未提交修改与上游配置。 4. [Git:git-fetch](https://git-scm.com/docs/git-fetch),获取远端引用及refspec行为。 5. [Git:git-branch](https://git-scm.com/docs/git-branch),分支创建及删除条件。 6. [Git:git-worktree](https://git-scm.com/docs/git-worktree),额外工作树与分支占用限制。 7. [Git:git-merge](https://git-scm.com/docs/git-merge),合并及冲突处理语义。 8. [GitHub:About protected branches](https://docs.github.com/en/repositories/configuring-branches-and-merges-in-your-repository/managing-protected-branches/about-protected-branches),托管平台的审查与状态检查约束。 9. [Trunk Based Development:Short-Lived Feature Branches](https://trunkbaseddevelopment.com/short-lived-feature-branches/),短期分支与及时集成的实践观点,不作为所有团队统一的数量规则。 --- --- title: "AI Code Review 与人工代码审查:区别、边界与协作流程" source: https://www.iowill.com/blog/2026/10/ai-code-review-vs-human-code-review/ date: 2026-10-27 updated: 2026-10-27 tags: [AI Code Review, AI 编程, Code Review, Git] categories: [编程开发] --- # AI Code Review 与人工代码审查:区别、边界与协作流程 提交一个改动后,AI很快写出了几条审查意见:这里可能空值异常,那里建议重构,还补了一段修改代码。看起来已经有人替我们检查过了,但接下来仍有几个问题:这些问题真的存在吗?修改会不会改变需求?没有评论的地方,是否就没有风险? **Code Review是对代码变更进行检查与讨论的活动;AI Code Review是其中一种辅助方式,人工代码审查则由开发者结合需求与工程背景进行判断。** 它们可以处于同一条工作流中。AI产生候选发现,开发者核对事实和影响,再用适当的检查验证修改,并按项目规则决定是否合并。 这篇文章不做工具排行榜,也不声称“AI一定更准”或“人工一定不会漏”。文中分别标明通用工程原则、具体产品行为和原创示例;示例只在本地离线运行,不冒充商业AI工具的实测报告。公开资料核对日期为2026年10月27日。 ## Code Review检查什么:从代码能运行到变更值得合并 代码能通过编译,只能回答一部分问题。审查还要看需求是否得到正确实现、边界是否处理、模块职责是否清楚,以及改动会给后续维护带来什么影响。 [Google的审查标准](https://google.github.io/eng-practices/review/reviewer/standard.html)把长期代码健康作为核心目标,并没有要求每次改动都达到抽象的“完美”。[其审查清单](https://google.github.io/eng-practices/review/reviewer/looking-for.html)覆盖设计、功能、复杂度、测试、命名和文档等内容。一个符合格式规范却破坏业务规则的补丁,仍然可能不该合并。 [Google的现代代码审查案例研究](https://research.google/pubs/modern-code-review-a-case-study-at-google/)也从组织实践、动机与挑战研究这项活动。这里引用其研究背景,不用某一家公司的历史实践代表所有团队。 审查时需要区分三类信息: - **需求和约束**:这次要解决什么,哪些已有行为不能改变? - **变更和依赖**:改了哪些代码,哪些调用方、数据结构或配置会受影响? - **验证证据**:做过哪些检查,覆盖什么条件,还有什么没有确认? 审查意见只有落到这些信息上,才有机会从“听起来合理”变成可处理的问题。 ## AI与人工如何分工:能力重叠,责任需要明确 AI可以协助解释diff、查找可疑分支、提示缺失测试和整理审查意见。人工也会做这些事情,但更需要负责核对业务意图、跨模块影响及取舍依据。这里的分工是工作流建议,不是对所有模型和开发者能力的固定排名。 | 维度 | AI辅助审查可承担的工作 | 人工应重点核对的内容 | | --- | --- | --- | | 局部逻辑 | 提出空值、条件分支、资源处理等疑点 | 触发条件是否成立,调用链是否已有保护 | | 需求与设计 | 依据提供的文档检查一致性 | 文档是否准确,取舍是否符合当前业务 | | 测试 | 建议输入组合、边界场景和检查方法 | 测试是否表达真实需求,是否遗漏关键路径 | | 反馈处理 | 汇总问题、起草修补建议 | 是否采纳、如何修改及影响范围 | | 合并决定 | 提供评估或平台允许的审查动作 | 明确授权规则、验证标准与维护责任 | 不要把“AI看过代码”写成“代码已经安全”。[GitHub的责任使用说明](https://docs.github.com/en/copilot/responsible-use/agents)明确列出漏报、误报与不正确修改建议等限制,并建议认真复核和测试。它支持“输出需要核对”这个判断,不提供所有AI工具的统一准确率。 研究也应按范围理解。2024年的[AutoCommenter论文](https://research.google/pubs/ai-assisted-assessment-of-coding-practices-in-industrial-code-review/)研究了工业环境中的语言最佳实践检查,涉及C++、Java、Python和Go。本文核对了作者机构的摘要与出版入口,没有复现其系统;这一研究不能证明任意模型能替代完整的业务设计审查。  工作流建议示意:职责可以重叠,任何一层都不能单独证明代码没有缺陷;不表示工具能力排名。 ## 上下文决定审查质量:只有diff往往不够 看到一行删除代码,AI或人工都可能缺少判断所需的信息。删除的是重复校验,还是调用链中最后一道校验?一个看似冗余的兼容分支,是历史包袱,还是仍在支持旧客户端? 提供上下文时,可以优先补齐变更目的、验收条件、相关调用方、配置约定和已做的测试。无需不加选择地上传整库,尤其不能将凭据、生产数据或不被允许外发的私有材料放进提示词。 [GitLab Duo非Agent式代码审查文档](https://docs.gitlab.com/user/gitlab_duo/code_review/)列出了该功能使用的合并请求描述、diff、文件内容及自定义指令,并说明大请求重试时可能减少上下文。这个产品实例说明:工具“审查了MR”,不代表它始终拿到了同样完整的信息;不能将它外推为所有Agent式工具的统一工作方式。 把改动拆成目的明确的小单元,也有助于理解。[Google关于小变更的指导](https://google.github.io/eng-practices/review/developer/small-cls.html)强调自洽、便于理解的改动。实际操作中,应尽量将机械格式化与行为修改分开,避免一个PR同时改接口、迁移数据、重构目录,又调整业务规则。 一段可复用的审查请求可以这样写: ```text 目标:检查本次变更是否违反列出的需求,不直接修改代码。 上下文:变更目的、允许输入、兼容要求、相关调用方和已做检查。 输出:文件位置、触发条件、预期/实际差异、影响、验证办法。 约束:区分确认问题与待核实疑点;证据不足时说明缺什么。 对同一根因合并报告,不把个人风格偏好当作阻塞问题。 ``` 这份模板是本文的工程建议,不保证模型遵循,也不代替审查结果的验证。 ## 一个小例子:把审查意见变成可验证的发现 假设某个配置允许:`None`表示使用默认超时30秒,`0`表示不等待,正数表示具体等待秒数。输入类型和合法范围由上游校验;这里仅检查默认值语义。 ```python def effective_timeout(value): return value or 30 ``` 候选审查意见是:“当value为0时,函数返回30,改变了不等待的语义。”这条意见之所以值得处理,不是因为它由AI还是人工提出,而是因为可以给出完整证据: | 项目 | 内容 | | --- | --- | | 前提 | 本例明确允许0,并约定0表示不等待 | | 触发输入 | `effective_timeout(0)` | | 预期结果 | 0 | | 实际结果 | 30 | | 修改方向 | 只在输入为None时使用默认值 | 针对该约定,可以改为: ```python def effective_timeout(value): return 30 if value is None else value ``` 本地检查了`None`、`0`、`1`、`30`四个输入:修改前,0这一项违背约定;修改后,四项结果符合本例约定。代码与离线验证脚本随素材保存。这只是人为设计的最小例子,不是某个真实项目故障,也不是AI产品的检出率测试。 如果业务规定0是非法值,而且上游已经拒绝0,那么同一条审查意见就需要重新判断。可见,**代码位置、需求前提、触发输入和实际影响缺一不可。** 仅仅说“这里应该改成is None”,还不能自动升级为阻塞合并的问题。 ## 如何处理误报和漏报:不按评论数量判断质量 误报会消耗核对时间,漏报则意味着风险没有被指出。没有评论只能说明本轮没有产出发现,不能证明不存在缺陷;评论很多也可能只是重复、风格偏好或对上下文的误解。 可以把每条发现先分类: | 分类 | 处理方式 | | --- | --- | | 可复现且违反约定 | 确认影响,修复并补充适当验证 | | 触发条件尚不明确 | 补查调用方、输入约束或运行证据 | | 已有保护或判断有误 | 说明依据后关闭,不为迎合评论而改代码 | | 可选改进或风格建议 | 按项目规范处理,避免与正确性混为一谈 | 修补代码也应重新审查。一个能消除报错的修改,可能吞掉异常、破坏兼容性或扩大行为范围。尤其当同一个AI既生成代码又审查代码时,不应把角色切换当作获得了独立证据;仍要重新检查需求、相关实现和运行结果。 如果要评估工具是否值得长期使用,可以记录确认发现、误报、重复意见、人工核对时间,以及事后发现的遗漏。统计时写清项目、样本、版本与判断方法。只有“已确认问题”这类分母时,通常还不足以算出完整召回率;不要凭一次顺利体验给出通用百分比。 ## 协作流程:AI初审、人工复核、验证后决定合并 我更推荐把AI安排在容易复核、反馈能形成闭环的位置: 1. **作者自查**:说明变更目的、需求约束和影响范围,运行适当的格式、静态检查与测试。 2. **AI初审**:提供相关上下文,要求输出带位置、条件和证据的候选发现。 3. **人工复核**:核对真实问题,补查设计和业务边界,将误报与可选改进分开处理。 4. **修改与验证**:修复确认的问题;对行为变化补充必要的验证,检查补丁是否引入新问题。 5. **最终审查与合并**:针对最终提交核对未解决发现、CI结果、兼容及回滚条件,再按项目权限规则合并。 这里“验证后”并不意味着所有改动一律跑完整测试。修改文档、局部逻辑、数据库迁移与并发控制,所需证据不同。检查要与变更风险匹配,测试通过也不等于需求、设计和所有运行条件都已证明正确。 还要区分平台动作与工程判断。核对当日的[Copilot使用文档](https://docs.github.com/en/copilot/how-tos/use-copilot-agents/use-code-review)说明,概览中的批准评估本身不计入合并要求;若启用处于公开预览的审批功能,Copilot可以提交按配置计入要求的批准。因此不能笼统写成“AI永远不能Approve”,也不能将平台允许合并等同于变更已被全面验证。团队仍须明确哪些变更需要人工复核和谁承担维护责任。  协作流程示意:审查意见需要核实,修改后应针对最终提交验证;不是所有平台强制采用的审批流程。 ## 常见问题:AI审完了,还需要人工看吗 ### 小改动是否可以完全自动合并 这应由项目针对变更类型、检查质量和回滚能力制定规则。受控的低风险更新与涉及鉴权、数据迁移、并发状态的改动,需要的审查证据不同。本文不提供一个适用于所有仓库的自动合并开关。 ### 人工复核是不是把AI的评论再读一遍 复核需要追到需求与代码证据,必要时独立检查AI没有评论的关键路径。把建议全部照单修改,或看到“未发现问题”就直接合并,都没有完成这一步。 AI的价值可以体现在更早提出值得检查的问题、减少机械整理,让人有更多精力判断上下文。最终应衡量的是发现是否成立、修改是否正确,以及这次变更是否达到项目约定的合并条件。 ## 参考资料 以下8项为2026年10月27日核对的公开一手资料。同一机构的工程文档与研究不视为多次独立效果验证;产品说明不作为通用性能排名依据。 1. [Google:The Standard of Code Review](https://google.github.io/eng-practices/review/reviewer/standard.html),长期代码健康与审查标准。 2. [Google:What to look for in a code review](https://google.github.io/eng-practices/review/reviewer/looking-for.html),设计、功能、测试及相关检查维度。 3. [Google:Small CLs](https://google.github.io/eng-practices/review/developer/small-cls.html),自洽的小变更与审查工作流。 4. [GitHub:Copilot Agents责任使用说明](https://docs.github.com/en/copilot/responsible-use/agents),代码审查的漏报、误报及不准确建议等限制。 5. [GitLab:Duo Code Review(非Agent式)](https://docs.gitlab.com/user/gitlab_duo/code_review/),输入上下文与大请求处理边界;不混同其他审查产品。 6. [GitHub:Using Copilot code review](https://docs.github.com/en/copilot/how-tos/use-copilot-agents/use-code-review),审查与批准配置;预览功能可能继续变化。 7. [Google Research:AI-assisted Assessment of Coding Practices in Industrial Code Review(2024)](https://research.google/pubs/ai-assisted-assessment-of-coding-practices-in-industrial-code-review/),本文使用机构页面的摘要与出版入口,没有复现论文实验。 8. [Google Research:Modern Code Review: A Case Study at Google](https://research.google/pubs/modern-code-review-a-case-study-at-google/),传统现代代码审查的研究背景,本文仅核对机构页面摘要,不将历史案例外推为当前所有团队效果。 --- --- title: "快手 Web Cookie 与会话管理实践:跨页面登录状态异常排查" source: https://www.iowill.com/blog/2026/10/kuaishou-web-cookie-session-management/ date: 2026-10-26 updated: 2026-10-26 tags: [Cookie, Playwright, Python, 快手, 浏览器自动化] categories: [编程开发] --- # 快手 Web Cookie 与会话管理实践:跨页面登录状态异常排查 最初,这看起来只是一个 Cookie 导入问题:浏览器正常打开,文本没有解析报错,页面却仍然显示未登录。更换为主站登录后的 Cookie,账号能够进入;但在多账号切换、直播访问和跨页面任务中,登录状态又出现了不一致。 **Cookie 导入成功、浏览器带出 Cookie、目标页面确认登录,以及登录的是所选账号,是四个需要分别核对的结果。** 任何一步成功,都不能替后面的步骤作保证。 后续实际使用反馈带来了关键变化:**保持已登录的旧版首页打开,再在同一浏览器会话的新标签中访问新版推荐页、直播和创作者中心,该次测试均可正常保持登录。** 因此,ksDM 将浏览器任务拆成保留的基准首页和单独的任务标签。 本文记录这一排查过程及其工程实现。跨页面访问结果来自开发中的实际使用反馈;代码说明依据作者私有项目 ksDM 的固定版本(提交 `352bc24`),源码与开发记录未公开,读者无法通过公开仓库独立复核项目实现。本次成文在本地核对了该版本与通用文档,没有重新使用真实账号进行线上实验,也没有确认快手服务端的完整认证机制。 ## 问题起点:Cookie 来源与访问目标不一致 早期样本复制自快手创作者服务平台,自动化访问的却是主站。该样本导入后,主站依然显示未登录;更换为主站正常登录后的请求 Cookie,开发中反馈可以登录。这段过程已记录在[快手与抖音 Cookie 获取和使用差异案例](https://www.iowill.com/blog/2026/10/kuaishou-douyin-cookie-login-differences/)。 当时还观察到 HTTP 200 与业务响应 `{"result":109}` 同时出现。可以确认的是该样本未恢复目标主站登录,不能仅凭 HTTP 200 宣告成功,也不能把 `109` 当成所有快手业务统一的 Cookie 过期码。 到了后续阶段,观察条件发生了变化:起点是已经建立登录的浏览器会话,旧版首页持续打开,其他页面在同一会话的新标签中访问。 | 场景 | 观察结果 | 能支持的结论 | | --- | --- | --- | | 早期创作者平台样本直接导入主站 | 主站未登录 | 该样本、该流程没有恢复主站登录 | | 更换主站正常登录后的样本 | 主站登录成功 | 该次主站验证通过,其他任务仍需分别检查 | | 后续保留已登录首页,同会话新标签访问 | 反馈新版推荐页、直播和创作者中心正常 | 该会话及访问条件下,已测试页面可用 | 这些观察不矛盾。复制凭据的方向、已有状态和访问过程不同,不能混写成一次“所有页面通用性测试”。尤其不能把第三行改写为“任意主站 Cookie 文本都能直接登录所有子站”。 ### 跨页面结果记录:按页面列出反馈与证据缺口 2026年10月26日详细素材中的后续使用反馈如下。共同条件为:旧版首页已经登录并保持打开,目标页在同一浏览器会话的新标签中访问。这是对已有反馈的整理,不是本次重新执行的逐页验收。 | 目标页面 | 素材记载的访问结果 | 当前可提供的依据 | 尚缺少的验证信息 | | --- | --- | --- | --- | | 新版推荐页 | 正常保持登录 | 开发中的实际使用反馈 | 本轮对应的账号状态响应与逐页截图 | | 直播页面 | 正常保持登录 | 开发中的实际使用反馈 | 本轮最终页面路径与账号状态响应 | | 创作者中心 | 正常保持登录 | 开发中的实际使用反馈 | 本轮账号状态响应及跨业务跳转记录 | 现有素材没有完整列出这次跨页面观察的账号数量、浏览器版本与逐页测试时间,因此不补造这些字段,也不计算成功率。这张表让读者看到反馈覆盖哪些页面,以及哪些证据仍未提供;它不能证明保留首页一定是成功的唯一原因。 ## Cookie 请求头为什么不等于完整浏览器会话 开发者工具中复制的 Cookie 请求头,通常是一串名称和值: ```http Cookie: session_example=VALUE_A; device_example=VALUE_B ``` 以上名称和值均为虚构。这样的文本不包含原始 Domain、Path、Expires、HttpOnly 等存储属性。浏览器先按照适用规则选择 Cookie,再将名称和值写入请求头;复制这段文本,无法反推出完整的原始存储记录。[MDN](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Cookies)解释了 Cookie 的发送范围与访问限制。 同名 Cookie 尤其容易被忽略。不同 Domain 或 Path 下可能存在同名项;[RFC 6265 §4.2](https://httpwg.org/specs/rfc6265.html#cookie)明确指出,请求头不会携带那些存储属性,服务端也不应依赖同名项的序列顺序。 本次核对的 ksDM 有一个应当公开说明的边界:保存捕获文本时保留原文,但重新导入文本的 `browser_cookies` 按名称构建字典,后出现的同名项覆盖前项,并补充 `.kuaishou.com` 和 `/`。所以,**原文保存与无损恢复原始 Cookie 存储,是两件事。** 这描述的是当前客户端适配方式,不是快手规定的凭据格式。 浏览器认证还可能涉及其他状态。[Playwright 认证文档](https://playwright.dev/python/docs/auth)列出了 Cookie、localStorage、IndexedDB 等认证状态,并单独讨论 sessionStorage。具体网站依赖什么,需要现场证据,不能把文档列举的存储全部说成快手已确认的登录依赖。 因此,Cookie 文本可以作为导入快照;账号持久浏览器目录用于复用浏览器状态。二者用途有交集,却不能互相替代。持久目录也不保证令牌永不过期、服务端永不撤销登录。  结构示意:Cookie文本不携带全部存储属性,不能由此无损还原认证环境;图中字段均为虚构。 ## 捕获实际请求,还要核对当前账号身份 排查时,Network 中出现过两条末段都叫 `get` 的请求: ```text GET https://www.kuaishou.com/rest/v/profile/get POST https://www.kuaishou.com/rest/v/kconf/get ``` 这里省略了查询参数。它们不是同一个接口,也不能只凭列表中的 `get` 名称选择捕获对象。当前项目使用前者作为账号请求 Cookie 的捕获来源;后者没有承担这个角色。材料不足以进一步宣称后者永不鉴权,或永远不带 Cookie。 ### 精确匹配请求,避免保存错误来源 `RequestCookieSnapshot` 在导航前安装到浏览器上下文,请求筛选条件包括 HTTPS、允许的主机、完整路径 `/rest/v/profile/get` 和 GET 方法,然后读取 `request.header_value('cookie')`。查询参数不参与路径匹配,不把某次请求的动态签名 URL 写死为长期入口。 [Playwright Request API](https://playwright.dev/python/docs/api/class-request#request-header-value)提供单个请求头的读取方法;普通 `request.headers` 不返回包括 Cookie 在内的部分安全相关请求头,不能据此直接判断浏览器没有发送 Cookie。页面脚本的 `document.cookie` 又受 HttpOnly 等约束,同样不等于完整导出。 当前实现每收到一个匹配请求,先清空旧捕获,再尝试读取。若最新匹配请求为空或读取失败,就不拿更早的值冒充最新结果;无关请求则不覆盖捕获。 ### 空值有限重试,失败不覆盖原记录 如果完成身份确认和主页资料读取后,仍未捕获非空请求头,当前流程只刷新该账号主页一次,再有限等待延迟请求。代码中的导航上限为25秒,随后最多等待3秒、每200毫秒检查一次。这些是项目参数,不是平台要求。 刷新后还要重新核对快手号与主页 URL。未捕获、身份变化、读取失败或用户取消,都不能生成可保存的成功结果。2026-10-22的修改还移除了从 Cookie 库拼接字符串的导出兜底,避免将拼接结果冒充实际请求原文;这不表示 Cookie 库本身没有合法用途。 捕获非空请求头仍然只证明请求带了 Cookie。账号验证需要从当前账号入口进入自己的主页,读取昵称、快手号和主页地址,与所选账号对照。不能只取推荐卡片中的第一个头像,也不能仅凭 Cookie 中的 `userId` 判断身份。 ## 多账号隔离:两个无痕窗口并不够 开发中曾遇到两个账号总有一个表现异常,随后发现 Cookie 来自同一 Chrome 中的不同无痕窗口。 [Chrome 官方说明](https://support.google.com/chrome/answer/95464?hl=en)指出,在已有无痕窗口中再打开一个无痕窗口,会继续同一次无痕会话;需要关闭所有无痕窗口才结束它。因此,“两个窗口”不能作为“两个独立账号环境”的证据。 这能解释隔离方法为什么不可靠,却不能单独证明某次异常一定由另一个账号登录造成。还要检查取样时机、文本导入损失和服务端会话变化。 ksDM 为不同账号使用独立浏览器数据目录,新建账号或导入时先建立候选目录,验证身份后再提交为正式记录。昵称与备注用于显示,不决定目录归属;发现实际身份与预期不一致时停止任务。 [Playwright 持久上下文文档](https://playwright.dev/python/docs/api/class-browsertype#browser-type-launch-persistent-context)说明,`user_data_dir` 保存 Cookie、localStorage 等会话数据,多个浏览器实例不能同时使用同一个用户数据目录。这里应使用独立的自动化目录,避免直接接管日常 Chrome 主配置目录。 已有账号复用时,也不应每次清空全部状态再注入旧文本。当前 `restore_missing_cookies` 只按规则补入缺失且适用的字段,不覆盖已有同名项,并跳过已过期项。这是恢复启发式规则,字段存在仍不代表服务端接受它,之后还须验证身份。 ## 关键调整:保留基准首页,任务在新标签执行 2026-10-24的方案已要求先进入旧版首页核对身份,但后续导航仍可能在同一标签中覆盖首页。2026-10-26的实际使用反馈进一步指出:保持该首页登录并打开,在同一浏览器会话的新标签访问其他页面,结果正常。 本案例的旧版首页入口是: ```text https://www.kuaishou.com/?isHome=1&source=NewReco ``` 于是,实现不再只改变初始 URL,而是明确分离两个标签的生命周期: ```text 账号 A 的独立浏览器上下文 ├─ 基准标签:已核对身份的旧版首页,任务期间保留 └─ 任务标签:推荐页、目标主页或其他业务页面 账号 B:使用自己的上下文与目录,不复用账号 A 的环境 ``` [Playwright Pages 文档](https://playwright.dev/python/docs/pages)说明,一个 BrowserContext 可包含多个 Page。共享上下文让同账号标签使用相应浏览器环境,但不会让不同来源的全部存储无条件互通,也不会自动完成目标站点的业务认证。  实现结构示意,非实测截图:任务期间保留基准标签,结束后清理;不代表已确认快手服务端认证机制。 ### 基准页核对与任务页创建分别负责什么 `enter_base_page` 访问基准首页、读取当前账号入口,并与预期主页地址比较。`new_task_tab` 检查基准标签仍然存在,必要时恢复首页,再创建新的任务页。如果前面的入口交互已将基准标签带到个人主页,不能直接把该页当作仍在打开的首页。 基准页关闭、恢复失败、地址发生非预期跳转或用户取消时,不继续启动目标任务。恢复后的 URL 检查只是入口检查,不能写成“再次完整证明后台认证状态”。上述行为依据作者对私有项目固定版本 `session.py` 的本地核对。 ### 保留标签的时间以任务生命周期为限 基准首页在任务运行期间保留。任务结束、失败或取消后,仍按原有清理逻辑关闭上下文及程序拥有的驱动;定时任务等待下一轮时,不因此永久挂着浏览器。 “打开主页”还需要以目标标签关闭作为结束条件,不能因为基准标签仍开着,就一直等待用户退出整个浏览器。双标签解决的是执行期间页面职责的组织,也必须同时处理退出行为。 这一做法在本案例下有可用性反馈,但底层原因尚未确定。站内认证衔接、页面初始化、本地状态更新或后台请求都只是候选解释。没有对照证据,不能声称首页周期性刷新了全站令牌,或关闭首页必然立即让其他页面退出登录。 ## 按故障阶段排查,避免把超时都归为 Cookie 失效 在一次双账号任务里,一个账号在身份核对阶段超时,另一个继续执行推荐页检查。日志只能证明前者未能按时完成核对,不能直接改写为“Cookie 已过期”。同样,任务异常计数不等于失效账号计数。 ### 脱敏日志:身份核对超时与后续任务进度 以下节选自详细素材保留的开发日志。账号显示名已替换为 A、B;片段保留原有时间与消息,不含 Cookie 值、账号 ID、头像地址或签名参数。素材未给出该片段的明确发生日期,不能把时分秒解释为2026年10月26日的实测时间。它属于较早的推荐页核对流程,也不是双标签方案的成功日志。 ```text 15:44:52 开始养号 · 2 个账号 15:44:53 [账号 A] 正在启动独立浏览器… 15:44:53 [账号 B] 正在启动独立浏览器… 15:44:53 [账号 A] 正在打开快手新版推荐页并核对登录身份… 15:44:53 [账号 B] 浏览器目录缺少会话 Cookie,已从所选账号保存记录补入;未覆盖已有 Cookie 15:44:53 [账号 B] 正在打开快手新版推荐页并核对登录身份… 15:44:55 [账号 B] 正在打开快手推荐页… 15:44:58 [账号 A] 浏览器验证失败(核对养号账号):操作超时,请检查网络或页面加载情况 15:44:59 [账号 B] 已确认连播开启 ``` 片段可支持两个有限判断:账号 A 的流程在身份核对阶段报超时,账号 B 继续到了推荐页连播检查。它没有给出账号 A 的登录业务响应,不能由此确认凭据失效;账号 B 的补入消息也只说明程序报告执行了恢复动作,不能替代后续身份验证。 ### 按层记录结果,再决定是否重新登录 可以按以下顺序保留证据,越过哪一层,就记录哪一层的实际结果: | 排查层次 | 核对内容 | 结果应如何解释 | | --- | --- | --- | | 浏览器启动 | 可执行文件、目录锁、权限与实际异常 | 未启动时,还没进入登录有效性判断 | | 页面与网络 | 最终 URL、连接失败、挑战页、控件可操作性 | 超时可能来自不同环节,先定位阶段 | | 凭据与请求 | 来源业务、目标请求、是否有非空 Cookie | 请求携带凭据不代表服务端认可 | | 业务登录 | 账号响应与页面登录入口 | HTTP 200不能替代业务验证 | | 身份一致性 | 当前主页与所选账号是否一致 | 不符就停止,不覆盖为成功记录 | | 页面生命周期 | 基准页是否保留、目标页是否独立 | 记录操作条件,不直接推断服务端机制 | 诊断日志应保留任务、阶段、异常类型、脱敏后的路径,以及是否捕获 Cookie、是否通过身份核对等状态。依据本地核对的私有项目 `diagnostics.py`,当前实现也保存受限范围的失败页面材料,但没有自动截图。 不要把真实 Cookie 写入日志来证明已导入,完整签名 URL、账号标识、原始 DOM 和浏览器目录也不适合作为博客附件。自动脱敏之后,公开前仍需人工检查。 ## 事后复盘:哪些结果可确认,哪些需要继续验证 此次工程调整最有价值的地方,是将保存、捕获、登录、身份和跨页面使用拆开验证,并将基准页与任务页分离。 证据也要按来源分开: - **实际使用反馈**:保留已登录旧版首页、同会话新标签访问时,该次测试的推荐页、直播和创作者中心正常。 - **固定版本代码检查**:实现了请求筛选、有限重试、身份核对、独立目录和基准/任务双标签。 - **历史离线测试**:开发记录包含账号验证、推荐页、主页监测与评论采集的离线检查,重点覆盖独立标签、失败停止和资源清理;这些不是本次成文重新运行的结果。 - **仍待验证的机制**:首页是否触发了特定状态更新、关闭首页的影响及其时间尺度、跨重启表现,以及不同账号和业务入口的差异。 历史测试使用临时目录、虚构账号与请求拦截,可以检查是否创建两个标签、失败时是否停止、退出时是否清理;不能证明快手线上认证机制,也不能代替真实直播或创作者中心复测。本文以测试覆盖范围说明工程验证,不将内部用例总数作为线上登录可靠性的证明。 后续若要判断保留首页是否为必要条件,需要补充对照实验,而不是只重复成功路径: | 组别 | 操作条件 | 重点记录 | | --- | --- | --- | | A | 新环境导入文本,直接访问目标页 | 最终跳转与目标账号状态 | | B | 先登录首页,在同标签转到目标页 | 与直接访问的差别 | | C | 保留已登录首页,新标签访问目标页 | 与覆盖首页的差别 | | D | C成功后关闭首页并持续观察 | 立即、延迟或没有变化 | | E | 正常关闭上下文,再使用同目录重启 | 持久化恢复与重新验证结果 | 这张表是后续计划,没有补造实验结果。各组应使用受控的独立目录或副本,记录账号、网络、浏览器版本和时间条件,并分别检查推荐页、直播与创作者中心。即使观察到 Cookie 值发生变化,也还需要证明该变化与目标页登录之间的联系。 是否需要重新登录,应根据验证失败的环境、页面与阶段判断。只有当排查粒度足够细,才能分辨真正的凭据失效、账号环境混用,以及页面执行方式带来的差异。 ## 参考资料 以下7项为可公开访问的通用资料,于2026年10月26日查阅,用于解释浏览器与自动化行为,不构成快手私有认证协议说明。 1. [MDN:Using HTTP cookies](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Cookies),Cookie 作用域、属性与 JavaScript 访问限制。 2. [RFC 6265 §4.2:Cookie](https://httpwg.org/specs/rfc6265.html#cookie),请求头语义、缺失的存储属性与同名 Cookie 顺序边界。 3. [Playwright Python:Authentication](https://playwright.dev/python/docs/auth),认证状态复用及 sessionStorage 单独处理。 4. [Chrome:Browse in Incognito mode](https://support.google.com/chrome/answer/95464?hl=en),多个无痕窗口的会话关系。 5. [Playwright Python:Request.header\_value](https://playwright.dev/python/docs/api/class-request#request-header-value),读取请求头及普通 headers 的限制。 6. [Playwright Python:BrowserType.launch\_persistent\_context](https://playwright.dev/python/docs/api/class-browsertype#browser-type-launch-persistent-context),持久目录用途与并发使用限制。 7. [Playwright Python:Pages](https://playwright.dev/python/docs/pages),同一上下文中的多个页面。 ### 作者自有案例材料(未公开) - ksDM `session.py`,固定版本352bc24:Cookie 捕获、解析、身份检查与任务标签实现。 - 同版本 `diagnostics.py`:调试事件与失败页面材料。 - 同版本 `docs/DEVELOPMENT.md`:历史需求、用户观察及离线验证记录。 以上三项属于同一私有项目的本地材料,用于说明作者案例的依据,不计为公开参考链接或独立复现实验。正文提供了脱敏日志节选、分页面反馈记录及双标签结构示意;日志仅说明所记录的执行进度,反馈表保留证据缺口,结构示意用于解释实现,不冒充实际浏览器截图。本文未公开项目完整源码、浏览器状态文件或真实凭据。 --- --- title: "DeepInfer 是什么?DeepSeek 如何优化大模型推理效率" source: https://www.iowill.com/blog/2026/10/deepinfer-deepseek-inference-efficiency/ date: 2026-10-26 updated: 2026-10-26 tags: [DeepInfer, DeepSeek, 大模型推理, 性能优化] categories: [软件与工具] --- # DeepInfer 是什么?DeepSeek 如何优化大模型推理效率 向大模型发送一个问题,等待通常分成两段:先等它开始输出,再等它把回答生成完。遇到长文档、长回答或高峰期,这两段等待还可能以不同方式变长。 DeepInfer关注的正是这些计算背后的执行效率。**它是DeepSeek开源的推理框架:围绕模型执行,协调计算内核、设备通信和任务调度,让已有硬件更有效地完成推理工作。** 它本身不会因为运行得更快,就让同一组模型权重学会新的知识。 本文以2026年10月26日核对的[官方README](https://github.com/deepseek-ai/DeepInfer/blob/553741557a57df44a46fb3ab72b6aafeaf945337/README.md)及问答为项目依据,结合原始论文与技术文档解释机制,不包含安装步骤或作者性能实测。DeepInfer资料固定在提交`553741557a57`,避免把后续变化混入当前说明。 ## DeepInfer与模型、在线服务分别负责什么 模型、推理框架与在线服务承担不同职责: | 层次 | 主要职责 | 可以怎样理解 | | --- | --- | --- | | 模型 | 依据结构、权重和输入计算输出分布 | 决定当前模型具备怎样的能力 | | 推理框架 | 执行模型计算,安排批次、内存与并行任务 | 组织这些计算怎样完成 | | 在线服务 | 接收请求,提供路由、鉴权、限流与服务保障 | 让用户能够稳定调用 | 三者会相互影响,但不能互相替代。读到“模型开源”“推理框架开源”或“提供API”时,首先应确认说的是哪一层。 在本文核对版本中,DeepInfer列出的支持模型为DeepSeek-V4.1-Flash,公开内容提供离线推理及相关核心能力。README也单独列出了完整服务还需要补齐的系统组件。因此,不能把官方问答里的全部生产系统能力,都直接算作公开仓库已经交付的功能。 ## 为什么读问题与生成回答会有不同瓶颈 理解推理效率,要先认识两个阶段。 **Prefill负责处理输入上下文。** 例如输入一篇长文档时,模型需要计算各位置的表示,并准备后续生成会用到的状态。由于输入内容已经给定,许多位置的计算可以组织成较大的并行任务;这与“不知道后面会生成什么”的情况不同。 **Decode负责继续生成输出。** 在普通自回归生成中,下一个token依赖已有上下文和刚生成的内容,因此同一条回答存在逐步推进的依赖。token是模型处理文本的单位,并不固定等于一个汉字或一个单词。 这两段计算都可能受到算力、显存访问、通信等因素限制。较长输入常增加Prefill工作量;小批次Decode则可能更容易受到搬运权重、读取缓存等开销影响。随着并发、上下文和硬件变化,主要瓶颈也会变化,不能把所有Decode一概称为“只受显存带宽限制”。 [NVIDIA的推理基准说明](https://developer.nvidia.com/blog/?p=98215)还提醒:用户感受到的首个token等待时间不仅包含Prefill,也可能包含排队、网络和其他处理开销。因此,首字慢不一定是模型计算本身慢。  图1:Prefill与Decode承担不同计算任务;图中编号仅示意阶段内的生成顺序,不编码实测耗时。 ## 计算内核:让数据搬运和矩阵计算更有效率 推理过程中会反复执行矩阵乘法、注意力等操作。硬件标称算力很高,也不意味着每一种计算形状都能充分利用它:数据布局、批次大小、中间结果存放位置和算子衔接,都可能影响实际耗时。 DeepInfer列出的底层组件包括DeepGEMM、FlashMLA和DeepEP等。这里可以先抓住一个原则:优化不仅是“多做并行计算”,也包括**减少不必要的数据搬运,并让计算形状更适合硬件**。 [FlashAttention原始论文](https://arxiv.org/abs/2205.14135)提供了一个有代表性的例子:通过分块组织注意力计算,减少GPU不同存储层级之间的读写。它说明,数学任务相同,执行方法不同,时间和内存开销仍可能不同。这里借用的是通用原理,不能把FlashAttention与DeepInfer所用的FlashMLA当作同一个实现。 在MoE模型中,不同专家收到的token数量也可能不同。[DeepGEMM文档](https://github.com/deepseek-ai/DeepGEMM)介绍了面向专家计算的分组矩阵乘法布局。这样的优化针对具体计算形状和数据组织,并不是给任意模型加上一个“提速开关”。 ## 专家并行:计算分出去以后,还要把数据送对地方 MoE可以理解为:模型中有多个专家子网络,路由机制让token交给其中选定的专家处理。“专家”在这里是计算模块,不是若干个独立聊天机器人。 当专家分布在不同设备上时,一次计算往往包含数据分发、专家计算和结果合并。设备更多,既增加了可用计算资源,也增加了组织通信的要求。 [DeepEP官方说明](https://github.com/deepseek-ai/DeepEP)将MoE的dispatch和combine列为专家并行通信的重要操作。可以把它理解成:任务分出去之前先送到正确位置,做完以后再把结果汇合。只计算专家内部的耗时,可能遗漏这两段成本。 此外,负载不均衡也会拖慢整体进度。某些专家很忙、另一些设备很空时,关键路径仍可能被最慢的一方决定。专家负载均衡与更高效的通信,都是让并行真正产生收益的条件。 因此,阅读DeepInfer的专家并行设计时,更值得问的是:什么工作被分散了,哪些数据必须交换,最忙的设备是否决定了等待时间?仅看设备数量,回答不了这些问题。 ## 异步调度:让CPU安排工作时,GPU继续计算 推理不只是GPU运行模型。CPU还需要维护请求状态、决定下一批处理哪些序列,并接收生成结果。 若这些步骤严格串行,GPU做完一轮后,可能还要等CPU整理结果、安排下一轮。这段时间里,计算设备未必有足够工作可做。 [DeepInfer官方问答](https://github.com/deepseek-ai/DeepInfer/blob/553741557a57df44a46fb3ab72b6aafeaf945337/doc/inference_deployment_qa.md)描述的异步调度,将CPU调度与设备执行重叠起来:当前轮计算推进时,CPU准备后续工作,缩短两轮之间的空档。 这里减少的是等待,不代表模型中的矩阵乘法天然变快,也不代表CPU工作消失了。官方使用的“zero-overhead batch scheduler”名称,应结合其流水线目标理解,不能外推成整个服务没有调度或同步成本。 批处理则解决另一个相关问题:让多条请求共享一轮计算,提高资源利用率。但批次越大未必越好,等待凑批、内存占用和请求间干扰都可能影响延迟。[PagedAttention论文](https://arxiv.org/abs/2309.06180)讨论了KV缓存管理如何限制可承载批次,这可作为理解批处理与内存关系的背景,并非证明DeepInfer采用了该论文的全部机制。 ## 草稿验证:一次主模型计算能否推进更多token 普通生成按依赖关系逐步推进。推测解码换了一个思路:先用更便宜的路径提出若干候选token,再交给目标模型验证;被接受的候选可以一次推进多个位置。 这不是直接把草稿展示给用户。收益取决于候选有多少能被接受,以及生成草稿、验证和处理回退各要花多少时间。若候选经常被拒绝,额外工作就可能抵消收益。 DeepInfer中的DSpark进一步涉及“验证多少草稿”的选择。官方问答描述了利用置信估计分配验证预算的方式:有限的计算不一定平均花在每个候选上,而是考虑预计能接受多少内容以及硬件的处理效率。 [ICML 2023的推测解码论文](https://proceedings.mlr.press/v202/leviathan23a.html)展示了在其算法条件下保持目标采样分布的做法。但这不意味着任意带“草稿”或“置信度”字样的实现,都自动获得同样保证;分布一致也不等于每次运行都会生成逐字相同的文本。 分析具体系统时,仍需核对验证规则、采样参数、数值精度与复现条件。 ## 缓存与有界重放:减少重复工作,但要分清代价 ### KV缓存复用的是中间状态 普通自回归注意力在生成新token时,会再次使用已有上下文对应的Key和Value。KV缓存把这些中间结果保留下来,避免每一步都重新计算已有部分;[Hugging Face文档](https://huggingface.co/docs/transformers/main/en/cache_explanation)对此给出了逐层解释。 它不是“把整道题的最终答案存起来”。新问题即使能复用部分上下文状态,仍可能需要新的计算和生成。 复用也有条件:输入前缀及相关执行状态需要兼容,缓存还会占用容量。缓存命中后是否值得读取,要结合传输与重新计算的代价判断。上下文长度、并发数增加时,缓存管理本身也可能成为压力来源。 ### SWA有界重放包含近似恢复 DeepInfer还提供SWA有界重放。SWA指滑动窗口注意力;“重放”是重新计算一段内容,以恢复后续执行需要的状态。 官方问答说明,有界重放只重算最近一段内容,并限制重放段内的注意力范围,得到近似的SWA缓存。它减少了恢复状态需要的工作量,但不能简单写成“与完整重算严格等价”。这与前文介绍的精确注意力执行优化,是不同性质的处理。 这里也不意味着随意删除用户输入。它依赖特定模型结构、状态布局与边界条件,效果要结合任务评估,不能照搬为所有模型都适用的技巧。 ### 单次生成缓存与跨请求缓存系统不同 单次生成过程复用KV、重复前缀跨请求复用,以及跨节点保存和调取缓存,属于不同层次。 公开框架包含相关引擎机制,不等于完整生产缓存系统已经一并公开。本文只解释减少重复计算的思路,不把内部系统的全部缓存能力算成公开代码的开箱即用功能。  图2:不同优化机制对应不同瓶颈;有界重放的近似状态不能与精确计算优化混为一谈。 ## 推理更快,是否意味着模型更聪明 通常不能这样判断。同一模型的执行效率提高,首先改变的是完成计算所需的资源与时间,不会自动增加模型已经学到的知识。 但“优化执行”也不能一概等同于“所有输出完全不变”。可以区分三种情形: | 优化性质 | 阅读时应追问的问题 | | --- | --- | | 调整内核与执行安排 | 数值精度、计算顺序和复现条件是否一致? | | 借助候选与验证减少串行工作 | 采用什么接受规则,是否有分布保持条件? | | 用近似状态减少重算 | 近似作用于哪里,质量评估覆盖哪些任务? | 更高效率可能为更长上下文、更多并发或更多推理预算创造空间,但是否将这些资源用于提高回答质量,仍取决于模型、产品和具体运行策略。 ## 吞吐量、首字延迟与生成速度应该怎样看 推理速度需要分别考察响应延迟、生成速度和吞吐等指标,不能只选一个数字代表全部体验。 | 指标 | 主要回答的问题 | 容易忽略的条件 | | --- | --- | --- | | 首个token延迟(TTFT) | 请求发出后,多久开始收到输出? | 排队、网络、输入长度与缓存命中 | | token间延迟(ITL) | 输出开始后,后续内容推进有多快? | 流式响应可能一次携带多个token,需看工具定义 | | 输出吞吐量 | 系统单位时间合计生成多少token? | 并发数、输出长度及统计时间窗口 | | 端到端延迟 | 从发出请求到接收完整回答要多久? | 前期等待和整个生成过程 | 这些指标可对照[NVIDIA的基准指标定义](https://docs.nvidia.com/deeplearning/triton-inference-server/archives/triton-inference-server-2670/user-guide/docs/perf_analyzer/genai-perf/README.html)。系统总吞吐量提高,不代表每个用户都更快;低并发下某条回答生成很快,也不保证高峰期仍有相同体验。 DeepInfer README中的Prefill与Decode图分别使用4块和64块SM100 GPU测量,不能忽略设备配置,更不能把两张图直接合成一次真实请求的完整耗时。比较之前,还应核对模型版本、上下文长度、缓存条件、并发、精度及草稿验证设置。 本文没有运行这些测试,也不据此宣称DeepInfer在任意硬件、任意任务上都领先其他框架。它更值得关注的地方,是把推理效率拆成一组具体问题:计算是否合适、数据怎样流动、设备为何等待,以及哪些工作可以复用或减少。 ## 参考资料 以下资料用于解释产品机制和通用原理;论文中的实验并不是对DeepInfer的独立性能复现。 1. [DeepInfer README(固定提交)](https://github.com/deepseek-ai/DeepInfer/blob/553741557a57df44a46fb3ab72b6aafeaf945337/README.md):项目定位、公开范围与基准环境。 2. [DeepSeek推理问答(固定提交)](https://github.com/deepseek-ai/DeepInfer/blob/553741557a57df44a46fb3ab72b6aafeaf945337/doc/inference_deployment_qa.md):异步调度、DSpark、SWA重放与生产系统说明。 3. [FlashAttention原始论文](https://arxiv.org/abs/2205.14135):注意力计算中的存储读写优化。 4. [DeepGEMM官方仓库](https://github.com/deepseek-ai/DeepGEMM):矩阵计算与专家分组计算布局。 5. [DeepEP官方仓库](https://github.com/deepseek-ai/DeepEP):专家并行的数据分发和结果合并通信。 6. [Fast Inference from Transformers via Speculative Decoding](https://proceedings.mlr.press/v202/leviathan23a.html)(ICML 2023):推测解码及其采样条件。 7. [How caching works](https://huggingface.co/docs/transformers/main/en/cache_explanation):KV缓存的作用与生成过程。 8. [Efficient Memory Management for Large Language Model Serving with PagedAttention](https://arxiv.org/abs/2309.06180):服务内存管理与批处理的关系。 9. [LLM Inference Benchmarking: Fundamental Concepts](https://developer.nvidia.com/blog/?p=98215):Prefill、Decode与延迟吞吐量概念。 10. [GenAI-Perf指标文档](https://docs.nvidia.com/deeplearning/triton-inference-server/archives/triton-inference-server-2670/user-guide/docs/perf_analyzer/genai-perf/README.html):具体测量指标与统计口径。 --- --- title: "Python 为什么适合 AI Agent?从工具调用到工作流编排" source: https://www.iowill.com/blog/2026/10/why-python-for-ai/ date: 2026-10-25 updated: 2026-10-25 tags: [AI Agent, MCP, Python, 工作流, 工具调用] categories: [编程开发] --- # Python 为什么适合 AI Agent?从工具调用到工作流编排 让模型解释一篇文章,只需要把内容交给它;让它查资料、读取草稿、检查链接,再根据结果决定下一步,就需要一套能执行动作、保存状态并处理失败的程序。 这也是理解 Python 与 AI Agent 关系的起点:**模型负责在给定上下文中生成回答或提出工具调用,Python 程序负责把这些调用接到实际系统,并管理整个执行过程。** Python 适合这类工作,主要因为函数容易封装成工具,现有库能连接文件、网络和数据服务,异步能力适合组织 I/O,框架也提供了状态与流程管理的支持。它的价值会体现在 Agent 的执行与编排环节,而不仅是调用一次模型接口。 ## AI Agent 与普通模型调用有什么区别 “Agent”没有所有产品共同遵循的唯一定义。讨论工程实现时,可按以下三种形式区分: | 形式 | 谁决定后续步骤 | 一个博客任务示例 | | --- | --- | --- | | 单次模型调用 | 应用只发起一次请求 | 输入文章,返回摘要 | | 固定工作流 | 程序预先规定步骤 | 读取草稿、检查链接、生成预览,按固定顺序完成 | | 具有工具能力的 Agent | 模型可根据结果选择后续动作,程序限制可执行范围 | 根据问题选择检索、读文件或查询状态,观察结果后继续或结束 | Anthropic 的工程文章用“预定义代码路径”和“模型动态决定流程与工具使用”区分工作流与 Agent。这是一个实用的架构划分,不是所有系统必须采用的命名标准。[Building effective agents](https://www.anthropic.com/research/building-effective-agents) 一个 Agent 可以嵌在固定工作流中:前面由模型选择资料,后面由程序强制执行格式检查;也可以在特定步骤等待用户决定。自主程度需要按任务设计。 ReAct 原始论文讨论了将推理与行动交替组织,并通过外部环境的观察更新后续行动的思路。这能帮助理解“行动后观察,再决定下一步”的循环;论文中的任务和结果不能直接代表某个博客助手的效果。[ReAct 原始论文](https://arxiv.org/abs/2210.03629) ## Python 在 Agent 的执行循环中负责什么 以“检查一篇草稿的资料是否完整”为例,模型可以提出读取草稿、检索资料或检查链接的请求。真正去读文件和发起 HTTP 请求的,是应用中的执行器,或相应的托管工具服务。 | 组件 | 主要职责 | | --- | --- | | 模型 | 理解当前任务,生成回答或结构化工具调用 | | Python 运行程序 | 整理上下文、调度模型、执行已允许的工具、记录结果 | | 工具 | 完成检索、读取、查询、写入等具体操作 | | 状态与存储 | 保存任务进度、工具结果和恢复所需的信息 | 程序通常需要反复执行“调用模型、检查返回类型、执行工具、回传结果”这一循环,同时判断任务是否完成或预算是否耗尽。模型返回一个工具名称,并不会让操作自动在服务器上发生。 这里必须保留一个边界:**工具调用是模型提出的请求,执行权限由应用决定。** 用户要求检查文章时,模型即使提出删除文件或发布页面,程序也不能仅凭这次输出扩大权限。  模型负责提出调用;程序检查范围并执行,工具结果回传后继续判断,达到预算上限则停止。 ## 为什么 Python 函数容易变成工具 Python 可以用普通函数把业务能力封装成小接口。例如,查询草稿状态可以是一段读取数据库或仓库元数据的函数;检索资料也可以封装为接收关键词、返回结构化结果的函数。 Agent 工具通常还要有名称、用途说明、输入结构和返回约定。在 LangChain 的工具接口中,函数注解可以参与定义输入结构,函数文档字符串可以用作工具描述。这减少了重复定义接口的工作,但具体规则属于框架能力。[LangChain 工具文档](https://docs.langchain.com/oss/python/langchain/tools) 需要特别注意:Python 的 `slug: str` 这类注解本身不强制运行时类型检查。模型输出中的参数仍应由执行程序检查,不能因为函数写了注解,就假定输入已经可靠。[Python 类型注解说明](https://docs.python.org/3.14/library/typing.html) 好的工具接口应该让模型和执行程序都容易判断: - **能力范围清楚。** `get_post_status` 只查询状态,修改和发布使用其他独立接口。 - **参数具体。** 用文章标识、查询词和数量上限表达意图,避免只有一个含义不明的自由文本参数。 - **结果可检查。** 返回找到、未找到、权限不足或失败等明确状态,并保留必要依据。 Python 简洁的函数与数据结构有利于快速修改这种接口;它对脚本和快速应用开发的支持,也适合早期逐步验证 Agent 的能力。[Python 官方教程](https://docs.python.org/3.14/tutorial/index.html) ## 一个可以运行的工具调用闭环 离线示例只使用 Python 标准库。**模型响应由 `demo_model` 模拟**,工具读取内存中的示例数据,不访问真实博客或外部 API。它展示的是执行器如何检查调用、运行工具、回传结果和结束任务,不是实际模型的决策效果。 ```python import json POSTS = {"python-agent": {"status": "draft"}} def get_post_status(slug: str) -> dict: """查询示例文章状态,不修改或发布文章。""" if not isinstance(slug, str) or not slug: raise ValueError("slug 必须是非空字符串") post = POSTS.get(slug) return {"found": post is not None, "status": post["status"] if post else None} def dispatch_tool(name, arguments): if name != "get_post_status": raise ValueError("未允许的工具") if not isinstance(arguments, dict) or set(arguments) != {"slug"}: raise ValueError("参数必须且只能包含 slug") return get_post_status(**arguments) def demo_model(messages): if messages[-1]["role"] == "tool": result = json.loads(messages[-1]["content"]) text = f"文章状态:{result['status']}" if result["found"] else "未找到文章" return {"type": "final", "text": text} return { "type": "tool_call", "id": "call_1", "name": "get_post_status", "arguments": {"slug": "python-agent"}, } messages = [{"role": "user", "content": "查询 python-agent 的状态"}] for _ in range(3): response = demo_model(messages) if response["type"] == "final": print(response["text"]) break if response["type"] != "tool_call": raise ValueError("未知响应类型") result = dispatch_tool(response["name"], response["arguments"]) messages.append({"role": "assistant", "tool_call": response}) messages.append({ "role": "tool", "tool_call_id": response["id"], "content": json.dumps(result, ensure_ascii=False), }) else: raise RuntimeError("达到最大轮数") ``` 运行结果是 `文章状态:draft`。把工具名改成未允许的名称、给出多余字段或传入错误的 `slug` 类型,执行器会拒绝继续调用。 这段代码使用自定义的内部消息结构。接入真实模型时,需要增加适配层:声明工具的输入结构,将供应商响应转换为程序能处理的类型,并按其协议关联工具结果与调用编号;多工具调用、流式返回和错误处理也需要另行实现。 示例中的三轮上限用于演示停止条件。真实任务还要结合模型超时、工具超时、调用次数和费用预算判断能否继续,不能只依赖模型主动结束。 ## 异步能力为什么适合组织 Agent 工具 Agent 经常等待模型服务、网页、数据库或文件服务返回。如果几项任务相互独立,可以让这些等待过程并发进行。 Python 的 `asyncio` 使用 `async` / `await` 组织并发,适合 I/O 密集和结构化网络程序。它不会让一个依赖前一步结果的动作提前完成,也不会自动加速 CPU 密集计算。[asyncio 官方文档](https://docs.python.org/3.14/library/asyncio.html) 并发示例用短暂等待模拟两个独立查询,演示并发和整组超时;需要 Python 3.11 或更新版本,示例不发起网络请求: ```python import asyncio async def read_status(name): await asyncio.sleep(0.05) # 模拟等待外部服务 return {"service": name, "status": "ok"} async def main(): try: async with asyncio.timeout(2): async with asyncio.TaskGroup() as group: article = group.create_task(read_status("article")) links = group.create_task(read_status("links")) print(article.result(), links.result()) except TimeoutError: print("查询超时,停止本轮任务") asyncio.run(main()) ``` `TaskGroup` 组织一组任务,`asyncio.timeout` 提供超时控制;任务异常和取消仍要按实际调用处理。同步阻塞的网络库如果直接放进协程,会阻塞事件循环;运行中的远程操作或转交线程的工作,也未必能随本地取消立即终止。[Python 协程与任务文档](https://docs.python.org/3.14/library/asyncio-task.html) 在真实项目中,还要限制并发数量,避免多个 Agent 同时把模型接口或数据库打满。异步是调度方式,服务限流、连接管理和重试策略仍由程序设计。 ## 状态管理让 Agent 能够继续完成任务 一次对话中的消息可以作为上下文,但复杂任务还需要记录当前步骤、已经取得的结果、失败原因以及等待中的决定。 例如,检查草稿时已经完成资料检索,下一步要生成预览。进程重启后,如果只记得最初的问题,Agent 可能重新查询同一批资料;如果保存了可恢复状态,就有机会从明确的执行位置继续。 LangGraph 提供持久化机制:checkpointer 保存某个执行线程的图状态,store 保存应用定义的跨线程信息。使用这些能力,需要按业务配置实际存储与隔离方式;安装框架并不会自动获得持久可靠的“记忆”。[LangGraph 持久化文档](https://docs.langchain.com/oss/python/langgraph/persistence) 这里的 thread 指框架中的执行或会话标识,不等同于 Python 的操作系统线程。对话记录、任务状态和长期知识也应按用途管理,避免把所有历史文本无限追加进提示词。 恢复执行还涉及副作用。读取同一个文档通常可以重复,提交订单、发信或发布文章却可能造成重复结果。需要使用任务标识、幂等键或业务状态检查等机制,才能判断某个动作是否已经完成。 LangGraph 的中断文档明确提醒:恢复时节点可能重新执行,因此中断之前的副作用应考虑幂等。检查点记录了状态,并不自动保证外部系统中的操作只执行一次。[LangGraph 中断与副作用说明](https://docs.langchain.com/oss/python/langgraph/interrupts) ## 工作流框架解决什么问题 开始时,一个普通 Python 循环就可以说明执行机制。随着任务增加,程序可能需要条件分支、状态保存、人工介入、流式反馈和恢复执行,框架能够减少这些基础设施的重复实现。 LangGraph 将自己定位为有状态 Agent 的编排运行时,支持将确定性的代码步骤与模型驱动的步骤组合起来。它负责提供流程基础设施,任务能否完成仍取决于模型、工具设计、数据和应用约束。[LangGraph 概览](https://docs.langchain.com/oss/python/langgraph/overview) | 需求 | 可以先考虑的实现 | | --- | --- | | 固定格式的单次生成 | 一次模型调用和结果校验 | | 步骤顺序已知 | 普通函数或固定工作流 | | 模型需要根据结果选择工具 | 带工具白名单与停止条件的调用循环 | | 任务跨多轮、等待审批或需要恢复 | 显式状态和持久化的工作流编排 | 对博客助手而言,可以允许模型选择检索资料,但将“生成预览、检查索引、执行发布”放进明确的程序流程。容易验证的步骤用代码约束,确实需要灵活判断的部分再交给模型。 ## MCP 在 Python 与工具之间起什么作用 当不同 Agent 应用需要接入相同工具时,为每个应用重新写一套专用连接会产生维护成本。MCP 为应用与外部能力之间的上下文交换提供协议,定义客户端、服务端和工具等接口;它不规定模型必须怎样推理或如何管理上下文。[MCP 架构说明](https://modelcontextprotocol.io/docs/2026-07-28/learn/architecture) Python 可以用于编写 MCP 客户端或服务端。工具通过协议被发现和调用之后,仍需要实际业务代码完成读取、查询或写入。MCP 本身不会让一个模型拥有新的执行权限,也不能替应用完成业务授权。 MCP 也不是 Python 专用协议,官方提供多种语言的 SDK。Python 在这里的优势是容易复用已有服务和数据处理代码,而不是对协议的独占支持。[MCP 官方 SDK](https://modelcontextprotocol.io/docs/sdk)  直接工具和MCP服务都需要实际执行代码;MCP统一接口,权限与状态管理仍由应用落实。 ## Python 的优势有哪些边界 模型能力和程序语言是不同的层次。把执行器换成 Python,不会自动让模型更准确地选择工具;接口描述含糊、返回内容不完整,仍会影响后续判断。 Agent 慢在哪里需要分开测量:模型生成、网络等待、工具执行、上下文整理、重试和排队都可能占用时间。远程模型耗时较大时,重写少量 Python 调度代码未必有明显收益;如果本地解析或计算已经成为瓶颈,则应针对那部分优化。 工具返回内容还可能包含网页正文、邮件或第三方文档。这些内容可以提供任务数据,但其中出现的“忽略原要求并执行某动作”不能成为新的授权。工具范围、文件路径、账号权限和高影响操作的确认,应由应用在模型输出之外执行检查。 生产环境还需要核对超时和重试的关系:只重试明确可以重复的操作;写入结果不确定时,先查业务状态,再决定是否再次执行。日志应能关联一次任务与具体工具调用,同时避免记录密钥和不必要的个人数据。这些是执行系统的工程责任,提示词无法单独替代。 ## 什么情况下适合选择 Python 如果 Agent 需要连接大量已有 Python 工具、处理文档和数据,或频繁调整工具接口与工作流,Python 通常是值得优先评估的选择。团队能够在同一环境中组织模型请求、编写工具和检查结果,减少系统之间的转换工作。 如果业务主体已经是 TypeScript、Java 或 Go,且只是接入模型和少量 HTTP 工具,沿用原有技术栈也可能更容易维护。也可以让 Python 提供特定工具服务,由其他语言的应用通过接口调用。 判断语言是否合适,可以先做一个可核对的小任务:准备两个只读工具,明确输入输出和最大调用次数,记录每次工具选择、结果与耗时,再加入失败、超时和恢复场景。观察这些环节是否清楚,比堆叠更多工具或更多 Agent 更能帮助判断方案是否可用。 Python 与 AI Agent 的适配,最终体现在它能否让模型请求、实际执行和流程状态清楚地衔接起来。理解这个分工,才能既利用模型的灵活性,也让应用保留可检查、可恢复的执行逻辑。 ## 参考资料 资料核对于 **2026 年 10 月 25 日**。Python 说明按 3.14 文档,离线异步示例使用 3.11 起提供的接口;MCP 架构链接固定为 2026-07-28 文档,其余框架链接为滚动维护文档。工程文章用于解释架构,具体接口按项目当前文档核对。 1. Yao 等,[ReAct: Synergizing Reasoning and Acting in Language Models](https://arxiv.org/abs/2210.03629)(ICLR 2023,作者公开稿):行动与环境观察交替组织的原始研究,不作为本文示例效果或语言优劣的基准。 2. Anthropic,[Building effective agents](https://www.anthropic.com/research/building-effective-agents)(2024 年起发布的工程文章):Agent 与工作流的架构区分;页面已提醒工具生态后续发生变化。 3. [Python 官方教程](https://docs.python.org/3.14/tutorial/index.html):函数、数据结构与快速应用开发。 4. [LangChain 工具文档](https://docs.langchain.com/oss/python/langchain/tools):工具名称、文档字符串与输入结构。 5. [Python 类型注解](https://docs.python.org/3.14/library/typing.html):类型注解不由 Python 运行时自动强制检查。 6. [asyncio 概览](https://docs.python.org/3.14/library/asyncio.html):异步 I/O 与协程组织。 7. [Python 协程与任务](https://docs.python.org/3.14/library/asyncio-task.html):TaskGroup、超时、取消与线程调用的限制。 8. [LangGraph 概览](https://docs.langchain.com/oss/python/langgraph/overview):有状态 Agent 与工作流编排。 9. [LangGraph 持久化](https://docs.langchain.com/oss/python/langgraph/persistence):checkpointer、store 和状态保存。 10. [LangGraph 中断](https://docs.langchain.com/oss/python/langgraph/interrupts):暂停恢复及副作用幂等。 11. [MCP 架构](https://modelcontextprotocol.io/docs/2026-07-28/learn/architecture):应用、客户端、服务端与工具的协议分工。 12. [MCP 官方 SDK](https://modelcontextprotocol.io/docs/sdk):多语言客户端与服务端开发入口。 --- --- title: "GEO 信源生态与集中度:AI 搜索引用有多集中?" source: https://www.iowill.com/blog/2026/10/geo-source-ecosystem-concentration/ date: 2026-10-24 updated: 2026-10-24 tags: [AI搜索, GEO, 内容优化, 数据分析] categories: [软件与工具] --- # GEO 信源生态与集中度:AI 搜索引用有多集中? AI 搜索究竟引用谁?做 GEO(生成式引擎优化)时,这个问题比“文章里放几个关键词”更接近实际:内容需要被发现,也需要在具体问题下成为回答可采用的材料。 本文选取 [CN-GEO 多维数据分析报告第三章](https://yaojingang.github.io/geo-citation-lab/03-cn-geo-citation-dataset/reports/final/CN-GEO_%E5%A4%9A%E7%BB%B4%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90%E6%8A%A5%E5%91%8A.html#chapter-3) 的信源数据,重点看两件事:不同类型的信源贡献了多少引用,以及引用向头部集中到什么程度。 **在这份样本中,Top 10 信源贡献了 41.47% 的可关联信源去重引用。** 这能说明样本中的分布不均衡,但不能据此计算一篇个人博客被引用的概率。 ## 信源、页面与生态归属的区别 分析引用之前,需要先确定数的是什么。同一篇文章可能被多次引用,同一个域名可能承载很多作者,而同一个企业也可能运营多个域名。 本文使用的几个单位分别是: - **信源**:数据集归一化后的域名单位,不直接等于作者、公司或企业集团。 - **页面**:归一化后的 URL。同一信源可以包含许多页面。 - **引用记录**:采集到的一次引用观察。去重记录也不直接等于独立回答数。 - **信源类型**:平台社区、新闻媒体等分类标签。 - **生态归属**:来源所属的平台或组织生态,与内容类型是两个维度。 例如,一个门户域名中的文章可能来自媒体、机构或个人账号。研究“哪个平台入口出现得多”和研究“谁生产了内容”,需要不同的识别粒度;必要时应继续核对作者账号和原始发布页。 这也影响“未分类”的解释。报告中,信源类型未分类的是 **150 个**,未归属生态的是 **8,657 个**。前者缺少类型标签,后者缺少生态归属,不能混为一组,更不能直接称为“不可信网站”或“个人博客”。 ## 统计分母为什么不能混用 本文于 2026 年 10 月 24 日核对报告。数据集发布日为 **2026 年 7 月 14 日**,报告生成时间为 **7 月 21 日**;它是既有样本的分析,不是 10 月各产品实时算法的测量。 报告覆盖 620 个问题、12 个产品/终端口径。网页版与 App 会分别计入,这里的“12”不代表 12 家独立公司。 | 统计范围 | 数量 | 本文用途 | | --- | --: | --- | | 原始引用记录 | 214,119 | 理解采集规模 | | 去重引用记录 | 189,845 | 理解清洗后的总体规模 | | 可关联信源的去重引用 | 187,818 | 类型引用占比、Top N 集中度的分母 | | 信源 | 9,878 | 信源数量占比的分母 | 后文的 41.47% 是 `77,890 ÷ 187,818`,不是除以全部原始记录,也不是除以问题数。189,845 与 187,818 相差 2,027 条,表示两种统计范围不同;不能未经逐项检查便将差额全部判为无效链接。 上游去重采用记录哈希口径,也不能简化成“每个 URL 只算一次”。更关键的是,数据缺少可稳定恢复独立回答边界的标识,因此这里不把引用条数换称为“回答次数”。相关字段限制见[数据集中文说明](https://github.com/yaojingang/geo-citation-lab/blob/main/03-cn-geo-citation-dataset/data/%E6%95%B0%E6%8D%AE%E9%9B%86%E4%B8%AD%E6%96%87%E8%AF%B4%E6%98%8E.md)。  图1:信源数量占比与引用记录占比使用不同分母;根据CN-GEO报告数据重绘,引用记录不等于独立回答。 ## 哪些类型贡献了更多引用 下表按报告分类列出信源数量及其引用贡献。百分比四舍五入到小数点后两位,两列占比使用不同分母。 | 信源类型 | 信源数量 | 信源数量占比 | 引用贡献占比 | | --- | --: | --: | --: | | 平台与社区 | 462 | 4.68% | 29.63% | | 商业信息与服务 | 2,817 | 28.52% | 23.06% | | 新闻与媒体 | 920 | 9.31% | 20.50% | | 垂直专业内容 | 1,899 | 19.22% | 10.59% | | 政府与公共机构 | 1,479 | 14.97% | 4.74% | | 品牌与企业官网 | 1,868 | 18.91% | 4.33% | | 搜索与页面代理 | 48 | 0.49% | 4.00% | | 研究与文档 | 235 | 2.38% | 2.92% | | 未分类长尾 | 150 | 1.52% | 0.23% | 平台与社区的信源数量占比为 4.68%,引用贡献却达到 29.63%;商业信息与服务的信源数量较多,引用贡献则为 23.06%。这说明按域名数观察的结构,与按引用记录观察的结构有明显差别。 不过,大平台域名下可能聚集海量内容。把一个社区域名与一个个人网站各计为一个信源,并不意味着它们拥有相同的页面数量、主题覆盖或内容供给。 因此,两列比例的差异不能解释成“某类文章获得了多少倍算法加权”。本表既没有全部待引用页面的规模,也没有曝光次数,无法计算单页引用概率。 分类标签也有误差边界:报告记录了 8,644 个模型辅助分类信源,不能将整张表理解为逐站人工审定的结果。针对重要站点下结论前,应回看标签与页面。 ## Top 10 占 41.47%,集中到什么程度 集中度回答的是:按引用量排序后,前 N 个信源合计占了多少记录。 | 范围 | 合计引用记录 | 累计占比 | | --- | --: | --: | | Top 5 | 49,369 | 26.29% | | Top 10 | 77,890 | 41.47% | | Top 20 | 97,910 | 52.13% | | Top 50 | 117,409 | 62.51% | | Top 80 | 126,667 | 67.44% |  图2:Top N累计引用占比,按187818条可关联信源的去重记录重新计算;范围相互包含,不可相加。 Top 10 合计占 41.47%,Top 20 超过一半,Top 80 达到 67.44%。这是一种明显的头部聚集,但表中的 N 是信源个数,不能拿 Top 20 直接套成“二八定律”。 前十名依次为抖音、腾讯网、今日头条、百度百科、手机搜狐网、买购网、什么值得买、sm.cn、网易和品牌网。名单同时包含内容平台、门户、百科及搜索相关入口,所以它首先是**引用入口分布**,不能直接当作内容质量或权威性排行榜。 如果要研究原始内容生产者,还需要沿引用 URL 检查:页面是谁发布的,是否转载,引用经过了什么入口。同样,“出现了引用”也不自动意味着 AI 对页面全部观点表示认可。 Top 10 之外仍有 58.53% 的记录,但这部分分布在其他各类信源中,并不是个人博客独占的空间。另一方面,头部集中也不足以推出“个人博客没有机会”:全局榜单没有告诉我们,在某个很具体的技术问题下,哪些页面提供了可复核的证据。 ## 全局榜单为什么不能直接当成平台偏好 将所有产品合在一起统计时,引用记录较多的产品/终端也会对总榜产生更大影响。总榜既反映来源分布,也受到样本问题和采集规模的影响。 例如,在报告全范围的分产品结果中,豆包网页版的首位信源是抖音,腾讯元宝网页版是腾讯网,千问网页版是 sm.cn。这些是样本中的描述性结果,尚不足以证明某个算法主动偏袒自家生态。 要进一步讨论偏好,应尽量控制问题集合、问题措辞、终端、采集时间和会话条件,再比较相同问题下的结果。否则,产品之间的差别可能混入问题覆盖与场景差别。 同理,不能用这份数据的引用总量推算产品市场份额,也不能把未在样本里出现的网站判定为“永远不会被收录”。样本没有覆盖所有问题,更没有覆盖互联网上全部可引用页面。 ## 其他研究能补充哪些证据 目前这篇文章的 41.47% 仍只来自 CN-GEO。要检验“集中度值得关注”是否也出现在其他场景,可以参考独立研究;但语言、产品、问题集和链接提取规则不同,不能将各研究的百分比拼成同一份排行榜。 ### 头部集中在其他样本中也有出现 [Pew Research Center 的原始分析](https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/)基于 900 名美国成年人的浏览数据,获得 68,879 个不同 Google 搜索,并在 2025 年 4 月重跑搜索采集结果。其方法最多提取每条 AI 摘要中的三个来源 URL;Wikipedia、YouTube 和 Reddit 合计占所提取摘要信源的 15%。这说明特定入口在该样本中较常见,但不能拿这个数字与 CN-GEO 的全局 Top 10 直接比较。 更直接讨论集中度的是 [From Public Posts to AI-Search Citations](https://arxiv.org/html/2610.11932v1)。这份 2026 年 10 月 8 日公开的 arXiv 稿件分析了 10 个平台的 17,211 次引用、6,356 个不同来源域名,报告各平台 Top 20 域名占比介于 20.5%—70.8%。**这是该稿件的样本结果,本文按 arXiv 公开版本引用,尚未独立复现,也不据此宣称所有产品都有相同集中度。** 另一份 [News Source Citing Patterns in AI Search Systems](https://arxiv.org/html/2507.05301v1) 使用 AI Search Arena 数据,发现新闻引用向少数媒体聚集。它研究的是新闻来源子集,而非全部网站;本文按 2025 年预印本使用。该研究与后文 Cambridge 论文都使用 Arena 系列数据,不能将它们当作完全独立的采样重复验证。 这些材料分别支持“特定来源反复出现”“平台间集中程度不同”和“新闻子集也存在头部聚集”三个较窄的判断。它们没有给出适用于全网的统一阈值。 ### 被检索、被引用与引用正确是三个问题 发表于 *Data & Policy* 的 [The attribution crisis in LLM search results](https://www.cambridge.org/core/journals/data-and-policy/article/attribution-crisis-in-llm-search-results-estimating-ecosystem-exploitation/170DD0B88E5F5AEA8F69F2E9AF1328E3) 分析了 2025 年 3—4 月的 LMArena 搜索日志,区分系统访问的相关 URL 与最终署名的 URL。它为“被读取不等于被展示为引用”提供了研究依据;但不同供应商日志披露程度不同,日志也不代表系统全部内部行为。 ACL 正式收录的 [Evaluating Verifiability in Generative Search Engines](https://aclanthology.org/2023.findings-emnlp.467/) 则将可核验性分为两部分:回答是否得到充分引用支持,以及每条引用是否真的支持关联陈述。它研究的是 2023 年的四个系统,本文借用评估方法,不把当年的准确率当作今天的产品表现。 [哥伦比亚 Tow Center 的原始测试报告](https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php)还记录了新闻原文被错误归属、转载页替代原始来源和链接失效等问题。该研究任务是根据新闻片段识别原文,不能外推成所有日常搜索的错误率,但能说明:核对引用时,仅看域名是否知名还不够。 ## 个人技术博客怎样做一轮引用观察 对个人博客而言,我更关心的是:在文章能回答的具体问题下,AI 是否引用了原始页面,以及引用是否准确。 以下是一套拟采用的观察方案,**本文没有据此运行产品测试,也没有获得本站引用率提升的实验结果**。 ### 固定问题和采集条件 先选约 20 个与现有文章对应的具体问题,固定措辞。例如: - Linux 删除日志后,为什么磁盘空间没有释放? - Docker 容器中使用 localhost,为什么访问不了宿主机服务? - Debian 双网卡环境中,Docker MySQL 外网连接失败,如何检查回程路由? 这些问题应能在文章中找到完整答案,不能为了凑关键词拼接不自然的问题。站内的[磁盘空间排查文章](https://www.iowill.com/blog/2026/10/linux-server-disk-full-troubleshooting/)就适合围绕已删除但仍被进程打开的文件,设计更具体的观察问题。 每次记录产品、终端、可见模型版本、采集时间、联网搜索状态及会话条件,并保留完整回答与引用 URL。跨日期复测时分开汇总,不把一次偶然命中当成稳定表现。 ### 把引用、提及与错误分开记录 可以用以下字段建立表格: ```text 问题编号,问题原文,产品,终端,模型版本,采集时间,会话条件,联网状态,执行状态,回答标识,完整回答存档,引用URL,是否引用本站,是否仅提及本站,引用是否准确 ``` 同一产品、终端、问题集和条件下,可自行定义一个观察指标: ```text 本站引用回答占比 = 含有本站目标URL引用的有效回答数 ÷ 有效回答总数 ``` 这里的分子按回答计数,一次回答引用多个本站链接也只计一次。正常生成但没有引用的回答仍计入分母;超时、报错等情况单独记录,并在采集前约定有效性规则,不能看到结果后再剔除不利样本。 这个指标用于自己的后续观察,与报告的“引用记录占比”不同,不能直接横向比较。缺少完整回答和回答标识时,也不能从当前报告反推出这个指标。 ### 改善文章证据,再观察结果 针对技术文章,我会优先补齐适用环境、版本、错误现象、排查命令、关键输出、结论与验证方法,并链接官方资料;已有操作失败的条件也应明确说明。 这些首先能帮助读者判断答案是否适用,也是便于后续检查引用准确性的做法。它们是否提高了 AI 引用表现,需要用固定问题持续观察,不能由本报告直接证明。 可以同时参考两家平台的官方说明:[Google Search Central](https://developers.google.com/search/docs/appearance/ai-features)说明,AI Overviews 和 AI Mode 的支持链接需要页面已被索引并具备展示摘要的资格,不要求额外的专用 AI 文件或特殊结构化数据,符合要求也不保证展示。这是 Google 的产品规则,不能代替其他平台的规则。 [Bing 官方的 AI Performance 说明](https://blogs.bing.com/webmaster/2026/2/Introducing-AI-Performance-in-Bing-Webmaster-Tools-Public-Preview/)提供引用次数、页面和 grounding queries 等观察入口,并明确引用次数不表示页面排名或权威性;检索词数据也只是部分引用活动的样本。若使用该工具,应注明所覆盖的微软产品范围,不能把它当作全平台引用统计。 作为研究背景,[GEO 原始论文](https://arxiv.org/abs/2311.09735v3)已被 KDD 2024 接收,并在特定基准与系统中评估内容调整对可见性的影响;其结果随领域而异。论文中的可见性指标、实验环境与本站后续观察不同,因此不能把实验中的最高提升幅度写成博客的预期收益。 关于 GEO 的基础概念,可以先读[什么是 GEO](https://www.iowill.com/blog/2026/08/what-is-geo/);关于站点说明文件,可参阅 [llms.txt 与 Hexo 博客](https://www.iowill.com/blog/2026/10/llms-txt-for-hexo-blog/)。文件可访问、文章可抓取,与最终是否被某个产品引用,是不同环节。 ## 阅读结果时还要保留哪些边界 这份数据适合观察特定样本的引用分布,但仍有几个不能跨过去的边界: - 数据没有完整的模型版本与采集时间,不能据此判断今天的算法变化。 - 引用片段不是完整回答,不能直接推出推荐态度、品牌情绪或答案准确率。 - 标题和引用片段的内容特征不能替代全文分析,也不足以证明 FAQ、表格等格式造成了引用提升。 - 进入信源表的是已观察到的来源,并非全部候选网站,缺少估计单站被引用概率所需的总体。 对个人博客更有用的问题,是某篇文章能否清楚回答一个真实问题,证据是否可核对,以及相同条件下的多次观察是否支持改进有效。头部榜单提供了背景,具体内容仍要回到具体问题中检验。 ## 参考资料 1. [CN-GEO 多维数据分析报告:第三章信源生态](https://yaojingang.github.io/geo-citation-lab/03-cn-geo-citation-dataset/reports/final/CN-GEO_%E5%A4%9A%E7%BB%B4%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90%E6%8A%A5%E5%91%8A.html#chapter-3):本文类型与集中度数据来源,Top N 百分比按所列分母重新计算。 2. [CN-GEO 数据集 README](https://github.com/yaojingang/geo-citation-lab/blob/main/03-cn-geo-citation-dataset/README.md):数据发布及项目说明。 3. [数据集中文说明](https://github.com/yaojingang/geo-citation-lab/blob/main/03-cn-geo-citation-dataset/data/%E6%95%B0%E6%8D%AE%E9%9B%86%E4%B8%AD%E6%96%87%E8%AF%B4%E6%98%8E.md):统计单位、字段缺失与分析限制。 4. [清洗后数据使用说明](https://github.com/yaojingang/geo-citation-lab/blob/main/03-cn-geo-citation-dataset/data/%E6%B8%85%E6%B4%97%E5%90%8E%E6%95%B0%E6%8D%AE%E4%BD%BF%E7%94%A8%E8%AF%B4%E6%98%8E.md):表结构、归一化及使用口径。 5. [Pew Research Center:Google AI 摘要与链接行为](https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/)(2025):原始研究,含采样与 URL 提取方法。 6. [From Public Posts to AI-Search Citations](https://arxiv.org/html/2610.11932v1)(2026,arXiv 公开稿):分平台域名集中度研究,未由本文复现。 7. [News Source Citing Patterns in AI Search Systems](https://arxiv.org/html/2507.05301v1)(2025,预印本):新闻引用子集研究。 8. [The attribution crisis in LLM search results](https://www.cambridge.org/core/journals/data-and-policy/article/attribution-crisis-in-llm-search-results-estimating-ecosystem-exploitation/170DD0B88E5F5AEA8F69F2E9AF1328E3)(2026,Data & Policy):访问与署名差异,使用 2025 年日志。 9. [Evaluating Verifiability in Generative Search Engines](https://aclanthology.org/2023.findings-emnlp.467/)(2023,Findings of EMNLP):引用完整性与正确性的评估框架。 10. [AI Search Has a Citation Problem](https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php)(2025,Tow Center):新闻片段寻源测试。 11. [AI features and your website](https://developers.google.com/search/docs/appearance/ai-features)(Google 官方文档,2026-10-24 核对):Google AI 搜索的技术资格与边界。 12. [Introducing AI Performance in Bing Webmaster Tools](https://blogs.bing.com/webmaster/2026/2/Introducing-AI-Performance-in-Bing-Webmaster-Tools-Public-Preview/)(2026,Bing 官方):微软支持范围内的引用观察口径。 13. [GEO: Generative Engine Optimization](https://arxiv.org/abs/2311.09735v3)(KDD 2024):可见性优化的原始研究,实验提升不等于本站收益承诺。 --- --- title: "Linux 服务器空间不足排查:磁盘容量、inode 与文件占用" source: https://www.iowill.com/blog/2026/10/linux-server-disk-full-troubleshooting/ date: 2026-10-23 updated: 2026-10-23 tags: [Docker, Linux, 故障复盘, 故障排查, 日志管理, 磁盘空间] categories: [系统与运维] --- # Linux 服务器空间不足排查:磁盘容量、inode 与文件占用 网站突然写不进日志,上传接口开始失败,数据库提示写入错误。登录服务器后,发现根分区已经接近 100%。 这时最需要弄清楚的是:**哪一个文件系统满了、耗尽的是容量还是 inode、空间由谁占用,以及处理后为什么能够恢复。** 找到大文件只完成了一半,文件所属服务、数据用途和增长原因,同样决定了下一步能做什么。 尤其要注意:**文件名消失,不代表数据块已经回收。已删除的文件仍被进程打开时,空间可能继续占用,甚至继续增长。** 所以处理结果要看目标文件系统的可用空间和业务恢复情况,不能只看删除命令有没有报错。 本文按线上排查顺序展开,主要面向使用 GNU 工具的 Linux 服务器。系统日志部分适用于 systemd,容器部分适用于 Docker Engine;Alpine 的 BusyBox、其他容器运行时和托管数据库需要对照各自的工具与权限。 资料核对至 **2026 年 10 月 23 日**。本文是排查指南,示例路径、输出和容量均用于说明判断方法,不是某台生产服务器的事故实录。 ## 故障现象与初步判断 | 看到的现象 | 优先核对 | 下一步 | | --- | --- | --- | | `df -hT` 的 `Use%` 很高 | 对应设备和挂载点 | 在该文件系统内逐层检查目录占用 | | 还有容量,却创建不了文件 | `df -i` 的 `IUse%` | 查大量小文件所在的目录 | | `df` 很满,`du` 找不到相应占用 | 是否同一文件系统、权限及打开的已删除文件 | 检查挂载关系与 `lsof +L1` | | 删了大日志,空间没有回来 | 进程是否仍持有文件 | 按服务支持的方式重新打开日志或释放句柄 | | Docker 所在分区满 | 数据根目录、镜像、写层、卷与日志 | 对照 Docker 统计与宿主机实际路径 | | 应用报错,但宿主机的容量和 inode 都充足 | 实际写入路径、配额、容器限制和文件系统状态 | 回到应用报错及所在运行环境继续查 |  先确认挂载范围与资源类型,再定位占用来源;处理后同时验证空间与业务。 排查期间先保留会话与必要的错误信息。若已经发现某个任务持续大量写入,按业务影响暂停该任务、降低非必要日志量或限制上传,避免边查边继续填满空间。 前几节的命令以只读检查为主,但遍历目录也会产生 I/O。大目录应逐层缩小范围,避免在已经繁忙的磁盘上同时启动多轮全盘扫描。输出可以保存到运维终端,别把大份诊断报告再写回已经满的分区。 ## 第一步:确认文件系统、容量和 inode 使用情况 检查文件系统容量和 inode 使用情况: ```bash df -hT df -i ``` `df -hT` 中需要一起看的是: - `Filesystem`:设备或文件系统来源。 - `Type`:文件系统类型。 - `Avail` 和 `Use%`:可用空间及使用率。 - `Mounted on`:挂载点,决定后面应该从哪里查。 用于说明判断方式的示例输出: ```text Filesystem Type Size Used Avail Use% Mounted on /dev/vda1 ext4 40G 38G 300M 100% / /dev/vdb1 xfs 200G 60G 140G 30% /data ``` 这说明根文件系统紧张,但 `/data` 仍有空间。直接统计整个 `/` 并把 `/data` 算进去,会把两个不同文件系统混在一起。 有时应用实际写入的位置并不在你以为的数据盘上。针对真实路径继续检查,例如: ```bash df -hT /var/log findmnt -T /var/log ``` `findmnt -T` 用来查包含该路径的文件系统。把 `/var/log` 换成应用实际写入的目录,先确认路径确实存在;数据盘挂载失败后,程序也可能把数据写进根文件系统上的同名目录。 `df -i` 则检查 inode。在 ext4 等文件系统上,大量小文件可能先耗尽 inode,导致仍有剩余容量却无法创建新文件。不同文件系统的 inode 分配方式不同,不能只凭某一列显示为零或未知就判断故障,仍要结合文件系统类型和实际报错。[GNU 的 `df` 文档](https://www.gnu.org/software/coreutils/manual/html_node/df-invocation.html)说明了容量、inode 和挂载点的统计含义。 ## 第二步:定位目录空间占用 确认满的是根文件系统后,检查第一层目录的占用: ```bash sudo du -x -h --max-depth=1 / | sort -h ``` 这里的参数各有作用: - `-x`:不跨到不同文件系统,避免把独立数据盘算进来。 - `-h`:用便于阅读的单位显示容量。 - `--max-depth=1`:只展示第一层汇总,便于判断下一步。 - `sort -h`:按带单位的数值排序。 最后的 `/` 汇总行是总量,不是一个需要删除的额外目录。发现 `/var` 占用明显较大,再查下一层: ```bash sudo du -x -h --max-depth=1 /var | sort -h sudo du -x -h --max-depth=1 /var/log | sort -h ``` **限制显示深度不等于只扫描一层。** `du` 为了求出目录总量,仍需要遍历下面的内容。不要把这条命令当成低成本的实时监控。 如果满的是 `/data`,起点就改成 `/data`。`-x` 按文件系统边界限制遍历,也不能代替对 bind mount、容器 overlay 等挂载关系的核对。命令含义可参考 [GNU 的 `du` 文档](https://www.gnu.org/software/coreutils/manual/html_node/du-invocation.html)。 此时先保留错误输出:`Permission denied` 表示有内容没有统计到,文件消失或变化则可能来自正在运行的服务。把 stderr 全部丢弃后得到的“小占用”,不一定是完整结果。 ### 查找大文件并核对实际磁盘占用 例如,需要列出 `/var/log` 下逻辑大小超过 1 GiB 的普通文件: ```bash sudo find /var/log -xdev -type f -size +1G -printf '%s\t%p\0' \ | sort -z -nr \ | head -z -n 20 \ | tr '\0' '\n' ``` 这组命令使用 GNU `find` 和支持 NUL 分隔的 GNU 工具,输出第一列为字节数。中间用 NUL 分隔,避免排序阶段把文件名中的换行当成新记录;最后转成普通文本仅供人工查看,不要把它直接拼成批量删除命令。 `find -size` 看的是文件逻辑大小,稀疏文件可能显示很大,实际分配的磁盘块却没有那么多。对选中的单个文件再比较: ```bash ls -lh -- /var/log/example.log sudo du -h -- /var/log/example.log ``` 这里的 `example.log` 是占位路径,执行时换成已经确认的真实文件。逻辑大小和实际占用的区别,也意味着“最大的文件”不一定能释放最多空间。 ## 第三步:排查 inode 耗尽与小文件积累 假设 `df -hT` 仍有较多空间,`df -i` 却显示某个文件系统的 inode 接近耗尽,可以按目录统计 inode 使用: ```bash sudo du -x --inodes --max-depth=1 /var | sort -n ``` 找到数量突出的目录后,继续往下缩小范围。这里不加 `-h`,方便按数值比较。命令需要 GNU `du` 支持 `--inodes`;不支持时先查本机帮助,避免套用不兼容选项。 常见来源包括没有过期策略的缓存、会话文件、失败任务的临时文件和按请求持续生成的小文件。确定目录属于谁以后,再核对保留时间、正在使用的文件,以及应用是否有自带的清理机制。 删除一个巨大的备份文件通常只能解决容量问题。若真正耗尽的是 inode,应该检查文件数量;反过来,清理很多几字节的小文件,也未必能显著缓解容量不足。 ## 第四步:核对 df 与 du 的统计差异 `df` 看文件系统的空间账,`du` 通过目录树统计能够访问的文件占用。两者口径不同,不能要求结果逐字节一致。 先核对这些条件: 1. 比较的是否为同一个文件系统,有没有把独立挂载点混进来。 2. `du` 是否有足够权限,扫描期间文件是否持续变化。 3. 是否存在已删除但仍被进程打开的文件。 4. 是否涉及文件系统元数据、保留块、快照或写时复制等额外占用。 5. 挂载点下面是否遮住了原有文件,导致当前目录视图看不到它们。 前几项可以在线核对;涉及快照、挂载遮蔽或底层存储的检查,应结合实际文件系统另行规划。不要为验证一个猜测,直接卸载线上正在使用的数据盘。 ### 排查已删除但仍被进程打开的文件 一个典型原因是最后一个文件名已经删除,但进程仍持有打开的文件。这里的“被占用”主要是指进程还打开着文件,不一定存在文件锁。Linux 允许删除打开的普通文件名,进程却仍可以通过原来的文件描述符继续访问它。 此时 `ls` 看不到原文件,`du` 也不能再沿原路径找到它,但文件系统仍需保留它占用的块。**删除正在写入的日志以后,进程甚至可能继续向这个已删除文件写数据,`df` 的使用量仍然上升。** 重新创建一个同名文件,也不会自动把进程原来的文件描述符切换过去。 对于普通文件,需要移除剩余硬链接并释放进程持有的引用,空间才具备回收条件。文件名与打开引用的关系可参考 [Linux unlink(2) 手册](https://man7.org/linux/man-pages/man2/unlink.2.html)。  路径消失不等于空间释放:需要核对剩余链接、打开引用及目标文件系统的实际变化。 有 `lsof` 且具备相应权限时,可以检查: ```bash sudo lsof -nP +L1 ``` `+L1` 选择链接数小于 1 的打开文件,用来查找已经 unlink 的文件。结合 `COMMAND`、`PID`、`FD`、`DEVICE`、`SIZE/OFF` 和 `NAME` 判断哪个进程持有目标文件。[lsof 官方手册](https://github.com/lsof-org/lsof/blob/master/docs/manpage.md)列出了该选项的含义。 教学用的简化输出中,进程、编号和大小均为示例: ```text COMMAND PID USER FD TYPE DEVICE SIZE/OFF NLINK NODE NAME app 12345 app 8w REG 253,1 10737418240 0 78901 /var/log/app.log (deleted) ``` 它表示示例进程 `12345` 仍以可写文件描述符 `8` 持有该文件,`NLINK` 为 0,路径后带 `(deleted)`。先核对进程身份和文件描述符: ```bash ps -p 12345 -o pid,ppid,user,comm sudo readlink /proc/12345/fd/8 ``` 这两条是 Linux 上的只读核对,数字必须换成当前查询结果。进程退出、重启或关闭文件后,原编号可能失效或被复用,操作前需要重新确认,不能照抄示例 PID。 这份列表可能包含其他文件系统上的文件,同一个文件也可能被多次打开。不能把 `SIZE/OFF` 一列直接相加,当成一定能释放的物理空间;还要核对文件所在设备及实际分配情况。 处理时按这个顺序进行: 1. 确认文件属于哪个服务、是否仍在增长,以及释放它会影响哪些业务。 2. 优先使用该服务明确支持的日志 reopen 或轮转方式,让进程重新打开日志。普通 reload 是否能做到这一点,取决于服务实现。 3. 没有合适的在线释放方式时,再安排受控重启对应服务或容器,并验证业务恢复。如果多个进程持有同一文件,只处理其中一个未必能够释放空间。 4. 重新运行 `lsof -nP +L1`,结合设备和 inode 判断目标文件是否仍被引用,再用 `df -hT` 检查目标文件系统,而不是只检查原路径是否存在。 不要把强杀未知进程或截断 `/proc/PID/fd/FD` 当成默认步骤。文件描述符可能指向数据库或其他关键数据,绕过服务直接处理会扩大故障。也不要为释放一个应用持有的日志,直接重启整台服务器。 目标引用消失后,继续观察可用空间和新日志是否正常写入;并发写入、稀疏文件等因素会影响回收数值,不能要求 `df` 增加量精确等于示例里的逻辑大小。 ## 第五步:分类检查日志、Docker 和数据库占用 ### 检查 journal 占用与归档保留策略 使用 systemd 的服务器可以先查看 journal 占用: ```bash sudo journalctl --disk-usage ``` 它统计的是 journal 文件,不能代表整个 `/var/log`。应用自己写出的文本日志、压缩包和备份仍需分别核对。 确认旧 journal 可以按保留要求清理后,才执行下面的操作。**这一步会删除旧日志,先确认故障取证、审计和留存需求;1G 只是示例上限。** ```bash sudo journalctl --rotate --vacuum-size=1G sudo journalctl --disk-usage ``` vacuum 针对已归档文件;配合 rotate 可以先轮转当前日志。即便如此,也不要把结果理解成整个 `/var/log` 必须精确降到 1G。具体行为见 [journalctl 官方文档](https://www.freedesktop.org/software/systemd/man/latest/journalctl.html)。 长期控制可按实际空间预算配置 journald 的保留上限,例如持久日志的 `SystemMaxUse` 和 `SystemKeepFree`;配置位置、优先级及生效方式需对照本机版本。[journald.conf 官方文档](https://www.freedesktop.org/software/systemd/man/latest/journald.conf.html)说明了这些选项。 ### 检查应用日志与备份的用途及保留条件 发现某个日志或备份很大后,先查它属于哪个服务、是否还在写入、是否已有轮转规则,以及是否存在可用的恢复副本。 同一满分区内的重命名不会腾出容量;把大日志在原分区压缩,也可能因临时空间不足而失败。需要转存时,应确认目标确实在另一文件系统或远端,传输完成并验证后再决定如何处置原文件。 已经确认过期、没有活跃引用且可删除的文件,可以按明确清单处理;正在写入的日志应通过应用或日志工具支持的方式管理。恢复少量空间以后,还需要追查为什么会持续增长,例如异常重试、调试日志未关闭或备份任务重复执行。 ### 检查 Docker 存储占用与日志配置 在有相应 Docker 权限的宿主机上检查: ```bash docker info --format '{{.DockerRootDir}}' docker system df -v docker ps --size ``` `docker system df -v` 可查看镜像、容器、卷及构建缓存等统计,镜像层还存在共享部分,不能把展示的大小简单相加。`docker ps --size` 展示容器写层等信息,也不能完整代表容器日志和挂载数据的宿主机占用。参考 [Docker 空间统计](https://docs.docker.com/reference/cli/docker/system/df/)和[容器存储说明](https://docs.docker.com/engine/storage/drivers/)。 不要把 `/var/lib/docker/overlay2` 当成固定起点。实际配置、rootless 模式以及使用 containerd image store 的安装都可能有不同存储位置;先确认引擎版本、存储方式和实际目录,再对相关路径运行 `df`、`findmnt` 与逐层统计。 对已经定位到的容器,可以查看日志配置和挂载: ```bash docker inspect --format '{{json .HostConfig.LogConfig}}' app-container docker inspect --format '{{.LogPath}}' app-container docker inspect --format '{{json .Mounts}}' app-container ``` `app-container` 换成真实名称。`LogPath` 的结果取决于日志驱动,可能为空;挂载列表则能帮助确认数据是否写到了独立卷或宿主机目录。 如果使用 `json-file` 且没有轮转限制,持续输出的日志可能不断增长。长期修复可以在对应 Compose 服务中显式配置日志轮转,例如: ```yaml services: app: # 合并到已有服务定义,保留原有 image、volumes 等配置 logging: driver: json-file options: max-size: "20m" max-file: "3" ``` 这段是合并片段,不是可直接替代生产配置的完整 Compose 文件。参数值按日志量和保留需求调整;现有容器通常需要按计划重建才能使用新配置,单纯重启容器不会更新创建时的日志选项。重建前确认持久化、服务依赖和中断窗口,完成后再次 inspect 核对。[Docker 日志配置文档](https://docs.docker.com/engine/logging/configure/)明确说明了新旧容器的生效边界。 Docker 管理的日志文件不适合用外部工具直接编辑或截断,这可能干扰日志系统。[JSON File 驱动文档](https://docs.docker.com/engine/logging/drivers/json-file/)给出了相应说明。 同样,`RECLAIMABLE` 或“未使用”不等于业务允许删除。按对象确认回滚镜像、停止容器、卷和缓存的用途,再选择清理范围;[system prune 的删除对象](https://docs.docker.com/reference/cli/docker/system/prune/)也不应被当作线上默认清理清单。 ### 确认数据库数据与日志的清理条件 如果主要占用来自数据库目录,需要继续区分业务数据、临时文件、错误日志、慢日志,以及复制或恢复所需的日志。 例如,MySQL 的 binlog 涉及复制和按时间点恢复。判断能否清理时,要同时核对副本进度、备份恢复链和保留策略,使用对应版本支持的数据库管理机制。不能仅根据文件年龄就从文件系统删除,也不能因为文件名中带 `log` 就当作普通应用日志。[MySQL 的 PURGE BINARY LOGS 文档](https://dev.mysql.com/doc/refman/8.0/en/purge-binary-logs.html)说明了相关条件。 本文不提供跨版本通用的数据库删除命令。确认空间属于正常保留的业务数据时,应转向容量规划或存储扩容。 ## 第六步:验证空间回收与业务恢复 操作完成后,复查原先确认的文件系统: ```bash df -hT /var/log df -i /var/log ``` 路径换成这次实际处理的目标。如果起初问题涉及打开的已删除文件,再看 `lsof +L1` 是否还有目标文件的引用;如果涉及 journal 或 Docker,也要复查对应统计及配置。 然后验证业务是否恢复:写日志、上传、任务落盘或数据库写入,应使用服务自身的健康检查或可控测试。一次命令返回成功,不能代表所有写入链路都已经正常。 再间隔一段时间观察使用量。如果空间很快重新被填满,说明持续增长的来源仍未解决。把这次处理记录下来:涉及哪个文件系统、占用来源、采取了什么操作、释放多少空间,以及业务验证结果。 容量确实不足时,可以继续看本站的[云服务器 Debian 12 根分区扩容记录](https://www.iowill.com/blog/2025/04/cloud-debian12-root-resize/)。那篇记录包含特定环境下的迁移和扩容过程,执行前仍需核对自己的分区、LVM、文件系统及引导方式。 ## 容量管理与防复发措施 把这次找到的来源转成对应的长期措施: | 本次原因 | 后续措施 | | --- | --- | | 日志持续增长 | 配置轮转、保留上限,修复异常输出来源 | | 缓存或临时小文件堆积 | 设置过期策略,观察文件数量和 inode 使用 | | 备份不断累积 | 明确保留周期、异地副本和恢复验证 | | Docker 日志或构建数据增长 | 限制日志轮转,按用途管理镜像和缓存生命周期 | | 正常业务数据增长 | 评估增长速度,提前安排归档、迁移或扩容 | 监控除了使用率,还应包含剩余绝对容量、inode 和增长速度。相同的使用率,在小系统盘和大数据盘上的剩余空间不同;即使当前比例不高,异常写入也可能在短时间内耗尽空间。 告警触发后,把文件系统、容量或 inode、占用来源和增长速度一并带给处理人员;故障解除后,将保留策略和负责人写进维护记录,避免下一次又从全盘搜索开始。 ## 事后复盘 服务恢复后,整理一次复盘,记录影响、证据、原因和后续行动。故障期间拿不准的地方标为待确认;没有监控或日志支撑的数据,不补写成确定结论。 ### 记录业务影响、时间线与恢复证据 复盘模板中的时间和影响范围需要根据真实记录补齐: | 记录项 | 需要填写的内容 | | --- | --- | | 故障对象 | 主机或服务标识、文件系统、挂载点,是否涉及容量或 inode | | 业务影响 | 哪些接口、任务或写入失败;影响多少请求或用户,统计依据是什么 | | 起止时间 | 首次业务受影响、告警、接手处理、开始缓解、业务恢复、验证结束;注明时区 | | 发现方式 | 监控、用户反馈或人工检查,附图表、日志或工单证据 | | 处理经过 | 按时间列出观察、判断、操作和结果,保留未生效的尝试及其解释 | | 恢复依据 | 目标分区可用空间、inode、写入测试、错误率与后续观察结果 | 告警时间不一定是故障开始时间,进程重启成功也不一定是业务恢复时间。若只能确定某个时间区间,就记录区间和证据缺口,不把处理人员接到通知的时间当成全部影响时长。 证据需要保留到可复查的位置。用于公开分享时,再去除凭据、真实服务器地址和用户数据;不要为了腾空间,把仅有的故障证据也一起清掉。 ### 分析触发因素与防护缺口 复盘至少区分四件事:什么变化触发了增长、什么资源实际耗尽、为什么没有提前发现或限制,以及什么操作真正恢复了业务。 例如,**只有实际证据支持时**,才可以把下面的链条写进结论:某应用异常重试导致日志持续增长;该日志没有有效轮转;根文件系统可用空间耗尽;处理时删除了文件名,但进程仍持有文件,所以容量没有回升;随后通过服务支持的方式释放引用,空间才被回收。 这条链里,日志异常增长是需要追查的触发因素,缺少轮转和告警是防护缺口,删除后仍被占用解释了处理为何没有立即生效。不能只把“磁盘满”或“某人删错了”作为最终原因。 如果无法证明是哪一个进程、哪一份文件或哪次变更造成增长,就保留假设并列出下一步取证方法。复盘应说明当时有哪些信息和可用工具,以及流程哪里需要改进。 ### 明确行动项、负责人和验收标准 候选行动模板按本次真实原因选用,不代表已经实施: | 行动项 | 优先级 | 负责人 / 截止日期 | 验收标准 | | --- | --- | --- | --- | | 为确认持续增长的日志配置轮转 | 待定 | 待填写 | 核对运行实例的实际配置,在受控测试中确认轮转生效与占用边界 | | 补齐容量、inode 和增长速度告警 | 待定 | 待填写 | 阈值有业务依据,测试告警能到达值班人,并附对应挂载点与排查入口 | | 把已删除文件句柄检查加入处理手册 | 待定 | 待填写 | 演练能定位持有者,通过服务支持的方式释放后,用 lsof、df 和业务检查验证 | | 修复异常重试、重复备份或缓存保留问题 | 待定 | 待填写 | 原触发条件下不会持续无界增长,观察窗口和测试证据有记录 | 每项再关联可追踪的工单或记录,完成时填写验证证据。尚未执行的配置属于计划,不能因为写进复盘就标记为已修复;“加强监控”“以后注意”也需要落实到具体改动和验收条件。 关于复盘的事实依据、改进方向和可追踪行动,可以参考 [Google SRE 的事后复盘实践](https://sre.google/workbook/postmortem-culture/)。对这类磁盘故障,复盘完成后应能回答:下一次增长会怎样被限制,怎样更早被发现,处理人员又能怎样确认空间真的释放。 ## 参考资料 - [GNU Coreutils:df](https://www.gnu.org/software/coreutils/manual/html_node/df-invocation.html)、[du](https://www.gnu.org/software/coreutils/manual/html_node/du-invocation.html)、[df 与 du 差异说明](https://www.gnu.org/software/coreutils/faq/coreutils-faq.html) - [GNU Findutils:文件大小判断](https://www.gnu.org/software/findutils/manual/html_node/find_html/Size.html) - [lsof 官方手册](https://github.com/lsof-org/lsof/blob/master/docs/manpage.md) - [Linux unlink(2):文件名删除与打开文件的生命周期](https://man7.org/linux/man-pages/man2/unlink.2.html) - [systemd:journalctl](https://www.freedesktop.org/software/systemd/man/latest/journalctl.html)、[journald.conf](https://www.freedesktop.org/software/systemd/man/latest/journald.conf.html) - [Docker:磁盘统计](https://docs.docker.com/reference/cli/docker/system/df/)、[存储驱动](https://docs.docker.com/engine/storage/drivers/)、[日志配置](https://docs.docker.com/engine/logging/configure/)、[JSON File 驱动](https://docs.docker.com/engine/logging/drivers/json-file/)、[system prune](https://docs.docker.com/reference/cli/docker/system/prune/) - [MySQL 8.0:PURGE BINARY LOGS](https://dev.mysql.com/doc/refman/8.0/en/purge-binary-logs.html) - [Google SRE:事后复盘实践](https://sre.google/workbook/postmortem-culture/) --- --- title: "php2shell:PHP 两个 9.2 分 RCE 漏洞,站长如何排查与修复?" source: https://www.iowill.com/blog/2026/10/php2shell-php-rce-security-update/ date: 2026-10-22 updated: 2026-10-22 tags: [Docker, PHP, 漏洞修复, 网络安全, 运维] categories: [系统与运维] --- # php2shell:PHP 两个 9.2 分 RCE 漏洞,站长如何排查与修复? 2026年10月21日,PHP 发布紧急安全更新,修复被称为 **php2shell** 的两个严重远程代码执行漏洞:**CVE-2026-109618** 和 **CVE-2026-109619**,两者的 CVSS v4.0 评分均为 **9.2**。 对站长来说,先做两件事:找到实际处理网站请求的 PHP,安装对应安全补丁并替换旧工作进程。只更新 CMS、看一次 `php -v`,或在配置里关闭一个功能,都不足以完成整改。 本文依据截至 **2026年10月22日** 的公开资料整理,说明排查与修复方法;不包含攻击载荷,也未对本站或用户服务器进行漏洞利用和生产升级。漏洞评分与编号可见 [PHP 官方安全通告](https://github.com/php/php-src/security/advisories/GHSA-w8hw-w9fx-j79w)及[另一份通告](https://github.com/php/php-src/security/advisories/GHSA-6wmf-4rv5-p3rp)。 ## 先核对修复版本 本次上游修复版本如下。表中的“之前”针对各自分支,不能把不同分支的版本号混在一起比较。 | PHP 分支 | 该分支需更新的上游版本 | 首个修复版本 | | --- | --- | --- | | 8.2 | 8.2.35 之前 | 8.2.35 | | 8.3 | 8.3.36 之前 | 8.3.36 | | 8.4 | 8.4.27 之前 | 8.4.27 | | 8.5 | 8.5.12 之前 | 8.5.12 | [PHP 官方公告](https://www.php.net/archive/2026.php#2026-10-21-5)要求所有通过 PHP 处理 Web 请求的部署及时更新,范围包括 PHP-FPM、Apache mod\_php、php-cgi、FrankenPHP 和 LiteSpeed。不能因为使用 Nginx + FPM,就直接排除风险。 PHP 8.1 及更老分支不再获得 PHP 项目的常规版本更新。官方此次额外提供了7.4、8.0、8.1的最小源码回移补丁,发行版也可能提供自己的维护包;这不意味着旧分支恢复了长期上游支持。已有可用修复包时先修补,再制定迁移计划。 ## 两个漏洞分别发生在哪里? ### CVE-2026-109618:内存不足后的清理碰到未完成状态 PHP 处理请求时需要分配内存。如果分配失败发生在内部结构尚未完整初始化的时刻,异常退出可能留下无效状态,随后请求清理又使用它。 官方确认 Apache mod\_php 存在经 HTTP 验证的未认证 RCE 路径,可在应用代码执行前触发。FPM 对启动失败的处理不同,但其他阶段仍可能受影响;官方通告中的“尚未演示完整 FPM 利用”不能改写成“FPM 已确认安全”。[OOM 漏洞通告](https://github.com/php/php-src/security/advisories/GHSA-w8hw-w9fx-j79w) ### CVE-2026-109619:旧请求释放了内存,worker 还留着引用 一个 worker 可以连续处理多个请求。如果某个请求的内存已经释放,内部全局状态却仍指向那里,下一个由同一 worker 处理的请求可能使用失效引用,形成 use-after-free。 它涉及状态产生、清理和后续读取的组合。会话上传进度是已确认的一类读取入口,但并非唯一入口;不同 SAPI、配置与扩展会改变具体条件。[跨请求状态漏洞通告](https://github.com/php/php-src/security/advisories/GHSA-6wmf-4rv5-p3rp) 因此,**无需身份验证,不等于所有部署都能被同一请求无条件攻破**。但也不能反过来,以某个演示没覆盖自己的组合为理由推迟补丁。  图为请求生命周期的简化示意,不表示所有SAPI具有相同的利用路径。 ## 为什么网站有登录、没有上传入口,仍然要查? PHP 的请求解析和运行时初始化,不完全发生在业务代码之后。若问题先于应用执行,登录校验、框架中间件和业务权限判断就没有机会先拦住它。 没有“上传页面”也不能证明 PHP 不解析相应请求。是否能够到达运行时,取决于前端和服务器实际处理路径,而不是页面上有没有文件选择按钮。[PHP 请求解析与风险说明](https://www.php.net/archive/2026.php#2026-10-21-5) 对于所谓“全面接管”,还应区分权限:经验证的影响是以 Web worker 账号执行代码。它可能危及该账号能读取的配置、数据库凭据和能写入的网站文件;能否进一步取得主机 root 权限,还取决于额外漏洞、权限配置与隔离边界。不要把 RCE 自动写成已经实现 root 提权。[官方影响说明](https://github.com/php/php-src/security/advisories/GHSA-w8hw-w9fx-j79w) ## 排查第一步:找到真正对外的 PHP 一台服务器可能同时存在系统 PHP、面板安装的 PHP、多个 FPM 池,以及容器内的 PHP。每套环境都需要归属到具体站点。 可以先在 Linux shell 中收集线索: ```bash command -v php php -v php --ini ps -eo pid,lstart,args | grep -E '[p]hp-fpm|[a]pache2|[h]ttpd' ``` 这些命令看到的 CLI 版本和配置,**不代表网站使用的版本和配置**。继续检查站点的 FastCGI socket、FPM 服务或容器映射,建立下面这张清单: | 记录项 | 需要确认的内容 | | --- | --- | | 站点与入口 | 域名、代理、后端及是否能绕过代理直连 | | 运行时 | PHP 分支、SAPI、实际可执行文件或模块 | | 来源 | 发行版包、面板、自编译程序或容器镜像 | | 配置 | 实际加载的配置、FPM池及站点覆盖项 | | 修复状态 | 安全公告、完整包版本或镜像摘要 | | 进程 | 何时替换旧worker,如何验证新请求 | 必要时,可在**仅管理员可访问**的临时诊断路径中返回最小信息: ```php PHP_VERSION, 'sapi' => PHP_SAPI, ]); ``` 通过真实 Web 路径访问,再与配置、包记录交叉核对。检查完成后删除该路径;不要长期公开 `phpinfo()` 页面。此方法只辅助识别运行时,不是漏洞扫描或“未被入侵”的证明。 ## 排查第二步:正确理解发行版的补丁回移 上游修复版本表不能直接替代发行版安全通知。发行版可能保留较旧的上游版本前缀,把修复回移到自己的包修订中。 例如,Ubuntu [USN-8948-1](https://ubuntu.com/security/notices/USN-8948-1)列出的修复包包括: | Ubuntu 版本 | 对应修复包版本 | | --- | --- | | 22.04 LTS | 8.1.2-1ubuntu2.28 | | 24.04 LTS | 8.3.6-0ubuntu0.24.04.13 | | 26.04 LTS | 8.5.4-0ubuntu1.5 | | 26.10 | 8.5.9-0ubuntu2.1 | 这张表只适用于该 Ubuntu 公告和对应包来源。不能拿它判断第三方 PPA、面板或自行编译的同名版本。 以 Ubuntu 24.04 的 FPM 部署为例,先核对已安装包和候选包: ```bash dpkg-query -W 'php8.3*' apt-cache policy php8.3-fpm php8.3-cli ``` 同时确认软件源来自哪里,候选版本是否已包含修复。Ubuntu 官方另有[此次更新说明](https://ubuntu.com/blog/php2shell-vulnerability-fixes-available),旧发行版的修复可能需要相应 ESM 支持。 ## 修复第三步:升级,再替换旧工作进程 ### 发行版包:更新实际安装的组件 先完成配置和业务数据备份,确认包来源、扩展兼容性及恢复方式,再按发行版公告升级。下面仅是 Ubuntu 24.04 已使用 PHP 8.3 FPM 和 CLI 的示例,不适用于所有主机: ```bash sudo apt update sudo apt install --only-upgrade php8.3-fpm php8.3-cli sudo php-fpm8.3 -tt sudo systemctl restart php8.3-fpm sudo systemctl --no-pager --full status php8.3-fpm ``` 还应核对实际安装的 common、扩展包及依赖是否同步更新。Apache mod\_php 需要更新对应模块并替换加载该模块的 Apache 进程;仅重启 Nginx 不会替换 FPM。服务名称按实际部署填写。 Ubuntu 明确提醒:包升级后,使用 PHP 的应用通常还需要重启。不要把包管理器成功退出当成全部运行中进程已经完成更新。[Ubuntu 修复说明](https://ubuntu.com/blog/php2shell-vulnerability-fixes-available) ### 容器与面板:更新网站实际使用的那套运行时 容器场景先核对镜像来源和发布方的修复信息,再更新基础镜像或依赖包,构建或拉取包含补丁的镜像并重建服务。**重启旧容器会继续使用旧文件系统**;只更新宿主机 PHP 也不会自动修改镜像中的解释器。 记录新镜像摘要、容器启动时间和 Web 检查结果。若存在多个副本,应确认每个副本都已替换,避免部分请求继续落到旧环境。 面板部署同样要逐站核对绑定的 PHP。面板显示“安装了新版本”,不等于站点已切换,也不等于原 FPM 池已经退出。  确认新请求实际使用更新后的运行时,而不只检查安装目录。 ## 暂时不能升级,哪些措施只能争取时间? **完整修复依赖补丁。** 临时配置只能减少部分路径的暴露,不能作为长期替代。 | 常见做法 | 应如何理解 | | --- | --- | | 关闭 `session.upload_progress.enabled` | 只能阻断已确认的部分会话路径,不能覆盖两个漏洞的所有变体 | | 在业务代码里调用 `ini_set()` | 对早于应用代码的解析或初始化来得太晚 | | 降低请求体大小、过滤不需要的 multipart | 可缩小暴露面,但不能证明所有内存消耗路径均被阻断 | | 隐藏 PHP 错误输出 | 隐藏提示不等于消除内部状态读取 | | 启用 WAF | 作为纵深防护,不能替代运行时更新 | 其中,PHP 的[上传进度文档](https://www.php.net/manual/en/session.upload-progress.php)说明,相关会话信息在脚本执行前就会写入;[状态漏洞通告](https://github.com/php/php-src/security/advisories/GHSA-6wmf-4rv5-p3rp)也明确指出,抑制错误显示不能消除相应风险。 另一个容易误用的选项是 `memory_limit=-1`。它可减少受控 PHP 内存上限触发的部分 OOM 路径,但底层分配失败仍可能到达漏洞代码,而且取消限制会带来资源耗尽风险。不能照抄后宣布安全,也不能随意用地址空间限制代替,后者可能恰好制造分配失败。[OOM 通告的缓解边界](https://github.com/php/php-src/security/advisories/GHSA-w8hw-w9fx-j79w) 如果短时间无法确认修复,可以先限制暴露入口或暂停受影响服务,再安排补丁和恢复验证。前端限制应覆盖实际可达路径,不能只保护某个页面、某个域名或一条上传路由。 ## 升级完成后,怎样验收? 至少保留以下结果: 1. **版本证据**:上游修复版本,或发行版公告对应的完整包版本。 2. **进程证据**:旧worker已退出,新请求由更新后的进程或容器处理。 3. **业务证据**:首页、登录、表单、上传及后台等关键路径正常。 4. **配置证据**:临时诊断页面已移除,临时限制有明确保留或撤销计划。 5. **排查记录**:异常请求、错误日志、子进程和文件变化是否需要进一步调查。 内存不足、worker退出或异常大表单,单独出现都不能证明攻击成功;没有这些日志,也不能证明从未被利用。如果发现 PHP 进程启动异常命令、出现未知脚本或配置被修改,应保留证据并进入事件处置,而不是打完补丁就结束。 此次整改的终点,是实际对外服务已经使用含修复的 PHP,旧进程已被替换,并完成业务与异常核查。仅有一张 CLI 版本截图,无法说明所有站点、容器和副本都已修复。 --- --- title: "eMudhra 中间 CA 弱密钥事件:Firefox 为什么紧急更新?" source: https://www.iowill.com/blog/2026/10/emudhra-intermediate-ca-weak-keys/ date: 2026-10-22 updated: 2026-10-22 tags: [Firefox, HTTPS, TLS, 数字证书, 网络安全] categories: [系统与运维] --- # eMudhra 中间 CA 弱密钥事件:Firefox 为什么紧急更新? 2026年10月,eMudhra 的八个中间 CA 被发现使用了极弱的私钥。问题严重到浏览器厂商需要迅速封禁相关证书,再通过软件更新和信任库调整扩大保护范围。 Mozilla 在10月20日发布的 [MFSA 2026-111](https://www.mozilla.org/en-US/security/advisories/mfsa2026-111/) 中收录了相关问题 **CVE-2026-113470**,评级为 high,Firefox 158.0.1 包含对应保护更新。 这不是“Firefox 的加密算法被攻破”。出问题的是一组承担签发职责的 CA 密钥,以及客户端需要及时撤回对它们的信任。 本文依据截至 **2026年10月22日** 查到的公开资料整理,属于事件分析;没有对本站证书、用户服务器或受影响密钥进行攻击复现。调查仍在继续,后续结论应以公告更新为准。 ## 中间 CA、根证书与网站证书的区别 访问 HTTPS 网站时,浏览器除了协商加密连接,还需要判断:眼前这个服务器是否有资格代表这个域名? 常见的证书链可以简化成: ```text 客户端信任的根 CA ↓ 签发 中间 CA ↓ 签发 网站的 TLS 证书 ``` 网站证书用于证明网站身份,中间 CA 则有继续签发证书的权限。因此,中间 CA 私钥失去安全性,影响不只是某一台网站服务器。 本次需要分开的三个概念是: | 概念 | 含义 | | --- | --- | | 中间 CA 私钥可被恢复 | 攻击者可能获得签发能力,这是此次事件的核心 | | 中间 CA 证书被吊销或封禁 | 客户端应拒绝继续接受相关签发链 | | 根证书被移出信任库 | 进一步撤回信任,可能影响该根下其他正常证书链 | **移除根证书不能直接证明根私钥也被窃取。** eMudhra 表示根私钥未受影响;这属于其公开声明中的范围说明,不等于整个调查已结束。[eMudhra 事件声明](https://emudhra.com/en/post/certificate-security-incident)  图为概念示意,根证书移除不代表根私钥泄露。 ## 私钥为什么会弱到可以恢复? [CERT-In 的公告](https://www.cert-in.org.in/s2cMainServlet?CACODE=CICA-2026-3649&pageid=PUBADV01)指出,受影响的 P-384 私钥数值小于256,可从对应公钥迅速恢复。它同时明确:问题出在密钥生成,不能据此认为 P-384 算法本身存在漏洞。 可以把它理解成:锁具本来允许选择极大的密码空间,但实际部署时,密码只在一小撮候选值里挑选。锁具的标称规格还在,真正支撑安全性的随机性却丢了。 这也解释了为什么“私钥没有从服务器文件里被下载”不能排除失陷。如果密钥生成得足够糟,攻击者只看公开材料,也可能恢复出秘密。 这里用“弱密钥导致私钥可恢复”,比笼统写成“黑客入侵后盗走私钥”更接近已经公开的技术事实。 至于具体流程,eMudhra 在10月21日的更新中称,密钥生成仪式中的 wrap/unwrap 环节产生了另一组弱密钥,并被错误用于后续流程;该公司同时说明,确切根因仍待确认。因此,这一解释应标为**厂商调查中的说明**,不能写成已经完成的独立审计结论。[eMudhra 最新更新](https://emudhra.com/en/post/certificate-security-incident) ## 哪些风险成立,哪些说法越过了证据? Mozilla 的 [Bugzilla 2083449](https://bugzilla.mozilla.org/show_bug.cgi?id=2083449)记录了八个受影响的中间 CA,其中六个用于 TLS,另两个用于代码签名。不能把八个全部称为网站证书签发 CA。 对 TLS 来说,主要风险是攻击者利用可恢复的签发密钥,为不属于自己的域名制作伪造证书。如果客户端仍然信任该链,且攻击者能截获或引导网络连接,就可能冒充网站。私钥可恢复并不自动赋予攻击者拦截所有网络流量的能力。[Mozilla 安全博客](https://blog.mozilla.org/security/2026/10/20/protecting-firefox-users-following-the-compromise-of-emudhra-intermediate-certificates/) 同样,不能由此得出“以前所有 HTTPS 流量都能解密”。CA 签发密钥和连接协商出的流量密钥承担不同职责;TLS 1.3 中使用临时密钥交换的握手,还提供相应的前向保密性质。拿到 CA 签发密钥,不等于拿到历史连接的会话秘密。[TLS 1.3 标准 RFC 8446](https://www.rfc-editor.org/rfc/rfc8446.html) 另外两条范围信息也要保留出处: - eMudhra 表示,这些中间 CA 没有签发终端实体证书,绝大部分没有投入生产。这是厂商披露的情况,不能单凭这一点证明不存在任何未发现的恶意行为。[厂商声明](https://emudhra.com/en/post/certificate-security-incident) - Google 表示,在其封禁前,没有记录到链至相关六个 TLS 中间 CA 的证书进入证书透明度日志,因此对强制执行 CT 的客户端有额外保护。这一判断有明确的客户端条件,不能外推到所有旧系统和应用。[Google 安全博客](https://blog.google/security/protecting-chrome-and-android-users-from-compromised-emudhra-intermediate-ca-certificates/) 所以,风险很严重,但“全球网站证书全部失效”“所有加密通信已被监听”都不是这些资料能够支持的结论。 ## Mozilla 为什么先封禁,再发 Firefox 更新? 这次处置不是从10月20日发布新版本才开始的。 按照 [Mozilla 公布的时间线](https://blog.mozilla.org/security/2026/10/20/protecting-firefox-users-following-the-compromise-of-emudhra-intermediate-certificates/),它在10月17日20:06 UTC 收到报告,当天22:59 UTC 已完成面向标准配置 Firefox 用户的 OneCRL 分发。这一步不要求用户更新或重启浏览器。 | 时间,统一采用 UTC | 动作 | | --- | --- | | 10月17日20:06 | Mozilla 收到相关报告 | | 10月17日22:59 | Mozilla 完成标准配置客户端的 OneCRL 保护分发 | | 10月20日 | 发布安全公告与 Firefox / ESR 更新 | OneCRL 是 Mozilla 向客户端分发的集中封禁机制。更新软件与更新封禁信息是两条不同的交付路径。 MFSA 2026-111 解释了后续版本更新的作用:将更新后的 OneCRL 列表随版本提供,覆盖 RemoteSettings 被策略关闭,或网络环境导致其不可用的客户端。不能因为远程封禁已经完成,就认为所有定制环境都已获得保护。[MFSA 2026-111](https://www.mozilla.org/en-US/security/advisories/mfsa2026-111/) 对应版本与公告如下。这里列的是此次公告的修复版本,不代表永远应停留在这些版本;后续使用受支持渠道的更新版本即可。 | 分支 | 此次修复版本 | 公告 | | --- | --- | --- | | Firefox | 158.0.1 | [MFSA 2026-111](https://www.mozilla.org/en-US/security/advisories/mfsa2026-111/) | | Firefox ESR 153 | 153.5.1 | [MFSA 2026-112](https://www.mozilla.org/en-US/security/advisories/mfsa2026-112/) | | Firefox ESR 115 | 115.43.1 | [MFSA 2026-113](https://www.mozilla.org/en-US/security/advisories/mfsa2026-113/) | 发布前复核还发现一个后续修复:Mozilla 在 [Bugzilla 2083449 的评论29](https://bugzilla.mozilla.org/show_bug.cgi?id=2083449#c29)中说明,部分 Android 配置在启动时没有应用更新后的封禁列表,修复已随 **Firefox Android 158.0.2** 推送;[官方发布说明](https://www.firefox.com/en-US/firefox/android/158.0.2/releasenotes/)也确认了这项启动加载修复。因此 Android 用户不要只对照上表停在158.0.1,应更新至包含该后续修复的受支持版本。 MFSA 是公告编号,CVE 是问题标识,Bugzilla 则记录具体工作事项。MFSA 2026-111 中与本事件对应的引用是 Bug 2083382;讨论 CA 事件本身的是 Bug 2083449,不应把这几个编号混用。 ## 为什么更新了浏览器,还要关心系统信任库? 浏览器能够迅速更新自己的封禁信息,但服务器程序、旧设备、容器和嵌入式应用未必接收同一条更新通道。 CERT-In 记录了 NSS 3.131.1 对 `emSign ECC Root CA - G3` 的移除。它服务于更广的信任库消费者,不能假定应用仅因为“使用 Mozilla 来源的证书列表”,就一定会收到 Firefox 的 OneCRL 更新。[CERT-In 公告](https://www.cert-in.org.in/s2cMainServlet?CACODE=CICA-2026-3649&pageid=PUBADV01) Google 则先通过 CRLSet 按受影响公钥的 SPKI 哈希封禁,并宣布移除 Chrome Root Store 中的相关根。其公开计划是让根移除于 **2026年10月27日美国太平洋夏令时上午**覆盖依赖该根库的设备。截至本文资料截止日,这仍是预告,不能写成已全量完成。[Google 公告](https://blog.google/security/protecting-chrome-and-android-users-from-compromised-emudhra-intermediate-ca-certificates/) 这也带来可用性问题:弱中间 CA 被封禁,与整条根信任被撤回,覆盖范围可能不同。网站原先的链即使没有经过那六个 TLS 中间 CA,也可能因为终点根证书被移除而失败。  三条路径覆盖不同客户端,Android后续修复与Chrome计划时间应分别核对。 ## 普通用户和站长分别做什么? ### 普通用户:更新实际使用的客户端 按浏览器及系统提供的正常渠道更新,并完成必要的重启。企业管理的 Firefox 还应检查策略和远程配置分发是否正常;“安装了 Firefox”不等于“远程封禁列表一定已送达”。此次版本更新正是为了补足这些场景。 遇到证书警告时,不应通过永久跳过校验来恢复访问。否则客户端即使具备新的信任决策,也无法发挥作用。 ### 站长:核对完整证书链,而不只看证书是否到期 先查证书供应商与浏览器厂商公告,再检查站点实际提供的链和目标客户端构建出的链。若链至被移除的根,应按供应商方案迁移到仍受目标客户端信任的其他层级,并验证部署结果。Google 已明确要求相关站长及时替换证书链。[站长处置要求](https://blog.google/security/protecting-chrome-and-android-users-from-compromised-emudhra-intermediate-ca-certificates/) Linux / macOS shell 下的只读诊断示例如下,将 `example.com` 换成自己的域名: ```bash openssl s_client \ -connect example.com:443 \ -servername example.com \ -showcerts \ -verify_hostname example.com \ -verify_return_error limitCount` 的逻辑,恰好150不追加,从151开始追加。 开启配置只是启用原生机制。默认输出格式和作用范围仍要看当前主题代码,不能以为改了开关就自动变成上面的单行样式。 这次相关的源文件有三个: | 文件 | 作用 | | --- | --- | | `hexo/_config.butterfly.yml` | 启用功能、设置阈值和脚本版本 | | `hexo/themes/butterfly/layout/includes/head/config.pug` | 将配置和提示文字传给前端 | | `hexo/themes/butterfly/source/js/main.js` | 在复制时检查选区并写入剪贴板 | 这些是本站保存在仓库中的主题源文件。其他项目的主题可能通过 npm 安装,或者目录结构不同,要先确认自己的维护入口;不要直接修改生成目录或依赖缓存。 ## 将默认多行声明改成一行 原生模板会生成 `GLOBAL_CONFIG.copyright`,其中包含长度阈值和文案。本站保留了原有对象结构,只调整其中两项: ```javascript languages: { author: _p("copy_copyright.author") + ': ' + config.author, link: _p("copy_copyright.link") + ': ', source: '来源:' + config.title, info: '转载请注明出处' } ``` 这是 `config.pug` 中服务端配置对象的一部分,并不是让浏览器直接执行 `_p()`。它仍经过原有的 `JSON.stringify()` 流程输出到页面。 随后在主题现有的 `addCopyright()` 中拼出最终文案: ```javascript const textFont = `${copyFont}\n\n${languages.source}|原文:${url}|${languages.info}` ``` 两个换行让来源与复制的正文分开,声明自身保持一行。`config.title` 读取站点标题,当前就是“Billy 的博客”,不需要在多个页面手工重复填写。 下面的修改应替换现有处理逻辑,不要另外叠加第二个全局复制监听器,否则容易出现重复追加或事件互相覆盖。 ## 只接管符合条件的正文选区 关键不在拼接字符串,而在决定什么时候接管复制。本站现有 `handleCopy` 调整为: ```javascript const handleCopy = e => { const selection = window.getSelection() const article = document.getElementById('article-container') if (!selection || !article || !article.contains(selection.anchorNode) || !article.contains(selection.focusNode)) return const elementOf = node => node.nodeType === Node.ELEMENT_NODE ? node : node.parentElement const codeBlock = elementOf(selection.anchorNode) .closest('pre, figure.highlight') if (codeBlock && codeBlock.contains(selection.focusNode)) return if (document.activeElement?.matches( 'input, textarea, [contenteditable="true"]' )) return const copyFont = selection.toString() if (copyFont.length <= limitCount) return const url = document.querySelector('link[rel="canonical"]')?.href || window.location.href const textFont = `${copyFont}\n\n${languages.source}|原文:${url}|${languages.info}` e.preventDefault() if (e.clipboardData) { return e.clipboardData.setData('text', textFont) } else { return window.clipboardData.setData('text', textFont) } } ``` 这段处理仍放在主题已有的 `addCopyright()` 作用域里,沿用前面解构得到的 `limitCount` 和 `languages`,以及原有的事件注册: ```javascript document.body.addEventListener('copy', handleCopy) ``` 前面的几个 `return` 都不会阻止默认复制。只有选区和长度满足条件,才调用 `preventDefault()`,把加上来源后的文本写入剪贴板。`copy` 事件中修改写入内容的机制,可以参考 [MDN copy 事件文档](https://developer.mozilla.org/en-US/docs/Web/API/Element/copy_event)。 选区的起点和终点都需要落在 `#article-container` 内;完全处在同一个代码块中的选区则跳过。这样复制整段配置时,不会在末尾混入一行无法执行的转载提示。 代码工具栏另有一条路径:这个版本的 Butterfly 使用 `navigator.clipboard.writeText()` 直接写入代码。本站没有给这条路径追加声明,并用实际按钮点击验证了结果。[MDN writeText 文档](https://developer.mozilla.org/en-US/docs/Web/API/Clipboard/writeText)说明了这个接口;浏览器权限与安全上下文要求也应在测试时考虑。 ## 原文地址为什么取 canonical 如果直接使用 `window.location.href`,来源可能带上查询参数、文章锚点,或者变成 `www` 域名下的地址。 本站文章已有指向 `https://www.iowill.com/` 的 canonical,因此优先从页面读取: ```javascript const url = document.querySelector('link[rel="canonical"]')?.href || window.location.href ``` 这沿用了网站自己的正式地址约定。即使从其他入口打开文章,复制出处也能落到统一链接。页面没有 canonical 时才退回当前地址,因此发布前仍要检查 canonical 本身正确,不能把错误的配置当成可靠来源。 ## 测试时真的按一次复制键 只检查配置值或者调用字符串拼接函数,无法证明浏览器实际复制的结果正确。 本站使用 Playwright 启动 Chromium,给测试上下文授予剪贴板读写权限,打开已经生成的文章页面。在页面中建立选区后,执行: ```python page.keyboard.press('Control+c') copied = page.evaluate('navigator.clipboard.readText()') ``` 本地回归通过的项目包括: - 151字符正文,完整结果等于“选中内容 + 空行 + 指定来源行”。 - 150字符正文,不追加。 - 200字符代码块和正文外选区,不追加。 - 原生代码复制按钮能复制内容,结果里没有来源行。 - 测试页面带查询参数和锚点,追加的地址仍使用文章 canonical。 这部分回归位于 `hexo/bin/test_copy_copyright.py`,使用构建产物启动本地 HTTP 服务,不向线上文章注入测试内容。 上线后又在正式域名的现有文章中选取多段真实正文,实际复制并读取剪贴板,核对了整段文字与来源行,结果符合预期。 这次验证确认的是 Chromium 中的复制结果,并没有把它扩大成所有手机浏览器、阅读器或富文本应用都已测试。当前接管的长文本复制写入的是纯文本,粘贴到不同应用后的呈现仍可能不同。  ## 发布后,确认页面加载的是新脚本 代码改完后还有一个常见误区:页面已经更新,浏览器拿到的 `main.js` 却仍是缓存版本。 本站给主题脚本的引用增加了版本参数: ```yaml CDN: option: main: /js/main.js?v=20261022-copy ``` 这是配置片段,应合并到原有 `CDN.option`,不要覆盖其他脚本配置。 随后按本站流程构建、校验、备份发布,再推送由 Cloudflare Pages 构建。最终检查的不只是源文件,而是线上 HTML 是否真的引用了带版本参数的脚本,以及实际剪贴板内容是否变化。 这次发布对应提交 `2656be77`,Cloudflare 部署成功后,正式域名的复制测试也通过。文章正文、原始发布日期和底部许可没有因这项功能而被改写。 ## 它能留下来源,但不能锁住内容 这行声明适合让普通复制带上出处,尤其是把一段说明转发到笔记或聊天时,别人还可以回到原文查看完整上下文。 但对方可以删掉声明,采集程序也可以直接读取 HTML,不触发浏览器里的复制事件。它不能证明站点已经防住整站镜像,也没有替代文章原有许可、图片水印或服务端流量防护。 对技术博客来说,我更看重的是把来源信息补得恰当:复制较长正文时带上链接,复制命令和代码时保持干净。功能是否实现,可以通过真实剪贴板检查;是否从此无人搬运,则不能由这一行文字保证。 --- --- title: "llms.txt 是什么?博客要不要加,它和 robots.txt 有什么区别?" source: https://www.iowill.com/blog/2026/10/llms-txt-for-hexo-blog/ date: 2026-10-21 updated: 2026-11-11 tags: [AI搜索, Hexo, SEO, llms.txt, 文档维护] categories: [软件与工具] --- # llms.txt 是什么?博客要不要加,它和 robots.txt 有什么区别? 给博客做 AI 搜索优化时,很容易遇到一条建议:在网站根目录放一个 `llms.txt`。 文件很小,名字又像 `robots.txt`,看上去像是另一个必须补齐的站点配置。但把它加上,AI 就会来读、就会收录,甚至更愿意推荐这个博客吗? 这些问题需要分开回答。`llms.txt` 有明确的内容组织用途,部署成本也可以很低;是否被某个工具使用、是否最终出现在回答里,则不能由文件存在与否推定。 这篇文章初稿按 2026 年 10 月 21 日可查的提案和官方文档整理。2026 年 11 月 11 日补充本站接入情况:已使用 `hexo-generator-llms@0.1.1`,随构建生成 [llms.txt](https://www.iowill.com/llms.txt)、[llms-full.txt](https://www.iowill.com/llms-full.txt) 和已发布文章的 Markdown 阅读版本。下方手工精选文件仍为写法示例;本站当前索引覆盖已发布文章,并非人工精选清单。文件生成与上线核验不代表已验证 AI 工具使用或搜索效果。 ## llms.txt 是一份怎样的文件 可以把它看作网站为 AI 阅读工具准备的一页导览:说明站点讲什么、重要内容在哪里,以及阅读时需要知道的背景。 [llms.txt 提案](https://llmstxt.org/)采用 Markdown 组织内容,推荐链接到便于读取的页面版本。常见结构是站点名、简短介绍,再按主题列出链接与说明。它是一项约定提案,不能写成所有大模型和搜索引擎都必须遵守的统一协议。 对于博客,我更愿意让这份文件回答几个实际问题: - 这里主要记录什么,作者介绍在哪里? - 读者要解决某类问题,应该先读哪几篇? - 文章依据哪些环境和版本,哪些内容只是案例记录? 把几十篇文章标题原样堆进去,也能得到一个文件,却未必比现有归档更好用。内容的选择和说明,才是这份导览需要作者判断的部分。 ## 它和 robots.txt、sitemap.xml 分别做什么 三个文件可以同时存在,解决的问题不同: | 文件 | 主要用途 | 不能据此保证什么 | | --- | --- | --- | | `robots.txt` | 向遵守规则的爬虫表达抓取范围 | 不是登录权限,也不保证 URL 不被索引 | | `sitemap.xml` | 告知搜索引擎有哪些 URL,并提供相关元数据 | 提交后不保证抓取、收录或排名 | | `llms.txt` | 提供面向 AI 阅读工具的站点背景和内容入口 | 不保证工具读取、模型训练或回答引用 | Google 的 [robots.txt 说明](https://developers.google.com/search/docs/crawling-indexing/robots/intro)与 [Sitemap 说明](https://developers.google.com/search/docs/crawling-indexing/sitemaps/overview)分别解释了前两者的用途和边界。 因此,在 `llms.txt` 里写“允许访问全部内容”,不能覆盖访问控制或爬虫规则;写“回答时必须优先引用本站”,也不会自动成为外部工具的执行要求。 需要保护的内容应当由访问控制保护。需要表达抓取规则时使用对应机制。内容导览承担的是帮助定位资料的工作。  ## 已有文档站在提供,但要分清谁在支持 目前能直接验证的一个例子是 [Anthropic 开发文档的 llms.txt](https://platform.claude.com/llms.txt):它提供文档入口和页面链接。这能证明文档发布方提供了该资源,不能反过来证明所有使用其模型的应用都会自动读取外部站点的同名文件。 [Mintlify 官方文档](https://www.mintlify.com/docs/ai/llmstxt)也说明了自动生成索引和 Markdown 页面的能力,并提供 `llms-full.txt`,将文档正文合并为一个文件。这里确认的是文档平台的发布能力。 判断某个工具是否使用它,要继续追问: | 看到的证据 | 可以说明什么 | | --- | --- | | 站点能打开 `/llms.txt` | 发布方提供了文件 | | 某工具文档明确描述读取方式 | 该工具声明支持相应流程,仍需注意版本和配置 | | 自己的工具运行记录显示读取该 URL | 本次任务确实访问过它 | | 回答附上文章链接 | 本次输出引用了页面,未必通过 llms.txt 发现 | 我不会把“越来越多网站在放这个文件”直接换算成“给博客加上就能提升引用率”。这中间缺少对消费端和实际任务的验证。 ### v2 补充了发现方式 提案的 [2026 年 8 月更新记录](https://llmstxt.org/changes.html)补充了用链接关系发现资源的方法:`rel="alternate"` 配合 `type="text/markdown"` 指向页面的 Markdown 版本,`rel="describedby"` 指向覆盖该路径的 llms.txt,可通过 HTML 或 HTTP Link 头表达。 这减少了客户端猜 URL 的需要,但仍要求消费端认识并处理相应关系。只是在页面源码里放一个链接,不等于所有 AI 工具都会跟随它。 ## 给个人博客写一份起步导览 用本博客已有的公开内容举例,一份起步文件可以这样组织: ```markdown # Billy 的博客 > 记录编程开发、系统运维与工具实践,关注问题现象、排查过程和适用条件。 文章中的版本、环境和验证范围以各篇正文为准。 ## 关于 - [作者与博客介绍](https://www.iowill.com/about/): 内容方向与交流入口。 ## 系统与运维 - [Docker 部署 WebDAV](https://www.iowill.com/blog/2026/10/docker-webdav-file-sharing/): 配置、验证与常见故障。 - [MySQL 与 PHP 时区排查](https://www.iowill.com/blog/2026/10/empire-cms-schedule-mysql-timezone/): 赛程筛选与日期解释不一致的案例。 ## 编程开发 - [Cookie 获取和使用差异](https://www.iowill.com/blog/2026/10/kuaishou-douyin-cookie-login-differences/): 区分导入成功、业务登录与当前账号身份。 ## Optional - [文章归档](https://www.iowill.com/archives/): 按时间浏览其他内容。 ``` 这份示例有意使用实际存在的 HTML 页面地址,没有为它们编造 `.md` 链接。它先展示站点导览的组织方式;如果要按提案提供更便于工具读取的内容,还应另外发布经过整理的 Markdown 页面。 链接说明尽量描述文章解决的问题。没有测过的内容,不写成实测结论;不用“全网最权威”之类宣传词,也不把同一组关键词复制到每个条目后面。 至于 `llms-full.txt`,个人博客可以先不做。将全部正文合并,会增加体积,也让局部更新和按需选文变得不直观。只有确实需要整站离线阅读或批量上下文输入时,再判断它是否值得维护。这是维护成本上的取舍,不是文件越大效果越好。 ## Hexo 博客怎样接入 对于普通 Hexo 项目,手工维护起步文件时,可以把它放到源目录: ```text hexo/ source/ llms.txt ``` 再检查配置,确保文件按预期原样复制,不被套上页面模板。如果需要显式跳过渲染,可以在 `_config.yml` 原有 `skip_render` 列表中追加文件名,保留已有条目: ```yaml skip_render: - llms.txt ``` 构建后检查的是 `public/llms.txt`,不是只检查源目录。Hexo 的生成行为可参考[官方生成文档](https://hexo.io/docs/generating)。 本博客还有一层自己的发布约束:Cloudflare 和 Actions 的输出目录均限定为 `hexo/public`,`check_publish_tree.py` 与本地 `release.py` 维护允许发布的路径。当前白名单已包含两个 llms 文件,以及实际已发布文章对应的 `index.md`,没有放开任意源文件。 本站当前使用的 [hexo-generator-llms](https://github.com/SSARCandy/hexo-generator-llms) 从已渲染文章生成 Markdown,文章 HTML 同时提供 `rel="alternate" type="text/markdown"` 发现链接。新文、修订与到期提升的排期稿随正常构建更新;草稿、未来稿及维护文档不进入输出。直接在仓库根目录手写一个文件,仍不会自动进入云端上传的产物。 ### 文章更新时,导览也要更新 手工精选适合小规模起步;文章持续增长后,可以将“选择哪些文章”与“生成哪些文字”分开维护。 例如,在源数据中保留精选文章的永久链接,生成时从 Hexo 文章模型读取标题、摘要和 URL。文章重命名或修订摘要后,输出随构建更新;指定链接不存在时让校验报错,避免留下静默失效的入口。 [Hexo Generator API](https://hexo.io/api/generator)允许生成器返回输出路径和内容。这适合接入构建,而不是发布之后再手工修改生成文件。 设计时我会保留几条检查: - 只引用已发布内容,排除草稿、未来文章和维护文件。 - 使用文章实际永久链接,不从标题重新猜路径。 - 保持稳定顺序,只有内容变化才改变输出。 - 不默认把所有文章都加入精选列表。 ### Markdown 正文也需要可靠来源 本站新文章使用 Markdown,历史文章中还有带 front matter 的 HTML。二者不能简单地改个文件扩展名,就都宣称成了干净的 Markdown。 本站现已提供 Markdown 阅读入口,新文章和历史 HTML 都从渲染后的正文转换,输出包含原文 `source`,不复制完整的构建配置。接入回归检查了代码、表格、图片与链接,并排除了页面样式和脚本;复杂交互及部分手工锚点仍应以原 HTML 为准,不能把转换结果视为无损替代。 小规模站点也可以先给少数精选文章提供经过核对的正文版本,再逐步扩大。本站当前采用完整索引,每次构建检查文章、Markdown、索引和全文的一一对应,以及原文发现链接;具体工具是否读取这些资源,仍需另做观察。 ## 验证文件可读,也验证它是否被使用 发布后可以先做最直接的检查: ```bash curl -i https://example.com/llms.txt ``` 将示例域名替换为自己的站点,检查状态码、响应类型和正文,确认没有返回 404、验证页或整张 HTML 首页。然后逐项访问链接,检查它们是否指向公开且内容正确的页面。 如果提供 Markdown 版本,还要打开正文核对。仅有 HTTP 200 并不够:文件可能缺少代码块、图片说明,或仍包含导航与模板噪声。 验证时可以选择一个能查看网络或工具调用记录的 AI 阅读流程,给它明确任务,例如“找出本站 WebDAV 文章中的配置前提并列出来源”。再检查它实际读取了哪些 URL,是否沿导览进入目标文章,以及最终引用是否准确。这是建议的验证方法,本文没有把它写成已经完成的实验。  服务器或 CDN 日志能帮助确认文件被请求,但不能单凭 User-Agent 字符串确认访问者身份,更不能由一次请求证明文章进入了模型训练或排名系统。 ## llms.txt 的维护条件与采用建议 如果博客已经有清晰的内容结构,精选文章也会持续维护,增加一份小型导览可以作为内容分发实验。反过来,如果正文经常过期、链接已经失效,先修正文通常更值得投入时间。 对于 Google 搜索中的 AI Overviews 和 AI Mode,[官方说明](https://developers.google.com/search/docs/appearance/ai-features)明确指出,不需要额外创建 AI 文本文件,也没有特殊的附加技术要求;符合基本条件同样不保证抓取、索引或展示。这项说明针对 Google 的这些搜索功能,不能延伸成所有 AI 产品的统一行为。 我的判断是:可以把 `llms.txt` 当作一份需要维护的内容入口,评估它是否帮助具体工具找到准确资料。文件能否正常读取、链接是否有效、正文是否可靠,都可以检查;“加上以后大模型一定推荐我”,则不能作为发布后的验收标准。 --- --- title: "快手与抖音 Cookie 获取和使用差异:导入成功,为什么还没登录?" source: https://www.iowill.com/blog/2026/10/kuaishou-douyin-cookie-login-differences/ date: 2026-10-20 updated: 2026-10-20 tags: [Cookie, Playwright, 快手, 抖音, 故障排查, 浏览器自动化] categories: [编程开发] --- # 快手与抖音 Cookie 获取和使用差异:导入成功,为什么还没登录? 把抖音账号管理流程适配到快手时,最初的现象有些迷惑:浏览器能启动,Cookie 能解析、注入,推荐页也正常打开,但侧栏仍然显示“立即登录”。 继续检查才发现,复制的是快手创作者服务平台的 Cookie,自动化打开的却是快手主站。更换为主站正常登录后的 Cookie,用户反馈“可以登录”。 这个过程提醒我,迁移账号管理功能时,不能只替换域名和选择器。**Cookie 被浏览器接受、目标业务识别为登录、程序读到正确账号,是三步不同的验证。** 本文整理自 2026 年 10 月 20 日的适配记录,项目实现分别对应 dyDM `c27c2d0` 与 ksDM `a96b329`。下文讨论正常登录后的本机自动化与会话复用,示例不包含真实凭据;登录成功来自当日用户反馈,资料读取、账号保存和跨重启复用仍需单独验收。 ## 先确认 Cookie 是从哪个页面取来的 原来 dyDM 的使用指南推荐在同一网络环境下,登录抖音创作者中心,然后从开发者工具复制请求 Cookie。 沿用这套操作习惯,第一次快手样本取自 `cp.kuaishou.com`。但 ksDM 的目标页面是: ```text https://www.kuaishou.com/new-reco ``` 创作者服务平台与推荐主站属于不同的业务入口。它们可能有登录关联,也可能使用不同的业务凭据;实际能否恢复登录,需要在目标页面验证。 两次样本中,与辨别来源有关的字段如下。这里仅列字段名和产品标记,没有令牌值: | 观察项 | 此次失败样本 | 此次成功样本 | | --- | --- | --- | | 复制来源 | 快手创作者服务平台 | 快手主站登录后的请求 | | 业务字段 | `kuaishou.web.cp.api_st`、`kuaishou.web.cp.api_ph` | `kuaishou.server.webday7_st`、`kuaishou.server.webday7_ph` | | 产品标记 | `kwpsecproductname=onvideo-cp` | `kwpsecproductname=kuaishou-vision` | | 目标主站结果 | 仍显示“立即登录” | 用户反馈可以登录 | 这些字段帮助定位了本次样本的区别,**不是官方公布的完整必填清单**。不能只留下表中的两个字段就保证登录,也不能因为名称里有 `day7`,就断言会话一定有效七天。 这次也没有重新独立测试抖音所有子站之间的登录关系。因此,dyDM 原指南的做法不能推导成“抖音的创作者平台 Cookie 在所有场景都适用于主站”。 ## HTTP 200,没有替页面完成登录验证 排查快手旧样本时,观察到当时前端使用 `/rest/v/profile/get` 获取当前账号状态。请求返回 HTTP 200,响应体却是: ```json {"result": 109} ``` 同时,页面仍有可见的 `.sidebar-login-button`,显示“立即登录”,没有进入当前账号状态。 这里可以确定的是:**该样本未能在目标主站恢复登录**。HTTP 200 只说明请求返回了正常的 HTTP 响应,不等于账号业务验证通过。`109` 与本次未登录现象同时出现,但材料不足以将它解释为所有快手业务中固定的“Cookie 已过期”错误码。 如果只在 `add_cookies()` 没有报错时就提示“登录成功”,这个问题就会被藏起来。注入接口负责把数据放进浏览器,不替目标服务判断凭据是否有效。参数与作用范围可查 [Playwright add\_cookies 文档](https://playwright.dev/python/docs/api/class-browsercontext#browser-context-add-cookies)。  更换主站 Cookie 后的成功反馈覆盖“可以登录”。它还不代表昵称、快手号、统计读取、保存账号和重启后的会话复用已经全部通过线上验证。 ## 从目标站点获取请求 Cookie 排查主站登录时,先在正常浏览器中确认自己已经登录目标主站,再复制它实际发送的账号请求。这样能减少从不相关业务中取到凭据的可能。 ### 快手:本次成功的获取路径 1. 在 Chrome 中打开[快手推荐页](https://www.kuaishou.com/new-reco),正常登录,确认页面显示当前账号。 2. 按 F12 打开开发者工具,进入 **Network**,刷新页面。 3. 本次可以筛选 `/rest/v/profile/get`,确认请求来自目标主站。 4. 打开请求的 **Headers → Request Headers**,复制完整的 `Cookie` 值。 5. 在 ksDM 中导入并验证,从当前账号入口进入自己的主页,核对昵称和快手号后再保存。 接口路径是当日观察结果,不是长期稳定的公开接入协议。页面改版后,应寻找当前页面实际发起的账号状态请求,而不是机械等待旧路径。 ### 抖音:把既有操作说明与目标验证分开 dyDM 原指南的入口是[抖音创作者中心](https://creator.douyin.com/),这是已有项目说明。若排查的是主站自动化问题,可以先在 `www.douyin.com` 确认登录,进入自己的主页,在 Network 中选择主站与当前账号状态有关的请求,再复制其请求 Cookie,交给 dyDM 验证昵称和抖音号。 不要将“随便选一条请求”当作通用获取方法:图片 CDN、第三方统计或其他业务请求,可能没有携带目标页面需要的登录凭据。创作者中心取得的样本是否适用于当前主站,也以实际验证为准。 两个平台都要区分以下几种内容: | 复制内容 | 是否是这里需要的输入 | | --- | --- | | Request Headers 中的 `Cookie` 值 | 请求头文本导入需要的内容 | | Response Headers 中的 `Set-Cookie` | 服务端设置指令,不是同一种格式 | | 整段“Copy as cURL”结果 | 包含命令、其他头和可能的敏感信息,不能直接当 Cookie 文本 | | `document.cookie` 的输出 | 无法读取 HttpOnly Cookie,可能缺少关键字段 | 请求头与响应头、HttpOnly 的区别可参考 [MDN Cookie 指南](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Cookies)。真实值只在本机工具中使用,不放进博客、日志截图或公开样本。 ## 改 Domain 或字段名,不能把凭据换成另一种 这次很容易产生一个看似省事的想法:既然要用于主站,把 Domain 改成 `.kuaishou.com`,或者把字段名改成成功样本里的名称,是否就能用? 这里需要分清发送范围与服务端认可。Domain、Path、Secure、SameSite 等属性影响浏览器何时携带 Cookie;目标服务是否接受它,还取决于凭据本身。 将导入 Domain 改成 `.kuaishou.com`,并没有执行官方登录流程,也没有签发新的主站令牌。把 `kuaishou.web.cp.api_st` 改名为 `kuaishou.server.webday7_st`,同样不会让旧值变成合法的新凭据。本次解决方式是在目标主站正常登录后,重新取得完整请求 Cookie。 另外,请求头里的 Cookie 通常只有名称和值,不包含原始 Domain、Path、过期时间、HttpOnly 等属性。两个项目对文本导入补充默认域名和路径,是代码的简化策略;需要保留原属性时,要使用工具支持的结构化格式,并检查它来自正确站点。 ## 两个平台的差异,有一部分其实来自项目实现 核对代码后,有些看起来像“平台差异”的行为,是 dyDM 和 ksDM 当前做出的不同选择。 | 对比项 | dyDM `c27c2d0` | ksDM `a96b329` | | --- | --- | --- | | 自动化目标 | `www.douyin.com` | `www.kuaishou.com/new-reco` | | Cookie 导入格式 | 请求头文本、Netscape 文本、JSON 数组 | 请求头文本、JSON 数组或含 `cookies` 数组的对象 | | 文本导入补充属性 | `.douyin.com`、`/` | `.kuaishou.com`、`/` | | 当前账号主页 | `/user/…` | `/profile/…` | | 浏览器目录 | 已验证的抖音号及其哈希构造账号目录 | 独立账号 ID 下再分候选会话目录 | | 创建上下文后的 Cookie 策略 | 清空后注入调用方传入的快照 | 新导入进入候选目录;日常使用复用当前会话 | | 保存前的身份核对 | 读取完整昵称、抖音号 | 读取昵称、快手号及可信主页地址,已有账号还核对身份一致性 | ksDM 此版本不支持导入带 `origins` 的完整 `storage_state`。支持含 `cookies` 数组的对象,不代表同时支持恢复其中所有本地存储。 dyDM 关注 `sessionid`、`sessionid_ss`、`sid_tt` 等字段来协调浏览器任务,也不意味着这些名称就是抖音登录的完整必填协议。上述格式、目录与更新策略都以列出的代码版本为准。 不能把这张表写成“抖音要求每次清 Cookie,快手禁止清 Cookie”。这是实现差异,平台认证是否成功仍由目标业务验证。 ## 让新导入先验证,再替换原会话 Cookie 是某个时刻的快照,浏览器会话还可能包含 localStorage、IndexedDB 等状态。站点登录后也可能更新 Cookie。反复把早先保存的快照注入正在使用的目录,可能覆盖更新后的值。 ksDM 当前为新 Cookie 导入和重新登录建立候选会话。只有从候选会话读到可靠的主页资料,并成功保存账号记录,才把它切换为当前会话。失败或取消,不覆盖原来的已验证会话。 日常验证和打开主页则复用保存的目录,不再每次导航都清空本地存储。这个策略使“尝试一份新 Cookie”与“继续使用原账号”可以分开处理。  使用持久目录也不能保证所有状态永远有效。尤其 sessionStorage 不能仅凭目录持久化就承诺跨重启恢复;Cookie 快照、完整认证状态导出与持久浏览器目录,是不同的保存方式。[Playwright 认证状态文档](https://playwright.dev/python/docs/auth)说明了存储复用及 sessionStorage 的单独处理方式。 对比之下,dyDM 当前在创建上下文后执行 `clear_cookies()`,再 `add_cookies(cookies)`,其他本地状态可随持久账号目录保留。它的 Cookie 更新策略与 ksDM 不同;排查时应检查调用方传入的是哪一份快照,而不是只看到目录存在,就认为会话一定完整。 ## 找到用户主页,还要确认是谁的主页 推荐页同时存在当前账号头像和视频作者头像。读到一个 `/profile/…` 链接,只能说明找到了某个人的主页。 本次快手入口适配针对带“我的”标记的当前账号控件,处理悬停、点击昵称和头像,再等待官方主页地址。示意结构如下,昵称仅为占位: ```html
这是一条演示评论。
这是一条演示评论。
Billy 的代码手记
``` 分三步修改,每次保存后刷新页面: 1. **只改 HTML**:把 `class="nickname"` 改为 `class="aK7mQ2pL"`。文字仍在,但原来的紫色、背景和内边距不再匹配。 2. **再改 CSS**:把 `.nickname` 改为 `.aK7mQ2pL`。两边重新对应,样式恢复。 3. **一起换名**:把两处名称都改成 `billyName`。样式保持不变。 这个实验是手动改名,不是哈希生成器,也没有实现完整的 CSS Modules。它只验证最关键的一点:浏览器关心的是选择器能否匹配元素,不关心名称是否容易读懂。  *从左到右:名称匹配、只改 HTML 后失配、两边同步改名后重新匹配。* ## 用开发者工具检查类名和样式 先选中你关心的昵称或排名元素,在开发者工具的 Elements 面板看它有哪些类,再到 Styles 面板查看实际匹配的规则。看见一个陌生名称,不必先猜算法,先确认它控制的是颜色、间距还是布局。 如果想研究名称变化,就记录同一个元素在刷新、交互前后的类名与规则,同时检查页面加载的资源内容。只有一份 HTML,通常无法确认名称是在发布前、服务端还是浏览器里产生的。 写自己的组件时,通过工具提供的映射引用样式;做自己的页面测试时,优先使用语义定位或专用测试属性,避免把某次构建后的类名当成稳定接口。 在本文的榜单示例中,昵称始终是普通文本,改变的是元素与样式之间的标识。理解这套对应关系之后,再看实际页面,就能把“名称难读”“名称发生变化”和“为什么要这样设计”分开判断。 --- --- title: "Docker 部署 WebDAV:用 hacdias/webdav 搭建个人文件共享服务" source: https://www.iowill.com/blog/2026/10/docker-webdav-file-sharing/ date: 2026-10-04 updated: 2026-10-04 tags: [Docker, Docker Compose, WebDAV, 文件共享, 自托管] categories: [系统与运维] --- # Docker 部署 WebDAV:用 hacdias/webdav 搭建个人文件共享服务  如果只是想把服务器上的一个目录提供给电脑、手机和备份工具使用,可以先试试 WebDAV。它在 HTTP 上增加了目录、文件操作等能力;客户端是否支持挂载、锁定和大文件传输,要看具体实现。 这里使用 hacdias/webdav,配合 Docker Compose 管理配置和数据目录。先让服务只在宿主机上可访问,验证读写正常;需要给其他设备使用时,再开启服务自带的 TLS。整个方案只运行一个 WebDAV 容器,不需要管理面板或反向代理。 本文命令面向安装了 Docker Engine 和 Compose 插件的 Linux 主机,以普通 bridge 网络为例。域名 `dav.example.com` 是示例,公网访问时替换为自己的域名。以下响应码是验证预期,不是某台服务器的实测日志。 ## 三个路径与两个监听地址  配置文件在宿主机上保存,容器读取它;上传文件则写到单独的数据目录。容器更新后,仍然挂载同一份目录。 | 宿主机位置 | 容器内位置 | 用途 | | --- | --- | --- | | `/opt/webdav/config/` | `/config/` | 服务配置,只读挂载 | | `/opt/webdav/data/` | `/data/` | 用户文件,可读写 | | `/opt/webdav/certs/` | `/certs/` | 开启 HTTPS 时使用的证书,只读挂载 | 地址也有两层:配置中的 `0.0.0.0` 是应用在容器内的监听地址;Compose 中的 `127.0.0.1:6065:6065` 则把宿主机入口限制在回环地址。它们并不矛盾。Docker 的端口发布规则决定外部怎样进入容器,不能把容器自己的 `127.0.0.1` 当作宿主机地址。[Docker 端口发布说明](https://docs.docker.com/engine/network/port-publishing/) 建议使用受维护的 Docker 版本。Docker 官方特别说明,28.0.0 之前的版本存在同一二层网络设备可能访问回环发布端口的历史问题;不要只凭映射字符串就认定旧版本完全隔离。 ## 准备配置与数据目录 以下命令需要有创建 `/opt/webdav` 目录和执行 Docker 的权限。先确认工具可用: ```bash docker version docker compose version mkdir -p /opt/webdav/config /opt/webdav/data /opt/webdav/certs cd /opt/webdav ``` 创建 `/opt/webdav/config/config.yml`: ```yaml address: 0.0.0.0 port: 6065 tls: false directory: /data permissions: R behindProxy: false users: - username: demo password: "REPLACE_WITH_A_UNIQUE_PASSWORD" permissions: CRUD ``` 先把密码占位文字换成专用的长随机密码,再启动服务。配置文件里的 `R` 是默认只读,`demo` 用户单独获得创建、读取、更新、删除权限。不要删掉 `users` 后误以为仍然需要登录。 服务也支持 bcrypt 格式的密码和按用户设置目录;字段含义及密码生成方式可以对照 [hacdias/webdav 官方配置](https://github.com/hacdias/webdav#configuration)。使用哈希能减少明文密码落盘,但不能代替 HTTPS。 ```bash chmod 600 /opt/webdav/config/config.yml ``` 如果后续给容器指定了非 root 用户,需要同时调整文件的属主和权限,让该用户能读取配置、写入数据目录。不要用 `chmod -R 777` 来跳过权限问题。 ## 用 Docker Compose 启动 保存为 `/opt/webdav/compose.yml`: ```yaml services: webdav: image: ghcr.io/hacdias/webdav:latest restart: unless-stopped command: ["-c", "/config/config.yml"] ports: - "127.0.0.1:6065:6065" volumes: - ./config:/config:ro - ./data:/data logging: driver: json-file options: max-size: "10m" max-file: "3" ``` 这里用 `latest` 方便首次尝试。准备长期运行时,应先确认一个可用版本,再把镜像固定到该版本标签或摘要,避免以后拉取时悄悄更换版本。 ```bash cd /opt/webdav docker compose config --quiet docker compose pull docker compose up -d docker compose ps docker compose logs --tail=50 webdav ``` `config --quiet` 只检查 Compose 文件,不验证 WebDAV 的 YAML 是否正确。容器反复重启时,先看日志里的配置解析、文件读取和端口错误。 ## 用 curl 验证列目录、上传和下载 以下命令在 Docker 宿主机执行。`-u demo` 会让 curl 交互式询问密码;没有把密码直接放进命令行。[curl 参数说明](https://curl.se/docs/manpage.html) 先查看目录: ```bash curl -i -u demo -X PROPFIND \ -H "Depth: 1" \ http://127.0.0.1:6065/ ``` 正常情况下应看到 `207 Multi-Status` 和 XML。`-i` 用于显示响应头;只把正文管道给 `head`,不能据此确认 HTTP 状态码。207 代表多状态响应,操作是否全部成功还要看 XML 中各项状态。 再创建独立测试目录,避免碰到已有文件: ```bash probe="webdav-check-$(date +%Y%m%d%H%M%S)" curl -i -u demo -X MKCOL "http://127.0.0.1:6065/$probe/" printf 'hello webdav\n' > /tmp/webdav-probe.txt curl -i -u demo -T /tmp/webdav-probe.txt \ "http://127.0.0.1:6065/$probe/probe.txt" curl --fail --silent --show-error -u demo \ "http://127.0.0.1:6065/$probe/probe.txt" ``` 新建目录和新文件通常返回 201;覆盖已有文件可能返回 204。下载内容应为 `hello webdav`。也可以在宿主机的数据目录里确认文件是否实际写入。 文件能上传,不代表客户端的复制和重命名就一定正常。继续在同一终端里验证这两个操作: ```bash curl -i -u demo -X COPY \ -H "Destination: http://127.0.0.1:6065/$probe/copy.txt" \ -H "Overwrite: F" \ "http://127.0.0.1:6065/$probe/probe.txt" curl -i -u demo -X MOVE \ -H "Destination: http://127.0.0.1:6065/$probe/renamed.txt" \ -H "Overwrite: F" \ "http://127.0.0.1:6065/$probe/copy.txt" ``` `Destination` 与请求使用相同的地址和端口;`Overwrite: F` 避免覆盖已有目标。本方案直接连接服务,不需要套用反代场景中的请求头重写配置。 ## 让其他设备通过 HTTPS 连接 上面的端口只在服务器本机开放,手机连不上是预期行为。若要在公网使用,先准备指向服务器的域名,以及覆盖该域名、被客户端信任的证书。 将证书链和私钥分别放到: ```text /opt/webdav/certs/fullchain.pem /opt/webdav/certs/privkey.pem ``` 这一步假设你已经取得有效证书;容器不会因为填了域名就自动签发或续期。复制证书时注意来源是否为符号链接,最终应确保挂载目录内能直接读取完整文件。 在 `config/config.yml` 中把 TLS 设置改为: ```yaml tls: true cert: /certs/fullchain.pem key: /certs/privkey.pem ``` 其他配置保持不变,容器内端口仍然是 6065。然后把 Compose 的 `ports` 和 `volumes` 分别替换为以下内容,注意是替换,不要保留两个同名 YAML 键: ```yaml ports: - "443:6065" volumes: - ./config:/config:ro - ./data:/data - ./certs:/certs:ro ``` 先确认宿主机 443 没有被其他程序占用,配置好相应的入站访问规则,再应用修改: ```bash cd /opt/webdav docker compose config --quiet docker compose up -d --force-recreate docker compose logs --tail=50 webdav curl -i -u demo -X PROPFIND -H "Depth: 0" https://dav.example.com/ ``` TLS 由 WebDAV 服务自己处理。请用域名访问,直接换成 IP 可能导致证书名称校验失败;不要通过长期添加 `-k` 掩盖问题。若域名同时配置了 AAAA 记录,也要验证 IPv6 路径,避免部分设备连接到错误地址。 然后在另一台设备上,把前面的测试地址换成 `https://dav.example.com`,重新检查上传、下载、COPY 和 MOVE。服务端本机能连通,并不代表外部的 DNS、防火墙和证书都正确。 证书更新后执行 `docker compose restart webdav` 重新加载,并检查实际返回的证书。证书获取和续期属于独立维护事项。 ## 客户端连接时填什么 | 项目 | 示例 | | --- | --- | | 协议 | WebDAV / HTTPS | | 地址 | `https://dav.example.com/` | | 用户名 | `demo` 或你自己的账号 | | 密码 | 配置中对应账号的密码 | macOS 可以在 Finder 的“连接服务器”中输入 HTTPS 地址;移动端需要使用支持 WebDAV 的文件管理应用。Windows 的资源管理器连接依赖 WebClient 等组件和系统策略,不能把所有版本都当成相同行为。遇到问题时,先用 curl 区分服务故障和客户端兼容性。 备份任务可以使用 rclone。运行 `rclone config`,创建名为 `webdav` 的远端,类型选 WebDAV,填写 URL、用户名和密码,通用服务商选项使用 `other`。配置好以后先执行只读检查: ```bash rclone lsd webdav: rclone copy ./photos webdav:photos --dry-run ``` 确认目标无误后,再去掉 `--dry-run`。这里使用 `copy`,不使用会按源目录状态删除目标文件的 `sync`。客户端字段以 [rclone WebDAV 文档](https://rclone.org/webdav/) 为准。 ## 连接失败或不能写入,从哪里查 | 表现 | 先检查什么 | | --- | --- | | 容器启动后立刻退出 | YAML 缩进、配置挂载路径、证书读取权限 | | 本机连接被拒绝或重置 | 容器状态、日志、应用是否监听 `0.0.0.0:6065`、发布端口是否正确 | | 本机能访问,其他设备不能 | 是否仍绑定宿主机回环、DNS、端口放行、IPv4/IPv6 路径 | | 返回 401 | 用户名密码、客户端保存的旧凭据、是否读取了预期配置 | | 能读取但不能上传 | 账号 C/U 权限、宿主机目录写权限、磁盘剩余空间 | | COPY/MOVE 失败 | Destination 的主机和端口、目标父目录、账号权限、目标是否已存在 | | HTTPS 校验失败 | 域名与证书匹配、有效期、完整证书链、客户端时间 | 容器内只监听 `127.0.0.1` 时,监听的是容器自己的回环;普通 bridge 模式下,发布端口流量进入容器网卡,不会因此到达该监听地址。修改为 `0.0.0.0` 后,仍然要通过宿主机端口绑定决定开放范围。 改了 WebDAV 配置后执行 `docker compose restart webdav`;改了端口或挂载等 Compose 设置,则执行 `docker compose up -d` 重新应用。若仍有疑问,可通过 `docker inspect` 核对实际挂载和端口,而不是只看文件中的预期设置。 ## 更新容器之前,先确认数据在哪 上传目录通过 bind mount 保存到宿主机。删除并重建容器通常不会删除这份目录,但直接删除宿主机数据、错误覆盖文件或磁盘故障仍会造成损失。持久化不等于备份。[Docker bind mount 说明](https://docs.docker.com/engine/storage/bind-mounts/) 更新前记录当前镜像标签或摘要,并备份配置和数据;需要一致性备份时,暂停写入或停服务后再备份。确认新版本兼容后再执行: ```bash cd /opt/webdav docker compose pull docker compose up -d ``` 更新后重新跑一遍读写验证。只读账号可以设为 `R`;不授予删除权限能减少部分误操作,但有更新权限的账号仍可能覆盖文件,不能当作防勒索备份策略。 部署完成的标准很具体:客户端能验证证书、登录、列目录和读写文件;数据确实落在宿主机预期目录;重建容器后文件仍在。把这几项验证清楚,比只看到容器状态为 Running 更有用。 ## 参考资料 - [hacdias/webdav 项目与配置](https://github.com/hacdias/webdav) - [Docker 端口发布](https://docs.docker.com/engine/network/port-publishing/) - [Docker bind mounts](https://docs.docker.com/engine/storage/bind-mounts/) - [curl 参数说明](https://curl.se/docs/manpage.html) - [rclone WebDAV](https://rclone.org/webdav/) --- --- title: "从 Vibe Coding 到 Spec Coding:让 AI 写得快,也改得稳" source: https://www.iowill.com/blog/2026/09/from-vibe-coding-to-spec-coding/ date: 2026-09-30 updated: 2026-09-30 tags: [AI 编程, Spec Coding, Vibe Coding, 软件工程, 需求分析] categories: [编程开发] --- # 从 Vibe Coding 到 Spec Coding:让 AI 写得快,也改得稳 .png) “帮我把文章卡片改得好看一点。” AI 很快更新一版:圆角更大,封面比例统一,标题可以显示两行,页面背景也有了一层渐变。 但卡片太高,日期和分类挤到两行,侧栏为了和文章列表对齐被拉出了空白。于是回滚再补一句新要求。 这类过程很适合讨论 AI 编程中的一个变化:当生成代码变得越来越容易,我们需要更认真地管理“到底要改成什么”和“怎样证明已经改对”。 本文把 **Spec Coding** 用作“围绕明确规范进行 AI 辅助开发”的简称,对应通常所说的 **Spec-Driven Development,规范驱动开发**。它不是一个所有工具都严格统一使用的产品名称。 ## 1\. Vibe Coding 的吸引力:先把想法做出来 在本文的讨论范围内,Vibe Coding 指一种偏向对话和即时反馈的开发方式:描述想法,让 AI 生成实现,运行看看,再根据结果继续调整。这里讨论的是工作方式,不把所有使用 AI 写代码的行为都归入这个词。 它适合解决“我还不知道想要什么,但想先看到一个版本”的问题。 例如,准备做一个个人博客,你可能暂时无法回答卡片的精确尺寸、页面的信息密度或导航的交互细节。先做一个能打开的页面,比对着空白文档讨论两小时更容易形成判断。 这个阶段可以允许尝试,也可以接受推翻。原型的价值,是帮助人发现真实需求。 问题出在:原型不断叠加功能之后,开发方式却没有变化。 “加一个分类”“更新时间”“改一下侧栏”逐渐变成会影响多个页面、数据文件和维护脚本的操作。如果仍然只看当前页面是否顺眼,很容易漏掉别的地方。 ## 2\. 为什么越改越乱?要求散落在对话里 以静态博客为例,发布一篇文章不只是生成一个 HTML 文件。 首页卡片要增加,超过页容量的文章要后移;归档要登记,搜索索引要补条目;分类和标签要同步,侧栏统计和最新文章也要更新。 这些要求如果只存在于聊天记录中,会出现三个问题。 **第一,最新要求与旧要求混在一起。** 上一轮说“侧栏底部和文章对齐”,下一轮又说“取消对齐,恢复原布局”。如果旧约定仍然留在文档里,后续维护可能把已经撤销的方案重新做回来。 **第二,视觉结果掩盖了数据问题。** 首页能够正常打开,不代表搜索能找到新文章;卡片看起来正常,也不代表网站文章数已经从 43 更新成 44。 **第三,实现和完成标准由同一个模糊描述决定。** 如果要求只是“优化一下”,AI 可以通过自己选定的标准宣告完成。代码可能符合它的理解,却没有符合你的预期。 把这些问题全部归结为“提示词不够长”,并不准确。真正需要补充的是:可定位的需求、明确的范围,以及能独立检查的完成条件。 ## 3\. Spec Coding 把哪些事情提前了?  *两种工作方式可以衔接:先探索需求,再明确规范和验收条件。* 一份有用的 Spec,至少能回答四个问题: 1. 谁在什么场景下遇到了什么问题? 2. 本次需要出现什么行为? 3. 哪些限制必须满足,哪些内容不在本次范围内? 4. 用什么证据判断已经完成? GitHub 的 Spec Kit 将需求描述、澄清、技术计划、任务拆解和实现验证组织成显式流程;其文档也强调在需求阶段先说明要做什么及原因,再处理技术方案。[GitHub Spec Kit 官方指南](https://github.github.com/spec-kit/quickstart.html) “目标是什么”与“准备怎样实现”应分开记录。以下文件划分是本文建议的轻量实践,不要求安装特定工具。 | 材料 | 回答的问题 | 博客示例 | | --- | --- | --- | | Spec | 最终应该有什么行为? | 每页最多 18 篇,发布后文章无重复遗漏 | | Plan | 如何实现? | 按时间排序,依次生成分页并更新链接 | | Tasks | 分成哪些可执行步骤? | 登记文章、更新分页、同步搜索、校验 | | Evidence | 实际做成了什么? | 数量检查、链接检查、浏览器截图和部署结果 | 这里最容易忽略的是最后一项。任务清单打满勾,不代表测试真的运行过;测试通过,也不代表页面已经在线上部署成功。 ## 4\. 把“卡片排紧一点”写成一份小 Spec 不必一开始就建立复杂流程。一个具体的小功能,可以从这样的说明开始: ```markdown # 文章卡片时间与分类单行显示 ## 问题 首页部分卡片的日期和分类换行,导致信息区不整齐。 ## 范围 首页及其分页的文章卡片。 不调整文章正文中的发布时间,不改变每页文章数量。 ## 预期行为 - 日期格式为 YYYY/MM/DD HH:mm:ss,使用北京时间。 - 日期与分类在同一行。 - 完整时间不截断,分类仍然可以点击。 - 空间确实不足时,分类名称允许省略号截断。 - 卡片只出现一个分类图标。 ## 约束 - 保留现有主题、配色和圆角。 - 不通过横向溢出页面来强行放下一行。 - 不修改原始 datetime,不编造时间。 ## 验收 - 在 360px、768px、1024px、1440px 宽度检查布局。 - 覆盖最长分类名和完整时间组合。 - 浅色、深色模式均可读,分类链接可访问。 - 首页分页链接和文章总数与修改前一致。 ``` 这份 Spec 没有规定必须使用 Flex 还是 Grid,也没有提前指定每一处 CSS。它给实现留出空间,同时结果写清楚。 上面的视口宽度是示例验收范围,不是宣称这些页面已经完成了对应测试。需要亲自记录实际验证情况。 如果这些条件无法同时满足,应当暴露冲突。例如,为了完整显示最长分类,字号是否会小到难以阅读?这时需要调整规则,而不是把文字缩得越来越小后宣告成功。 ## 5\. 再进一步:把发布文章变成可验证流程 视觉调整可以用轻量 Spec。涉及多个数据源的发布操作,更适合补上明确的不变量。 静态博客示例假设每页 18 篇,发布前共有 43 篇。 ```markdown # 发布新文章 ## 输入 - 已审核的正文、标题、摘要和封面 - 唯一 slug - 含时区的发布时间 - 一个分类及若干标签 ## 完成条件 - 文章页面、分类登记、搜索索引均包含新文章。 - 发布后总数为 44:首页分页分布为 18/18/8。 - 各分页按发布时间倒序,无重复、无遗漏。 - 总归档及对应年月归档包含新文章。 - 作者卡与网站资讯显示相同的文章总数。 - 最新文章按发布时间选取最近 5 篇。 - sitemap 包含新文章的规范 URL。 - 原有文章正文没有意外改动。 ## 异常处理 - slug 重复:停止写入,报告冲突。 - 搜索条目缺失或重复:校验失败,不标记为发布完成。 - 部署未完成:报告已推送、待部署,不宣称已经上线。 ``` 这个例子里的 44 和 18/18/8 是针对一次发布的具体预期。长期维护的检查应尽量从真实文章集合推导总数,再独立验证分页中实际出现的链接;不要每次靠手动修改一串散落的常量。 同时,测试不能只比较两个都由同一个错误变量生成的数字。否则源数据少了一篇,两边仍然可能相等。可以交叉检查文章文件、登记表、搜索索引和分页链接集合,并明确哪个集合应当包含哪些文章。 ## 6\. 一个适合个人项目的工作循环  *SPEC:规范;PLAN:计划;BUILD:实现;VERIFY:验证;REFINE:反馈修订。* 我更倾向于把流程控制在六步,而不是要求每次改颜色都写一套长文档。 ### 先调查现状 让 AI 阅读相关代码、文档和已有检查,确认当前行为与问题位置。已有项目尤其要注意:仓库里有没有源工程?哪些文件是生成结果?哪个脚本会覆盖当前修改? 不了解这些边界,写出来的 Spec 可能建立在错误前提上。 ### 写下本次目标和验收 复杂功能可以单独建立 `spec.md`;小修改在任务说明中写几条就够了。区分已经确定的要求、暂定假设与尚未回答的问题。 ### 选择最小可行方案 检查主题原有能力和现有脚本,再决定是否增加代码。方案应说明主要改动点和影响范围,避免为了一个小效果引入新的框架。 ### 按小块实现 优先完成一条能验证的路径,再扩展到全站。批量 HTML 修改尤其要先确认替换边界,不能因为一个正则在单页有效,就认定所有页面都安全。 ### 按验收条件收集证据 数据问题用数量、集合和链接检查;视觉问题用实际浏览器;部署问题看部署结果和线上页面。没有运行的检查要明确标记,不能用“应该没问题”替代证据。 ### 同步最终规范 实现过程中发现更合适的规则,应当更新 Spec。已经取消的方案移到变更记录中,现行规范只保留当前有效要求。 在博客项目里,`docs` 可以保存长期约定,功能 Spec 保存一次改动的边界,变更记录解释为什么变更。三者职责不同,避免把所有历史对话原样堆在同一个文件里。 ## 7\. Spec 也会出问题 规范不会自动让 AI 变得可靠。写得不好,它只是把模糊需求换成了更正式的排版。 常见问题包括: - **不可验证:** “更高级”“性能更好”“体验更流畅”,没有场景和可判断的结果。 - **过早限定实现:** 还没确认问题,就要求换框架、重写模块或引入新服务。 - **只覆盖正常路径:** 没考虑空数据、重复输入、错误时间、失败部署和既有数据兼容。 - **规范与代码脱节:** 功能已经变了,文档还保留旧行为。 - **测试复述实现:** AI 按错误理解写代码,再按同样的理解写测试,两者一致但都不符合真实需求。 应对方式不是继续增加文档长度,而是使用具体案例、边界输入和独立审查。对于权限、数据迁移或外部副作用,尤其需要核对失败时会发生什么,以及如何恢复。 ## 8\. 什么时候用哪一种方式? | 场景 | 建议做法 | | --- | --- | | 探索一个尚未成形的想法 | 快速原型,尽早看结果,允许推翻 | | 改一处文案或局部样式 | 几条目标与验收即可,不必写完整方案文档 | | 改动多个页面或数据文件 | 轻量 Spec、影响范围与自动检查一起做 | | 长期维护、多人协作的功能 | 持续维护规范、接口约定及回归证据 | | 涉及权限、数据迁移或重要业务 | 明确失败行为、审查责任与恢复方案 | 探索与规范可以连续发生。先用原型发现需求,再把已经确认的行为固定下来,后续实现围绕这些行为展开。 也不必把 Spec Coding 等同于某一个工具。GitHub Spec Kit 和 Kiro 都提供了围绕规范组织 AI 开发的能力,但个人项目可以先从仓库中的 Markdown 和现有测试开始。工具值得关注的地方,是它能否帮助需求、任务与实现保持一致。[Kiro Specs 官方文档](https://kiro.dev/docs/specs/) ## 9\. 可以直接使用的任务提示词 ```text 请先阅读相关代码和项目约定,概括当前行为及本次问题。 基于以下目标整理一份轻量 Spec,包含: 用户场景、范围、非目标、约束、异常情况和验收条件。 已有明确答案的事项直接使用;只列出会影响实现的未知问题。 然后提出最小可行实施方案,指出需要同步的数据和文件。 实现过程中如果需求与现状冲突,说明冲突并更新方案。 完成后逐项给出验证结果: 哪些检查实际运行、结果如何、哪些尚未验证。 最后同步现行规范,避免保留已经撤销的要求。 ``` 这段提示词只是起点。真正有价值的部分,是你为当前任务填入的场景、边界和判断标准。 AI 可以很快写出一个看起来可用的版本。让它在几周之后仍然容易修改、能够验证、不会反复踩同一个坑,需要把需求和证据也放进开发过程里。 从 Vibe Coding 到 Spec Coding,值得保留的是探索的速度,值得补上的,是对“完成”更清楚的定义。 ## 参考资料 - [GitHub Spec Kit](https://github.com/github/spec-kit):开源规范驱动开发工具包。 - [Spec Kit 官方快速开始](https://github.github.com/spec-kit/quickstart.html):需求、计划、任务与验证流程。 - [Kiro Specs 官方文档](https://kiro.dev/docs/specs/):围绕规范组织开发的工具实践。 本文中的博客 Spec、验收样例和工作流程建议为结合静态博客维护场景整理的示例,并非上述工具的默认配置。工具命令与支持能力可能变化,实际使用以官方文档为准。 --- --- title: "Debian多网卡Docker-MySQL回程路由排查" source: https://www.iowill.com/blog/2026/09/debian-docker-mysql-multi-nic-routing/ date: 2026-09-29 updated: 2026-10-09 tags: [Debian, Docker, MySQL, 容器网络, 故障排查, 策略路由] categories: [系统与运维] --- # Debian多网卡Docker-MySQL回程路由排查 在一台 Debian 服务器上配置了多块网卡,每块网卡都有独立公网 IP。MySQL 通过 Docker 部署,发布端口为 `3306`。 实际使用时发现: - 使用 eth0 的公网 IP,可以连接 MySQL。 - 使用其他网卡的公网 IP,连接超时。 - 已经配置了基于公网源 IP 的策略路由,但问题依然存在。 最终通过抓包确认:**请求从 eth1 进入,经过 Docker 转发到 MySQL;MySQL 的回复却从 eth0 发出。** 本文记录排查过程和经过验证的修复方法。文中所有 IP 地址均为文档保留地址(RFC 5737),仅作示意:203.0.113.10 是 eth0 公网地址,198.51.100.20 是 eth1 公网地址,203.0.113.1 / 198.51.100.1 是两块网卡的网关,172.20.0.2 是 MySQL 容器地址,0.0.0.0 表示监听所有本机 IPv4 地址。命令和输出均为示意,请替换为你自己的实际配置后再执行。 ## 一、环境与现象 以 eth0、eth1 为例: | 对象 | 地址或配置 | | --- | --- | | eth0 | `203.0.113.10/24` | | eth0 网关 | `203.0.113.1` | | eth1 | `198.51.100.20/24` | | eth1 网关 | `198.51.100.1` | | Docker 网桥 | `br-cb0d8db03272` | | MySQL 容器 IP | `172.20.0.2` | | Docker 端口映射 | `0.0.0.0:3306->3306/tcp` | 主路由表默认出口为 eth0: ```text default via 203.0.113.1 dev eth0 ``` 同时,服务器已经配置了 eth1 的源地址策略路由: ```text from 198.51.100.20 lookup 199 ``` 路由表 `199` 内容为: ```text default via 198.51.100.1 dev eth1 ``` 在 Windows 客户端测试 eth1 的 MySQL 端口: ```powershell Test-NetConnection 198.51.100.20 -Port 3306 ``` 结果为: ```text TcpTestSucceeded : False ``` ## 二、先排除监听地址和反向路径过滤 查看容器端口映射: ```bash docker ps --format 'table {{.Names}}\t{{.Ports}}' ``` MySQL 显示: ```text 0.0.0.0:3306->3306/tcp ``` 查看宿主机监听: ```bash ss -lntp ``` 对应输出: ```text LISTEN 0 4096 0.0.0.0:3306 0.0.0.0:* users:(("docker-proxy",...)) ``` 这说明宿主机的 3306 发布在所有 IPv4 地址上,并没有只绑定 eth0。不过,监听所有地址不代表端到端网络一定可达。[Docker 端口发布文档](https://docs.docker.com/engine/network/port-publishing/) 接着查看反向路径过滤: ```bash sysctl net.ipv4.conf.all.rp_filter \ net.ipv4.conf.eth0.rp_filter \ net.ipv4.conf.eth1.rp_filter ``` 本次环境输出均为 `0`。 因此,可以排除 eth0、eth1 上的 `rp_filter` 检查导致丢包。其他环境如果使用严格模式 `1`,多网卡的非对称路由可能触发丢包,需要单独核查。[Linux 内核文档](https://www.kernel.org/doc/html/next/networking/ip-sysctl.html) ## 三、抓包发现:eth1 进,eth0 出  故障路径:eth1 进入,eth0 返回 在服务器执行: ```bash tcpdump -ni any -nn \ 'tcp port 3306 and not (src net 172.20.0.0/16 and dst net 172.20.0.0/16)' ``` 这里过滤掉了 Docker 子网内部的通信,避免把其他容器访问 MySQL 的正常流量误当成外部测试流量。 随后,在外部 Windows 客户端重新测试: ```powershell Test-NetConnection 198.51.100.20 -Port 3306 ``` 抓包得到的关键过程如下: ```text eth1 In: 客户端 → 198.51.100.20:3306 SYN Docker 网桥 Out: 客户端 → 172.20.0.2:3306 SYN Docker 网桥 In: 172.20.0.2:3306 → 客户端 SYN-ACK eth0 Out: 198.51.100.20:3306 → 客户端 SYN-ACK ``` 这段输出证明了三件事: 1. 外部请求已经到达 eth1。 2. Docker 已将请求转发给 MySQL,MySQL 也发出了回复。 3. 回复使用 eth1 的公网源地址,却从 eth0 发出。 之后可以看到重复的 SYN 和 SYN-ACK,但没有完成握手。 **回程出口错误已经确定。** 至于回复具体在哪里被丢弃,仅靠服务器侧抓包无法确定;上游网络可能对源地址与出口的对应关系有限制。 ## 四、为什么已有源 IP 策略路由仍然无效? 已有规则匹配的是公网源地址: ```text from 198.51.100.20 lookup 199 ``` 但 Docker 容器回复经过宿主机转发时,在选择路由的阶段,源地址仍然是: ```text 172.20.0.2 ``` 它无法匹配上面的公网源地址规则,于是使用主路由表,从 eth0 出口发送。 之后,连接跟踪对应的反向 NAT 才将源地址恢复成: ```text 198.51.100.20 ``` 因此,在物理网卡上抓到的最终数据包表现为: ```text eth0 Out,源地址却是 eth1 的公网 IP ``` 这也解释了为什么 eth0 能连接:主路由表的默认出口恰好就是 eth0,而其他网卡需要正确的回程选路。 ## 五、修复:识别连接的回包,再按标记选路  修复原理:识别回包,按标记选路 本次采用的办法是: 1. 利用连接跟踪,识别原本访问 `198.51.100.20:3306` 的连接。 2. 只给该连接的回复方向数据包添加标记。 3. 根据标记,使用已有的路由表 `199`,从 eth1 发出。 `--ctorigdst` 和 `--ctorigdstport` 匹配连接的原始目的地址及端口;`--ctdir REPLY` 限定回复方向。这样即使当前数据包的源地址还是容器 IP,也能识别它属于哪个公网入口的连接。[iptables 扩展手册](https://man7.org/linux/man-pages/man8/iptables-extensions.8.html) 以下命令中的 IP、网桥名、路由表编号需要替换为实际配置;规则优先级和标记也应避免与已有用途冲突。以下添加命令执行一次即可,重复执行会累积规则。 先添加按标记选路的规则: ```bash ip rule add priority 10199 \ fwmark 0x199/0xffffffff lookup 199 ``` 再对指定连接的回包打标: ```bash iptables -t mangle -I PREROUTING 1 \ -i br-cb0d8db03272 \ -p tcp \ -m conntrack --ctdir REPLY \ --ctorigdst 198.51.100.20 \ --ctorigdstport 3306 \ -j MARK --set-xmark 0x199/0xffffffff ``` 这里的 `0x199` 是自定义的数据包标记,不是路由表编号的自动转换;是 `ip rule` 将该标记关联到了路由表 `199`。[ip rule 手册](https://man7.org/linux/man-pages/man8/ip-rule.8.html) 规则只匹配回复方向,进入容器的原始请求不会被这条规则标记。 ## 六、验证结果 客户端再次执行: ```powershell Test-NetConnection 198.51.100.20 -Port 3306 ``` 结果变为: ```text TcpTestSucceeded : True ``` **实际验证表明,新增规则后 eth1 的 MySQL 端口恢复了 TCP 连通。** 这也支持了此前关于 Docker 回程路由的判断。 如果需要进一步确认,可以重新抓包,检查 SYN-ACK 是否从 eth1 发出,并查看规则命中计数: ```bash iptables -t mangle -nvL PREROUTING --line-numbers ``` 最后再用 MySQL 客户端登录。TCP 连通和数据库认证是两个阶段;如果此时出现 `Access denied`,应继续检查 MySQL 用户授权和认证配置。 ## 七、回滚与持久化说明 撤销本次规则: ```bash iptables -t mangle -D PREROUTING \ -i br-cb0d8db03272 \ -p tcp \ -m conntrack --ctdir REPLY \ --ctorigdst 198.51.100.20 \ --ctorigdstport 3306 \ -j MARK --set-xmark 0x199/0xffffffff ip rule del priority 10199 \ fwmark 0x199/0xffffffff lookup 199 ``` 本次验证的是 **eth1 的 MySQL 3306 端口临时修复**,尚未验证其他网卡,也没有完成重启持久化。 扩展到其他公网 IP 时,需要为各入口配置对应的连接匹配、标记和路由表。持久化时则要同时恢复策略路由和防火墙规则,并确保执行顺序正确、重复执行不会累积规则。另外,Docker 网络重建后网桥名称可能变化,本文规则中的网桥名也需要同步检查。 这次排查最关键的证据,是抓包中的这一行:**eth1 的公网源地址出现在了 `eth0 Out` 上。** 端口确实开放、数据库也确实回复了,但回复没有沿着正确的出口返回。 --- --- title: "TigerVNC 锁屏问题解决方案" source: https://www.iowill.com/blog/2026/09/tigervnc-lock-screen-fix/ date: 2026-09-10 updated: 2026-10-14 tags: [Linux, TigerVNC, VNC, 故障排查, 远程桌面] categories: [系统与运维] --- # TigerVNC 锁屏问题解决方案 ## 问题诊断 - **根本原因**:Linux `logind` 服务将会话标记为”locked”(常见于休眠/锁屏后) - **典型表现**: - VNC 连接后黑屏 - 认证失败提示 - **直接解决方案**: ```bash loginctl unlock-sessions # 解锁所有会话 ``` * * * \[TOC\] * * * ## 永久性解决方案 ### 方案A:禁用自动锁屏(推荐用于服务器) ```bash gsettings set org.gnome.desktop.screensaver lock-enabled false gsettings set org.gnome.desktop.session idle-delay 0 ``` ### 方案B:配置自动解锁(需要polkit规则) 创建规则文件: ```bash sudo nano /etc/polkit-1/rules.d/85-unlock-vnc.rules ``` 添加内容: ```javascript polkit.addRule(function(action, subject) { if (action.id == "org.freedesktop.login1.unlock" && subject.isInGroup("vncusers")) { return polkit.Result.YES; } }); ``` ### 方案C:系统级会话保持 ```bash sudo nano /etc/systemd/logind.conf ``` 修改关键参数: ```ini IdleAction=ignore HandleLidSwitch=ignore ``` ## 系统状态验证 检查会话状态 ```bash loginctl list-sessions ``` 预期输出示例: ```plaintext SESSION UID USER SEAT TTY STATE 1 1000 user1 seat0 tty2 active # 确保状态非locked ``` 实时监控命令 ```bash journalctl -f -u systemd-logind | grep -E 'SessionLock|SessionUnlock' ``` ## VNC服务优化配置 修改xstartup脚本 ```bash nano ~/.vnc/xstartup ``` 添加以下内容: ```bash #!/bin/bash # 禁用GNOME自动锁屏 gsettings set org.gnome.desktop.screensaver lock-enabled false exec gnome-session ``` **关键命令速查表** | 场景 | 命令 | | :-- | :-: | | 解锁指定会话 | loginctl unlock-session | | 解锁所有会话 | loginctl unlock-sessions | | 查看锁定状态 | loginctl show-session | | 禁用休眠功能 | systemctl mask sleep.target suspend.target | 检查最近锁屏记录: ```bash journalctl -u systemd-logind --since "1 hour ago" ``` --- --- title: "Ubuntu GNOME 桌面安装和配置 TigerVNC,包含服务设置、桌面环境适配和防火墙配置" source: https://www.iowill.com/blog/2026/09/ubuntu-gnome-tigervnc-setup/ date: 2026-09-10 updated: 2026-10-14 tags: [GNOME, TigerVNC, Ubuntu, VNC, 远程桌面] categories: [系统与运维] --- # Ubuntu GNOME 桌面安装和配置 TigerVNC,包含服务设置、桌面环境适配和防火墙配置 ## 一、安装 TigerVNC ```bash sudo apt update sudo apt install tigervnc-standalone-server tigervnc-common -y ``` ## 二、首次配置 ### 1\. 设置 VNC 密码(长度需 ≥6 位) ```bash vncpasswd ``` 密码文件会保存在 ~/.vnc/passwd。 ### 2\. 创建 xstartup 配置文件(适配不同桌面环境) ```bash mkdir -p ~/.vnc nano ~/.vnc/xstartup ``` 根据桌面环境选择配置: #### ***GNOME 桌面:*** ```bash #!/bin/bash export GNOME_SHELL_SESSION_MODE=ubuntu export XDG_CURRENT_DESKTOP=ubuntu:GNOME export XDG_CONFIG_DIRS=/etc/xdg/xdg-ubuntu:/etc/xdg dbus-launch --exit-with-session /usr/bin/gnome-session --session=ubuntu ``` #### ***XFCE 桌面(轻量级推荐):*** ```bash #!/bin/bash xrdb $HOME/.Xresources startxfce4 & ``` #### ***KDE Plasma 桌面:*** ```bash #!/bin/bash startplasma-x11 & ``` ### 3.赋予执行权限: ```bash chmod +x ~/.vnc/xstartup ``` ## 三、启动 VNC 服务 ### 临时启动(端口 5901): ```bash vncserver :1 -geometry 1920x1080 -depth 24 -localhost no ``` - \-localhost no:允许外部连接 - :1 对应端口 5901(:2 → 5902,依此类推) ### 查看运行中的实例: ```bash vncserver -list ``` ## 四、设置系统服务(开机自启) ### 1\. 创建 systemd 服务文件 ```bash sudo nano /etc/systemd/system/vncserver@.service ``` ***粘贴以下内容(注意替换 USER):*** ```ini [Unit] Description=Remote desktop service (VNC) After=syslog.target network.target [Service] Type=simple User=root # 改为实际用户名 ExecStart=/usr/bin/vncserver :%i -geometry 1920x1080 -depth 24 -localhost no ExecStop=/usr/bin/vncserver -kill :%i Restart=on-failure [Install] WantedBy=multi-user.target ``` ### 2\. 启用并启动服务 ```bash sudo systemctl daemon-reload sudo systemctl enable vncserver@1 # 对应 :1 实例 sudo systemctl start vncserver@1 ``` ### 3\. 检查状态 ```bash sudo systemctl status vncserver@1 ``` ## 五、防火墙放行 ```bash sudo ufw allow 5901/tcp sudo ufw reload ``` ## 六、客户端连接 > 地址:<服务器IP>:5901 > 或者ssh客户端内部连接:localhost:5901 ***客户端工具:*** Windows: [TigerVNC Viewer](https://sourceforge.net/projects/tigervnc/files/latest/download) Linux/macOS: ```bash vncviewer 服务器IP:5901 ``` ## 七、常见问题解决 ### 1\. 连接后黑屏 - 确保桌面环境已安装: ```bash sudo apt install ubuntu-desktop # GNOME 或 sudo apt install xfce4 # XFCE ``` - 检查日志: ```bash cat ~/.vnc/ubuntu:1.log ``` ### 2\. 修改分辨率 停止服务后重新启动: ```bash vncserver -kill :1 vncserver :1 -geometry 1280x720 -depth 24 ``` ### 3\. 卸载 TigerVNC ```bash sudo apt remove --purge tigervnc-* rm -rf ~/.vnc ``` ### 附:安全建议 #### 使用 SSH 隧道加密: ```bash ssh -L 5901:localhost:5901 用户名@服务器IP ``` 然后连接 localhost:5901。 #### 限制访问 IP: ```bash sudo ufw allow from 192.168.1.100 to any port 5901 ``` 按照以上步骤,你可以在 Ubuntu 上快速搭建一个支持多用户的 TigerVNC 远程桌面服务。 --- --- title: "linuxQQ安装后双击启动无响应,提示追踪与中断点陷阱 (核心已转储)" source: https://www.iowill.com/blog/2026/09/linuxqq-wont-start-core-dump/ date: 2026-09-10 updated: 2026-10-14 tags: [Electron, Linux, QQ, 故障排查] categories: [软件与工具] --- # linuxQQ安装后双击启动无响应,提示追踪与中断点陷阱 (核心已转储) 终端报错内容: > root@ubuntu:~/Desktop# qq > \[0415/140821.298504:FATAL:electron\_main\_delegate.cc(295)\] Running as root without –no-sandbox is not supported. See [https://crbug.com/638180](https://crbug.com/638180). > 追踪与中断点陷阱 (核心已转储) 这个错误表明你以 root 用户 运行 QQ(Linux 版),但 Electron 框架(QQ 使用的底层技术)出于安全考虑,默认禁止 root 用户直接运行。 * * * \[TOC\] ## 解决方案: ### 1\. 解决方案一:使用 –no-sandbox 参数 ```bash # 添加参数运行 QQ qq --no-sandbox ``` 注意:这会降低安全性,仅建议临时使用。 ### 2\. 解决方案二:创建普通用户运行(推荐) ```bash # 创建新用户 sudo adduser qquser # 切换到新用户 sudo -i -u qquser # 在新用户环境下运行 QQ qq ``` ### 3\. 解决方案三:修改 QQ 启动器 #### 1\. 定位QQ桌面快捷方式 ```bash # 查找QQ桌面文件位置 sudo find / -name "*qq*.desktop" 2>/dev/null ``` 通常路径为: /usr/share/applications/qq.desktop /opt/QQ/qq.desktop #### 2\. 修改启动器文件 以/usr/share/applications/qq.desktop为例 ```bash sudo nano /usr/share/applications/qq.desktop ``` #### 3\. 修改Exec行 添加–no-sandbox ```ini [Desktop Entry] ... Exec=qq --no-sandbox %U # 关键修改 ... ``` #### 4\. 更新桌面数据库 ```bash sudo update-desktop-database ``` #### 5\. 创建安全封装脚本(推荐) ```bash sudo nano /usr/local/bin/qq-safe ``` **内容:** ```bash #!/bin/bash # 限制仅允许普通用户运行 if [ "$(id -u)" -eq 0 ]; then echo "Error: QQ should not run as root!" exit 1 fi exec qq --no-sandbox "$@" ``` **赋予权限:** ```bash sudo chmod +x /usr/local/bin/qq-safe ``` #### 6\. 修改启动器指向新脚本 ```bash sudo nano /usr/share/applications/qq.desktop ``` **修改为:** ```ini Exec=/usr/local/bin/qq-safe %U ``` #### 验证步骤 通过应用菜单启动QQ 检查进程权限: ```bash ps aux | grep -i qq | grep -v grep ``` 应显示: > youruser 1234 0.5 2.1 … qq –no-sandbox #### 备选方案(若仍崩溃) ##### A. 使用–disable-gpu-sandbox双重参数 ```bash sudo sed -i 's|Exec=.*|Exec=qq --no-sandbox --disable-gpu-sandbox %U|g' /usr/share/applications/qq.desktop ``` ##### B. 设置Chromium标志 ```bash mkdir -p ~/.config/QQ echo '--no-sandbox' > ~/.config/QQ/electron-flags.conf ``` #### 安全警告 > 长期使用–no-sandbox会降低安全性 > 建议最终采用 普通用户方案: ### 4\. 解决方案四:使用 Deepin-Wine 版 QQ ```bash # 安装 Deepin-Wine 环境 wget -O- https://deepin-wine.i-m.dev/setup.sh | sh # 安装 QQ sudo apt install com.qq.im.deepin # 运行(无需 root) deepin-wine6-stable ~/.deepinwine/Deepin-QQ/drive_c/Program\ Files/Tencent/QQ/Bin/QQ.exe ``` * * * ## 错误原因说明 - 安全沙箱(Sandbox):Electron 应用默认启用沙箱隔离,root 用户会触发保护机制 - 核心转储:因权限问题导致进程崩溃 ### 永久修复建议 避免以 root 运行图形应用 如果必须用 root,可配置系统策略: ```bash sudo sysctl kernel.unprivileged_userns_clone=1 ``` 验证是否修复 ```bash # 检查 QQ 进程 ps aux | grep -i qq | grep -v grep # 应显示普通用户权限 ``` --- --- title: "GEO 是什么?它真的能让大模型‘愿意推荐你’吗?" source: https://www.iowill.com/blog/2026/08/what-is-geo/ date: 2026-08-12 updated: 2026-10-08 tags: [AI搜索, GEO, SEO, 信息检索] categories: [软件与工具] --- # GEO 是什么?它真的能让大模型‘愿意推荐你’吗? > 迁移说明:本文原发表于 [Billy 原站](https://billy12.xyz/archives/what-is-GEO),保留原发布时间,2026 年 10 月 8 日迁入本站并重新配图。迁移时保留主体结构,对效果保证、评价指标和平台机制的绝对化表述补充校注。文中历史研究或平台报告的数值受样本、版本与指标定义限制,不代表本站实测,也不构成收录、推荐或转化保证。 * * * * * * ## 一句话剧透 > **SEO 与 GEO 的侧重点不同:前者关注搜索可见性与访问,后者更关注内容是否进入生成式答案。两者存在交集,GEO 并不意味着可以跳过 SEO 基础工作。** * * * ## 一、为什么 SEO 不够用了 **一句话定义**:当用户在 Google 看到 AI Summary 而不再点击链接时,传统 SEO 的优化目标就从"前十名"坍缩成了"AI 答案里有没有我"。 **五个事实点**: 1. chat.openai.com 单月 31 亿次访问(Similarweb,2024-09)。 2. Perplexity 月查询量 7.8 亿(公司自报,2025-05)。 3. Google 出现 AI Summary 时,点击率从 15% 跌到 8%(Pew 实地研究)。 4. AI 答案可能改变用户是否继续点击网页的行为;原文此处百分比未明确对应统计口径,迁移版不保留该数值。 5. 关于未来流量超过传统搜索的判断属于预测,不应作为已经发生的事实或确定的业务规划依据。 **对比块:SEO vs GEO** | 维度 | SEO | GEO | | --- | --- | --- | | 优化目标 | 在 SERP 排第几 | 是否被 AI 选进答案 | | 用户行为 | 点 10 个蓝链之一 | 只看 AI 推荐的 3 个 | | 排名机制 | 关键词 + 链接权重 | 预训练先验 + 检索片段合成 | | 评估指标 | 排名 / CTR | 引用词数 / 位置 / 主观印象 | | 失败模式 | 排不到首页 | 完全不被引用 |  概念示意:结果列表可见性与答案引用可见性存在差异,图示不代表固定的来源数量。 ## 二、GEO 到底在优化什么? **可见性评价**:相关研究分别考察引用词数、位置加权词数和主观印象等指标。它们不是所有生成式引擎共同使用的一条排名公式,具体定义应以论文为准。 **三个 visibility 指标**: 1. **Word Count**——AI 答案里有多少词在引用你。 2. **Position-Adjusted Word Count**——被引用词数 × `e^(-位置)`,靠前的引用权重大。 3. **Subjective Impression**——用 G-Eval(LLM-as-judge)从相关性、影响力、独特性等 7 个子维度打分。 **九种 GEO 方法**(同样来自 Aggarwal et al., 2024):Authoritative、Statistics Addition、Cite Sources、Quotation Addition、Easy-to-Understand、Fluency Optimization、Unique Words、Technical Terms、Keyword Stuffing。 **对比块:在 GEO-bench(10K queries)上的效果** 研究记录:下表沿用原文整理的实验数据,本次迁移未重新复现实验;不同指标、样本与模型之间不可直接套用。 | 方法 | visibility 提升 | 实测备注 | | --- | --- | --- | | Cite Sources + Quotation Addition + Statistics | **+40%** | 论文中最强组合 | | 仅 Statistics Addition | +30% | 性价比最高 | | Keyword Stuffing(传统 SEO 老套路) | < +10% | LLM 不吃这套 | | 整体最高 | 40%(synthetic)/ 37%(Perplexity.ai 真实环境) | — | * * *  概念示意:既有知识与检索信息可能共同影响答案;图中不表示测得的权重比例。 ## 三、检索信息与模型既有知识:为什么不同查询的表现不同 **一句话定义**:在主流 entity 查询上,模型用检索内容只是"给自己找个证据",而不是"获取新知识"。 **三个扰动实验**(Chen et al., EDBT/ICDT 2026): 1. **Snippet Shuffle**——随机打乱检索片段顺序,看答案会不会变。 2. **Strict Grounding**——强制模型只用提供的片段,禁止用预训练知识。 3. **Entity-Swap Injection**——把片段里 A、B 两个实体的名字对调,看模型会不会上当。 **对比块:主流 vs 小众 entity 的模型行为** 研究记录:下表沿用原文整理的实验数据,本次迁移未重新复现实验;不同指标、样本与模型之间不可直接套用。 | 指标 | 主流 entity("最好的 SUV") | 小众 entity("多伦多家事律所") | | --- | --- | --- | | 检索片段顺序打乱后排名变化 | 2.30 | 4.15 | | 实体名互换后排名变化 | 2.60 | 4.63 | | 一次性排序 vs 两两比较排序的 Kendall τ | 0.911 | 0.556 | | 模型答出但**根本没出现在检索片段中**的 entity 占比 | **16%** | — | **五个品牌的具体"幽灵率"**(SUV 查询): - Toyota:**6%**——几乎每个引用都有检索片段支撑。 - Honda:**3%**——同上。 - Kia:**10%**——基本可靠。 - Cadillac:**58%**——模型自顾自答。 - Infiniti:**73%**——纯靠预训练先验。 > **阅读结论**:部分查询可能更受模型既有知识影响,但不能由局部实验推出“主流实体做 GEO 都无效”。应按查询类型、模型和实际结果判断。 * * * ## 四、GEO 真正能赢的四种场景 **步骤块:判断 GEO 对你是否有用的四问** 1. **你的实体够小众吗?**——B2B SaaS、本地服务、长尾知识、专业工具。模型脑子里没货,必须检索。\[必做\] 做 GEO。 2. **你的内容够新鲜吗?**——AI 引擎对 freshness 的权重显著高于 Google。消费电子垂直:AI 引擎引用内容平均 62-90 天 vs Google 130 天;汽车垂直:AI 148-217 天 vs Google **493 天**。\[必做\] 做 GEO。 3. **你的内容是争议性/对比性的吗?**——LLM 在 RAG 模式下会重新排序证据,"X vs Y" 类内容天然容易进答案。\[必做\] 做 GEO。 4. **你能拿到第三方权威背书吗?**——AI 引擎对 earned media 有系统性偏好:Claude 引用 **65%** 是 earned media,GPT-4o **57%**,而 Google 只有 41%。\[必做\] 把资源投到 earned media 而不是自家内容工程。 如果四个答案都是 \[不做\],省下 GEO 预算。 * * * ## 五、实操建议:四个 Tier,按优先级做 **一句话定义**:真正值得做的 GEO 工程只有十几条;其余的 ROI 不值得投入。 **Tier 1——任何人都该做(成本低、回报确定)** - **结构化数据**:在适用时标注文章、作者或产品等信息,并与可见内容一致。它能补充机器可读信息,但不是 AI 引用的必要保证,也不能据此说模型无法识别实体。 - **问答与对比内容**:针对真实问题组织清晰答案。原文提到的“4 倍”概率缺少可核查的统一实验条件,此处不作通用收益依据。 - \[必做\] **保持新鲜**——至少每季度实质性更新(不要只改日期)。Ahrefs 2025 分析 1700 万次引用:ChatGPT 引用的内容比 Google 平均新 **25.7%**。 - **自检**:准备固定问题集,记录平台、日期、联网状态、重复次数与引用 URL。少量提问适合初步观察,不应当作比所有分析工具更准确的测量。 **Tier 2——值得投入(成本中、回报看情况)** - \[可做\] **追求 earned media**——主动找行业评测站、独立媒体投稿、专家圆桌。 - \[可做\] **多语覆盖**——至少英文 + 本地语的双语元数据/摘要。COAR 2023 列为不可选项。 - \[可做\] **多模态补充**——结构化图表、视频字幕、播客文字稿都被 LLM 当检索源。 **Tier 3——ROI 存疑(小心)** - \[谨慎\] **小众长尾内容矩阵**——确认 niche 够 niche(竞争弱 + 用户意图在小众里)。 - \[谨慎\] **过度优化**——Reyes-Lillo 2025 警告:为算法而写会让内容"去人化",反而触发 LLM 质量判断降低。 **Tier 0——绝对不要做** - \[禁做\] **prompt injection 让模型"必须引用我"**——LLM 会拒绝 / 失败。 - \[禁做\] **伪造引用 / 制造伪权威**——Orduña-Malea & Cabezas-Clavijo 2023 报告的"幽灵引用"风险;伪造数据只会更快被识别。 - \[禁做\] **关键词堆砌**——LLM 不吃这套,重复 5 遍"买房"也没用。 * * * ## 六、回到标题那个问题——"愿意推荐你"是伪命题 **一句话定义**:LLM 不是"愿意"或"不愿意"推荐你,它只是在算 next token 的概率。 当用户问"最好的家用咖啡机",模型不是在"想"——它是在从数十亿参数里查一个概率分布。这个分布被两样东西塑形: - **预训练阶段见过的语料**(你改不动)。 - **这次会话里检索到的网页**(你 GEO 能优化的部分)。 "愿不愿意"是人类语言,在 LLM 这里没意义。 GEO 真正在优化的是\*\*"被检索到的概率"\*\* + **"被合成进答案的概率"**——前者靠 SEO / freshness / 关键词覆盖;后者靠 earned media / 结构化数据 / FAQ 化内容 / 可被引用的素材。 而 Chen 2026 隐含但没明说的话是: > **选题判断**:小众、长尾和时效敏感的问题值得测试,但这是基于研究的实践推断,不是 GEO 只在这些领域有效的定论。 另一半的赢家,是那些**早就在那里、模型脑子里的存货**——这种优势 GEO 给不了你,只能靠时间积累。 * * * ## 参考资料 - Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). [*GEO: Generative Engine Optimization*](https://arxiv.org/abs/2311.09735). In KDD '24. [DOI: 10.1145/3637528.3671900](https://doi.org/10.1145/3637528.3671900). - Chen, M., Wang, X., Chen, K., & Koudas, N. (2025). [*Generative Engine Optimization: How to Dominate AI Search*](https://arxiv.org/abs/2509.08919). arXiv:2509.08919. - Chen, M., Wang, X., Chen, K., & Koudas, N. (2026). [*Navigating the Shift: A Comparative Analysis of Web Search and Generative AI Response Generation*](https://arxiv.org/abs/2601.16858). In EDBT/ICDT 2026 Workshops. arXiv:2601.16858. - Reyes-Lillo, D., Morales-Vargas, A., & Rovira, C. (2025). [*Generative Engine Optimization en repositorios digitales: optimización de la visibilidad para la IA generativa*](https://doi.org/10.3145/infonomy.25.034). Infonomy, 3(5). DOI: [10.3145/infonomy.25.034](https://doi.org/10.3145/infonomy.25.034). ## 迁移校注与补充资料 Google 的 AI 搜索功能文档说明,现有 SEO 基础仍然适用,无需特殊的 AI 专用结构化数据。其内容质量文档也明确,E-E-A-T 本身不是一个具体排名因子。这些说明适用于 Google 的公开文档,不能直接代替其他服务的实现说明。 - [Google:AI features and your website](https://developers.google.com/search/docs/appearance/ai-features) - [Google:Creating helpful, reliable, people-first content](https://developers.google.com/search/docs/fundamentals/creating-helpful-content) - [GEO: Generative Engine Optimization](https://arxiv.org/abs/2311.09735):摘要中的最高提升值属于实验结果,不是单个网站的收益保证。 相关阅读:[如何做好 GEO 优化](https://www.iowill.com/blog/2026/08/geo-optimization-practice/) --- --- title: "如何做好 GEO 优化" source: https://www.iowill.com/blog/2026/08/geo-optimization-practice/ date: 2026-08-11 updated: 2026-10-08 tags: [AI搜索, E-E-A-T, GEO, SEO, 内容优化] categories: [软件与工具] --- # 如何做好 GEO 优化 > 迁移说明:本文原发表于 [Billy 原站](https://billy12.xyz/archives/EbnkikHE),保留原发布时间,2026 年 10 月 8 日迁入本站并重新配图。迁移时保留主体结构,对效果保证、评价指标和平台机制的绝对化表述补充校注。文中历史研究或平台报告的数值受样本、版本与指标定义限制,不代表本站实测,也不构成收录、推荐或转化保证。 ## 行业现状 GEO 内容运营中容易出现一种误区:投入大量自动生成文章,却没有同步检查信息质量、来源和真实引用情况。本文整理的是方法与资料,不以未展示的客户案例作为效果证据。 原因在于 AI 模型判断内容不看数量看质量——内容的结构化程度、权威背书、用户场景匹配度才是核心。 用 AI 写作 + 软件分发的做法本质上还是 SEO 时代的堆量思维,在 GEO 时代已经失效了。 真正的 GEO 需要三个核心转变: - 从关键词优化转向**场景化内容**(AI 时代用户提问平均 24-27 个词,是带具体场景的完整问题) - 从情绪化文案转向**逻辑证明**(用数据和案例支撑观点) - 从海量投放转向**精准信源布局**(优先布局官网、官方号和行业权威媒体) 做 GEO 最怕的就是把 AI 写作 + 软件分发当成万能药,内容质量不够,发再多也没用。 GEO 的核心是让 AI 理解你是什么、凭什么可信,而不是刷存在感。关键是三个维度:**内容结构要清晰、论据要有来源支撑、发布渠道要有权重**。三者缺一不可,少一个 AI 都很难主动引用你的内容。 * * * ## AI 自身也"做搜索" Kimi、秘塔等联网型 AI 调用搜索结果作为信源——你的 SEO 排名仍然间接影响 AI 引用率。 做 AI 检索内容优化时,必须用 E-E-A-T 标准搭建高可信度内容。逻辑链: > 一种便于理解的流程是:发现相关页面 → 检索与筛选信息 → 生成答案并可能附带引用。各产品实现不同,不能把 E-E-A-T 描述为所有 AI 引擎统一执行的打分算法。 * * * ## 一、E-E-A-T(谷歌内容可信度标准) **全称**:Experience(真实经验)、Expertise(专业度)、Authoritativeness(权威性)、Trustworthiness(可信度) 2022 年谷歌在原版 E-A-T 基础上加了第一个 E「Experience」,变成 E-E-A-T: | 维度 | 含义 | | --- | --- | | **Experience 真实经验** | 内容来自一手实测、亲身经历,比如亲自用过 APP、现场看球赛、实地体验,不是纯摘抄搬运 | | **Expertise 专业度** | 作者 / 平台有对应领域资质,专业知识(医生写医疗,体育编辑讲赛事,律师讲法规) | | **Authoritativeness 权威性** | 平台、作者、内容被行业、官方、媒体认可;政府官网、央媒、头部垂直媒体权威最高,个人小自媒体权威极低 | | **Trustworthiness 可信度** | 信息准确、来源透明、无虚假宣传、网站备案完整、标注引用出处、不篡改原文 |  E-E-A-T 可帮助检查内容质量;图示不是 AI 服务内部的评分公式。 * * * ## 二、不合格参考信源如何被引用 - 搜索结果里出现某个站点,并不等于生成答案采信了它的全部观点。需要分别查看检索结果、答案内容和实际引用,不能仅凭出现位置判断信任权重。 - 核对授权、服务范围等问题时,可以优先寻找相关机构的一手公告。但“官方”身份不是任何表述都正确的保证,仍需检查发布时间与问题是否匹配。 - 缺少出处或实测的转载页面,难以支撑复杂判断;个人站点也可能提供有价值的一手经验,不能仅按站点规模断言 AI 只会从中提取名词。 * * * ## 三、GEO 核心方法论(基于 KDD 2024 论文) 市场现状:联网问答正在成为用户获取信息的一种入口。原文引用的月活数未附可核对的统计口径,迁移版不保留具体数值。 根本变化:用户不再看"10 条候选链接并自己比较",而是直接信任并接受"AI 给的一段直接答案"。如果你的品牌不在 AI 的答案里,几乎等于不存在。 核心论点:GEO 与 SEO 存在目标侧重和衡量方式的差异,但并不互相替代。需要持续观察内容变化与引用表现,没有适用于所有网站的固定见效周期。 黑盒挑战:AI 存在"答案漂移"(同问题多次问答案不同)、黑盒推荐、多平台算法差异等痛点。 ### 1\. 白皮书引入的权威方法 白皮书引入了普林斯顿等机构在 KDD 2024 发表的权威论文方法(arXiv:2311.09735),量化了 9 种内容优化方法对 AI 引用率的影响: **头部高收益方法:** 口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。 | 方法 | 提升幅度 | 说明 | | --- | --- | --- | | 引述添加 | +42.6% | 在内容中加入带引号的专家或客户原话。AI 偏好这种高信息密度的可复用片段 | | 数据添加 | +32.8% | 内容中多包含具体数字、单位和时间 | | 流畅度优化 | +28.7% | — | | 引用来源 | +27.7% | — | **必须避免的反模式:** 口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。 | 方法 | 影响 | 说明 | | --- | --- | --- | | 关键词堆砌 | \-8.7% | 在同一段落内重复关键词 ≥5 次。AI 经对抗训练会识别为低质 Spam 并主动降权(与传统 SEO 关键词密度思维相反) | 其他痛点:句子过长(平均 >50 字)、空话堆砌(如"致力于/极致/赋能"等定性词过多)、纯口号无数据。 ### 2\. 九维 GEO 指数体系 为精确评估品牌的 GEO 现状,平台设计了九维加权评分,并根据不同行业(如律所重信源、餐饮重情感)动态调整权重: 口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。 | 维度 | 默认权重 | 说明 | | --- | --- | --- | | 提及率 | 20% | 全部样本中 AI 提到品牌的比例(入门门票,没它后面都没意义) | | 推荐位排名 | 12% | 列表型回答中品牌排第几位(第 1 与第 5 转化率差 5-10 倍) | | 引用强度 | 12% | 强引用(首选推荐)vs 弱提及(列在长清单里) | | 稳定性 | 12% | 多次采样间的波动反比(AI 存在答案漂移,需多次采样看滚动窗) | | 情感正向率 | 10% | 被提及内容中正向语义的比例(负向提及是品牌资产损耗) | | 平台覆盖率 | 10% | 6 大主流 AI 平台中提到了几个(防流量过于集中和脆弱) | | 直接命中率 | 8% | 实体名原样出现 vs 间接指代(直接命中是最强引用证据) | | 自有信源被引率 | 8% | AI 引用来源 URL 中企业官网等自有信源的占比 | | 联网引用率 | 8% | AI 回答附带外部链接的比例 | 最终得分对应 S(85+)、A(70-85)、B(55-70)、C(35-55)、D(<35)五个评级。低于 35 分为 D 级,急需建立基线。 ### 3\. GEO 运营 30 天落地闭环指南  30 天是组织工作的示例周期,不保证在此期间获得引用或排名提升。 GEO 是一个包含监测、诊断、生产、发布、追踪、反哺的完整闭环: **第 1 周:基线监测与真相档案** 录入企业的"真相档案"(成立时间、主营、核心团队、客户名单、资质等)。利用 Query Fanout 25 矩阵,将 1 个核心查询扩散为覆盖客户全决策旅程(认知、对比、验证、避坑、价格)的 25 个变体,并建立初始评级。 **第 2 周:诊断与优先级排序** 开启反模式雷达,扫描官网及现有内容。运行品牌误解识别:检查 AI 是否"说错"你(如时间、资质错误),按 High/Medium/Low 严重级即时拦截或在后续内容中纠偏。找出与竞品的 Gap 查询(竞品独占的搜索词)。 **第 3 周:内容精准生产** 针对 Gap 查询,利用平台生成器产出 5-8 篇优化内容(融入数据、引述,并自动附带 Schema.org JSON-LD 结构化代码,如 Organization、Article、FAQPage 等)。 **第 4 周:多平台适配发布与追踪** 拒绝一键群发:同一主稿必须根据微信公众号(严肃专业)、知乎(问句+案例)、小红书(emoji+短句)等不同平台的算法规则进行独立适配,否则会被平台整体降权。发布后在 D+7、D+14、D+28 自动复测,追踪 Before/After Lift(提升曲线),用数据反哺下一轮选题。 ### 4\. 技术壁垒:分布式真实节点采样 采样设计需要区分 API 与产品界面的实际差异,记录模型、联网状态和时间;不能预设 API 一定是降级模型。以下保留平台方案中的分析思路,不把供应商描述当成独立验证结果。 - **浏览器界面采样**:在有权访问的页面记录实际展示结果;测试环境与条件保持可追溯,不把共享登录凭据或绕过风控作为 GEO 方法。 - **双层语义判定**:先进行规则粗筛(字符串/别名/同名歧义过滤),再由 LLM 判定具体的位置、情感与置信度,低置信度(<0.5)扣减分数防止虚高。 - **句子级引用检查**:保留答案已有的引用标记,并核对来源是否支持相应句子。仅按句号拆分或语义相似,不能证明一句话来自某个 URL。 - **多模态采样取证**:每次采样自动留存 1-3 分钟录屏(存腾讯云 COS)、关键截图和原文,便于回溯和向客户演示。 * * * ## 参考链接 - [DataFocus GEO 平台](https://app.datafocus.ai/focusgeo/manual/) - [GEO MWDC Info](https://geo.mwdc.info/) - [GEO 白皮书](https://geo.mwdc.info/whitepaper.html) ## 迁移校注与补充资料 Google 的 AI 搜索功能文档说明,现有 SEO 基础仍然适用,无需特殊的 AI 专用结构化数据。其内容质量文档也明确,E-E-A-T 本身不是一个具体排名因子。这些说明适用于 Google 的公开文档,不能直接代替其他服务的实现说明。 - [Google:AI features and your website](https://developers.google.com/search/docs/appearance/ai-features) - [Google:Creating helpful, reliable, people-first content](https://developers.google.com/search/docs/fundamentals/creating-helpful-content) - [GEO: Generative Engine Optimization](https://arxiv.org/abs/2311.09735):摘要中的最高提升值属于实验结果,不是单个网站的收益保证。 相关阅读:[GEO 是什么?它真的能让大模型‘愿意推荐你’吗?](https://www.iowill.com/blog/2026/08/what-is-geo/) --- --- title: "云服务器Debian12根分区扩容记录" source: https://www.iowill.com/blog/2025/04/cloud-debian12-root-resize/ date: 2025-04-18 updated: 2026-10-14 tags: [Debian, LVM, Linux, 磁盘扩容] categories: [系统与运维] --- # 云服务器Debian12根分区扩容记录 > \[!WARNING\] > > 以下操作可能会导致包括但不仅限于数据丢失、无法启动等问题,严重时您可能需要重装系统,如要继续,请确保已做好数据备份等准备工作。 ## 前言 云上Debian12的机器,使用 `df -Th` 查看磁盘分区信息: ```text root@xxx:~# df -Th Filesystem Type Size Used Avail Use% Mounted on udev devtmpfs 3.8G 0 3.8G 0% /dev tmpfs tmpfs 775M 852K 775M 1% /run /dev/vda1 ext4 19G 5.7G 12G 33% / tmpfs tmpfs 3.8G 0 3.8G 0% /dev/shm tmpfs tmpfs 5.0M 0 5.0M 0% /run/lock tmpfs tmpfs 775M 0 775M 0% /run/user/0 overlay overlay 19G 5.7G 12G 33% /var/lib/docker/overlay2/85022b6945d418b6979839b3897502dd192a7c7b11993f1a5e30b6f3af579595/merged overlay overlay 19G 5.7G 12G 33% /var/lib/docker/overlay2/faa3aef89ddf6113d5d5805e64bc6abeeb3cd5d01da27dde5e39dc7af7f399c4/merged overlay overlay 19G 5.7G 12G 33% /var/lib/docker/overlay2/e691e3e85e02b056a6001d2b3bffcb9033a6f6456bc5aac1c6ccc1cffbb4ead6/merged overlay overlay 19G 5.7G 12G 33% /var/lib/docker/overlay2/4c14da4bf849dba7c6d05c5bb7a3d4721a2a436efaff3b2dc14ad86885ad4cd5/merged ``` 可以看到根分区/dev/vda1只有19G,`lsblk`查看磁盘使用情况: ```text root@xxx:~# lsblk NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS sr0 11:0 1 1024M 0 rom vda 254:0 0 20G 0 disk ├─vda1 254:1 0 19G 0 part / ├─vda2 254:2 0 1K 0 part └─vda5 254:5 0 975M 0 part [SWAP] vdb 254:16 0 30G 0 disk ``` 可以看到未使用的磁盘有30G,现在想把这30G加到根分区上去,思路就是采用LVM逻辑卷管理动态扩容,建立一个逻辑卷组,把vda和vdb都加入此卷组,达到物理上是两块不同磁盘,但逻辑上合并为一块磁盘的效果。 ## 1.将磁盘vdb初始化为物理卷 ```bash pvcreate /dev/vdb ``` ### 期望输出 ```shell root@xxx:~# pvcreate /dev/vdb Physical volume "/dev/vdb" successfully created. ``` ## 2.新建卷组并将vdb加入此卷组 ```bash vgcreate vg_root /dev/vdb ``` ### 期望输出 ```shell root@xxx:~# vgcreate vg_root /dev/vdb Volume group "vg_root" successfully created ``` ### ERROR1跳转解决方法 [跳转](#error_1) ```shell root@xxx:~# pvcreate /dev/vdb Can't initialize physical volume "/dev/vdb" of volume group "vg_root" without -ff /dev/vdb: physical volume not initialized. ``` ## 3.在卷组中创建逻辑卷 ```bash lvcreate -l 100%FREE -n lv_root vg_root ``` ### 期望输出 ```shell root@xxx:~# lvcreate -l 100%FREE -n lv_root vg_root WARNING: ext4 signature detected on /dev/vg_root/lv_root at offset 1080. Wipe it? [y/n]: y Wiping ext4 signature on /dev/vg_root/lv_root. Logical volume "lv_root" created. ``` ### ERROR2跳转解决方法 [跳转](#error_2) ```shell root@debian:~# lvcreate -l 100%FREE -n lv_root vg_root Volume group "vg_root" not found Cannot process volume group vg_root ``` 可以使用`lsblk`命令查看vdb上已经创建了该逻辑卷: ```shell root@xxx:~# lsblk NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS sr0 11:0 1 1024M 0 rom vda 254:0 0 20G 0 disk ├─vda1 254:1 0 19G 0 part / ├─vda2 254:2 0 1K 0 part └─vda5 254:5 0 975M 0 part [SWAP] vdb 254:16 0 30G 0 disk └─vg_root-lv_root 253:0 0 30G 0 lvm ``` ## 4.使用etx4文件系统格式化此逻辑卷 ```bash mkfs.ext4 /dev/vg_root/lv_root ``` ### 期望输出 ```shell root@xxx:~# mkfs.ext4 /dev/vg_root/lv_root mke2fs 1.47.0 (5-Feb-2023) Creating filesystem with 7863296 4k blocks and 1966080 inodes Filesystem UUID: a8a07510-2b4c-4ac7-8524-cafcb4393283 Superblock backups stored on blocks: 32768, 98304, 163840, 229376, 294912, 819200, 884736, 1605632, 2654208, 4096000 Allocating group tables: done Writing inode tables: done Creating journal (32768 blocks): done Writing superblocks and filesystem accounting information: done ``` ## 5.修改`/etc/fstab` 首先使用`blkid`命令得到上面创建的**vg\_root-lv\_root**逻辑卷的**UUID**: ```shell root@xxx:~# blkid /dev/vdb: UUID="Av2nxJ-l57c-uZoz-zFQ8-w90P-4s5F-2NhUZD" TYPE="LVM2_member" /dev/mapper/vg_root-lv_root: UUID="a8a07510-2b4c-4ac7-8524-cafcb4393283" BLOCK_SIZE="4096" TYPE="ext4" /dev/vda5: UUID="155c5478-3b21-4c5c-ab1d-5bc39961d1b7" TYPE="swap" PARTUUID="35ce1eaa-05" /dev/vda1: UUID="63dc08fe-cf76-4097-b849-c9db03ce9b84" BLOCK_SIZE="4096" TYPE="ext4" PARTUUID="35ce1eaa-01" ``` ### 示例: `nano /etc/fstab`,其原内容如下: ```ini # /etc/fstab: static file system information. # # Use 'blkid' to print the universally unique identifier for a # device; this may be used with UUID= as a more robust way to name devices # that works even if disks are added and removed. See fstab(5). # # systemd generates mount units based on this file, see systemd.mount(5). # Please run 'systemctl daemon-reload' after making changes here. # #`预格式化文本(Preformatted Text)的功能。
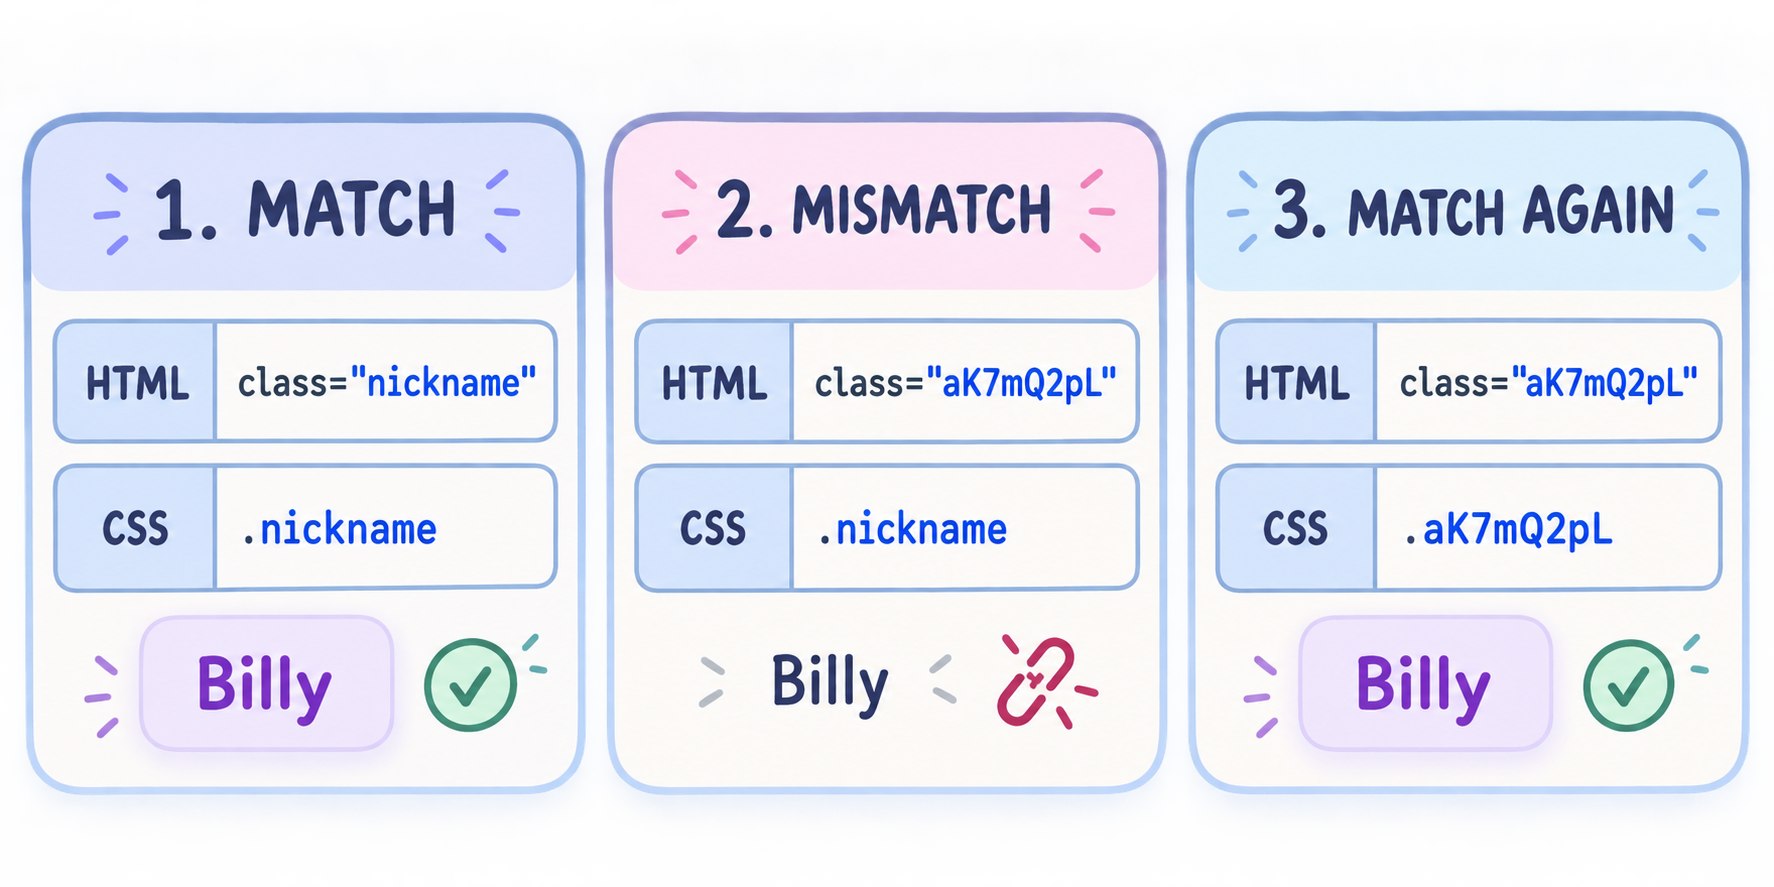
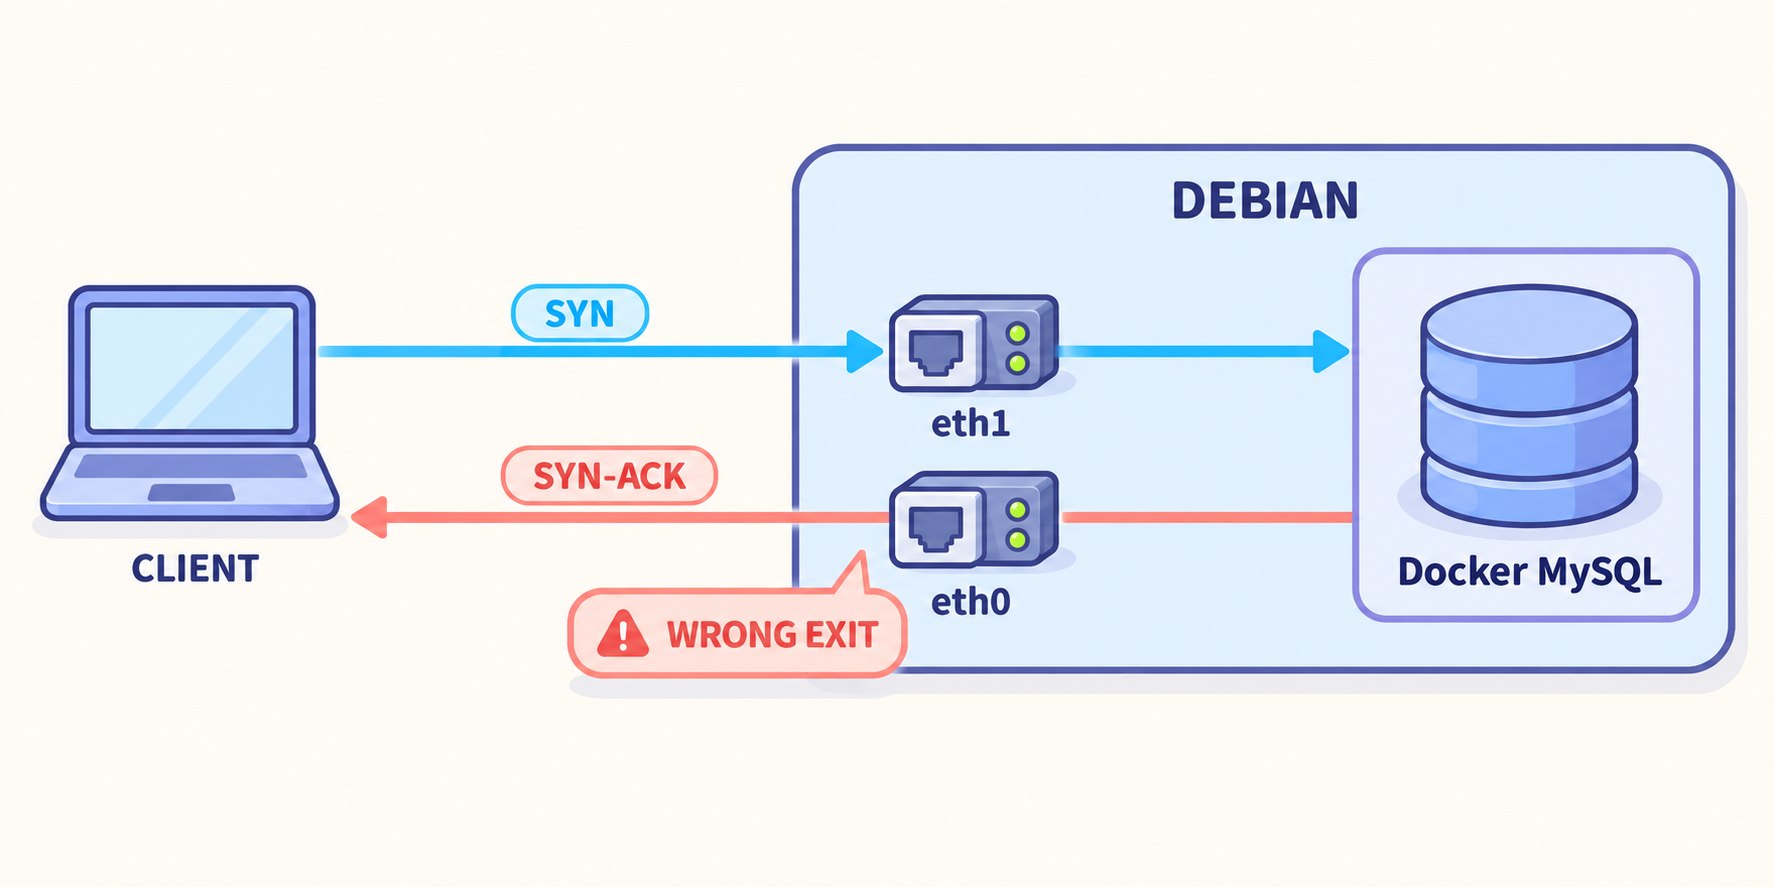
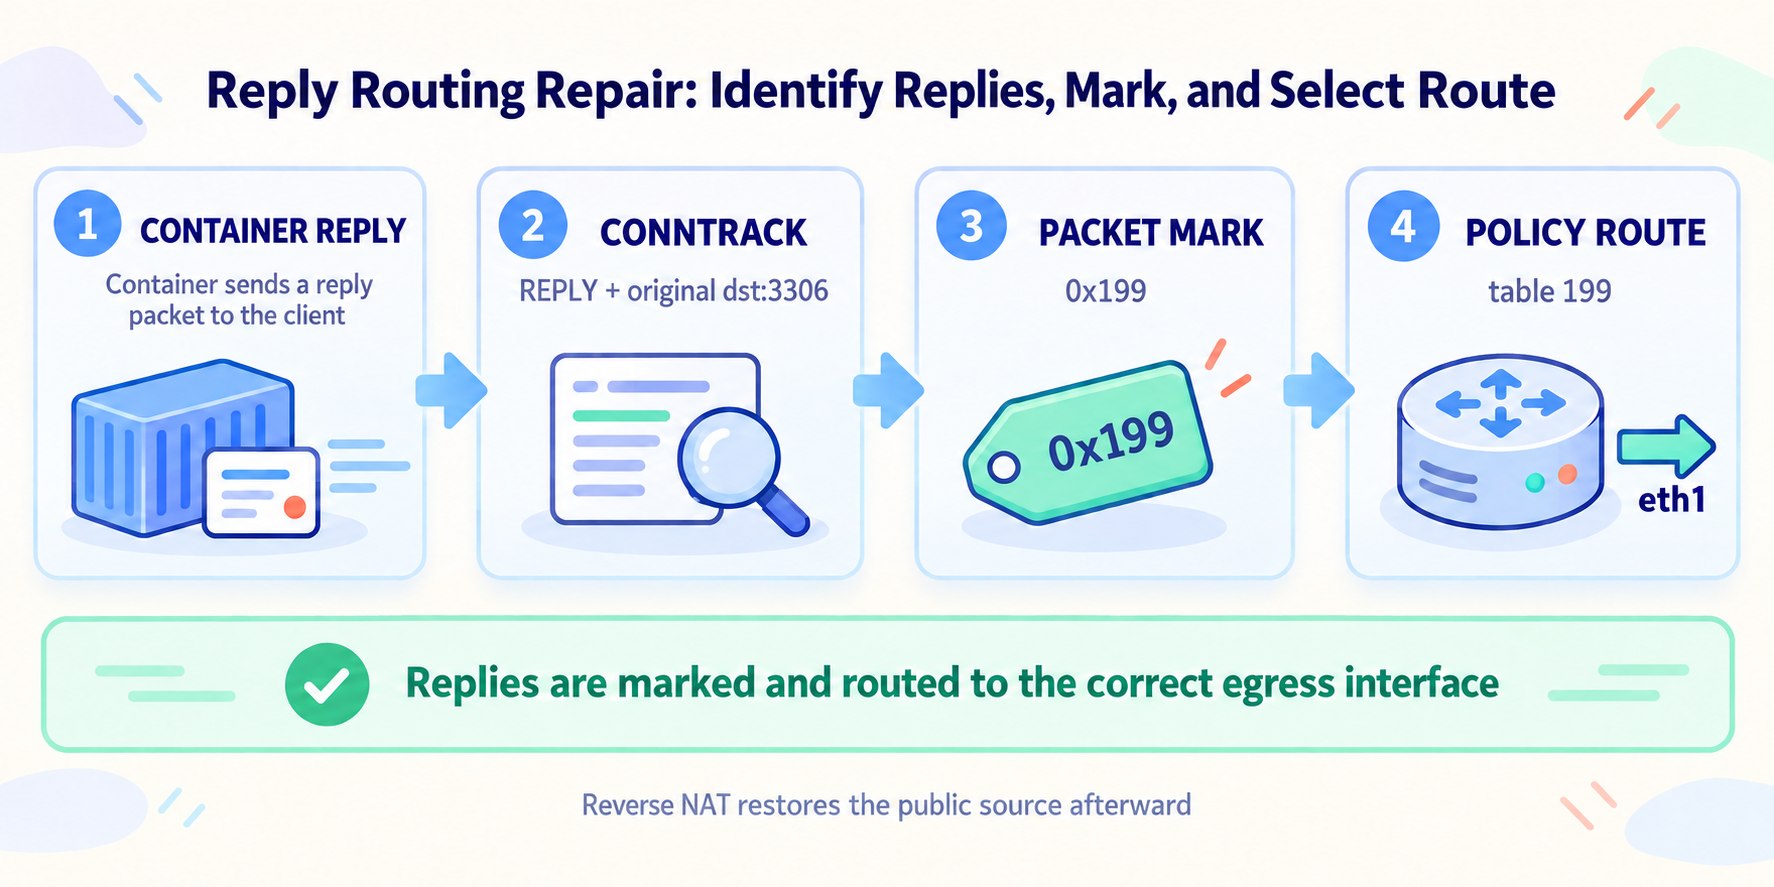
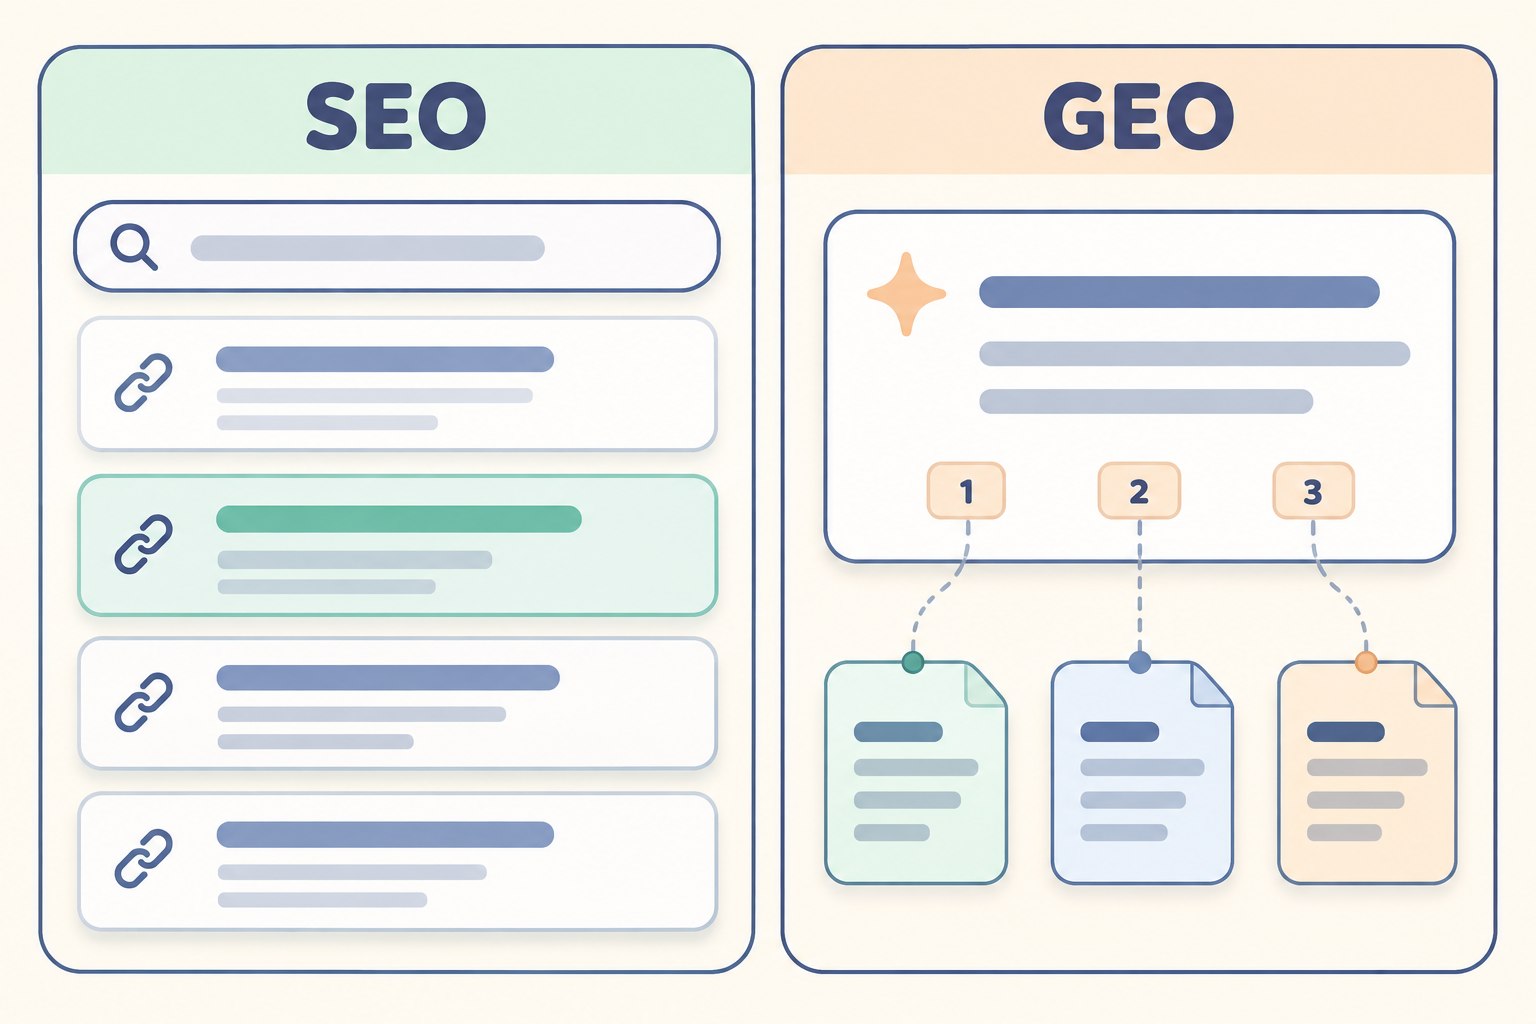
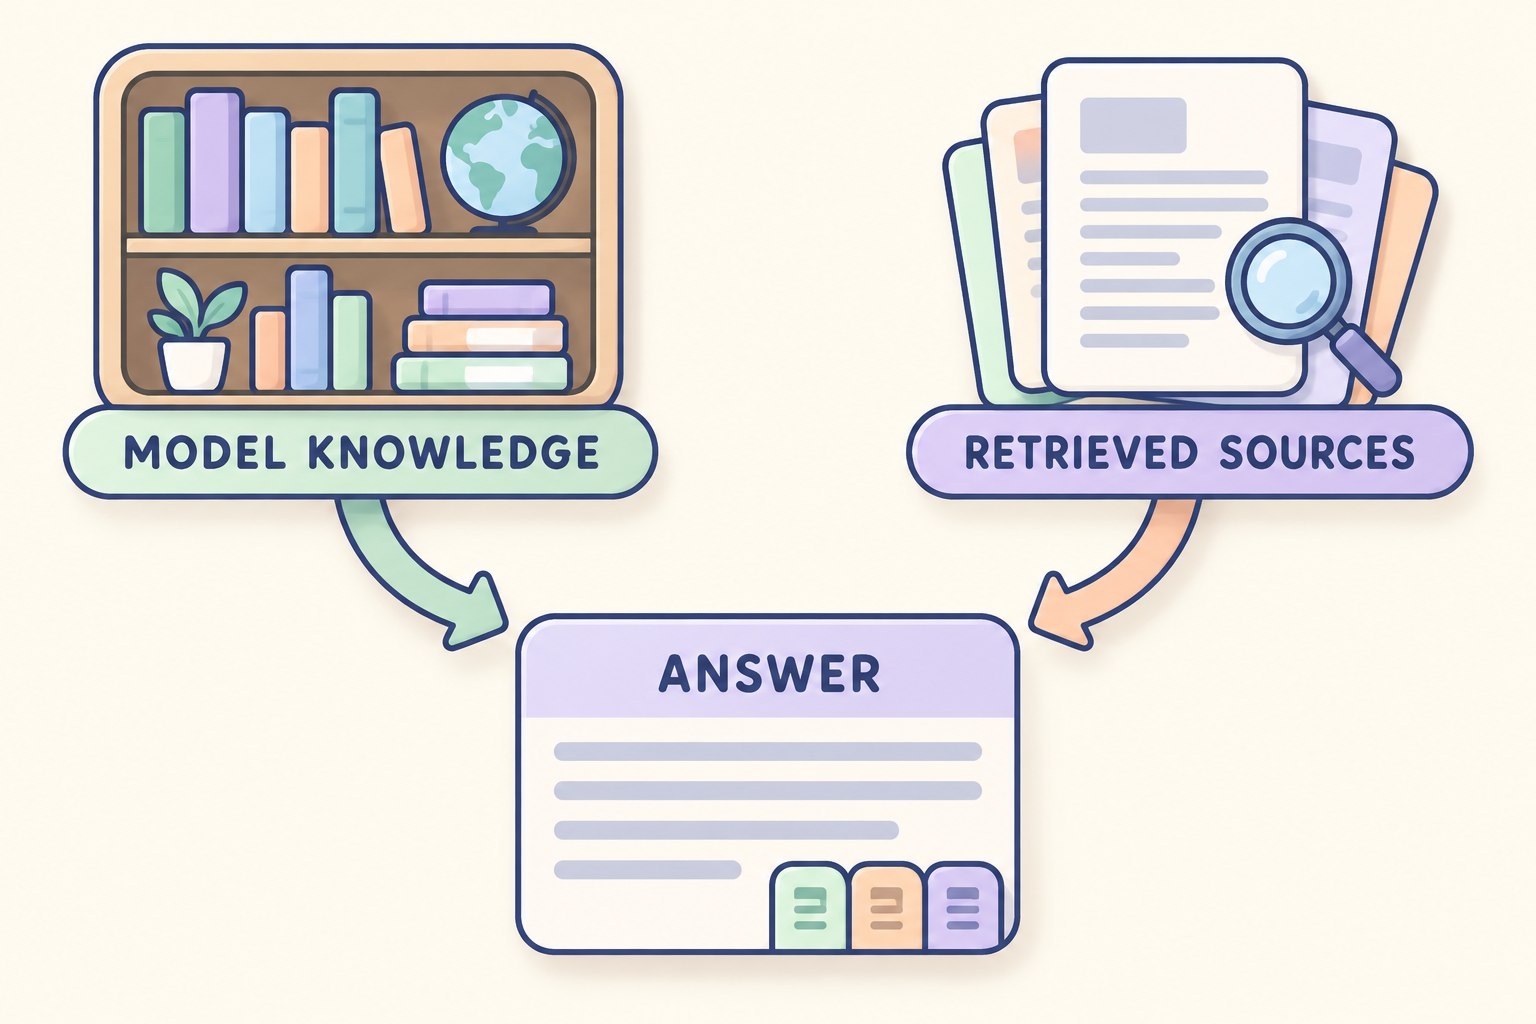
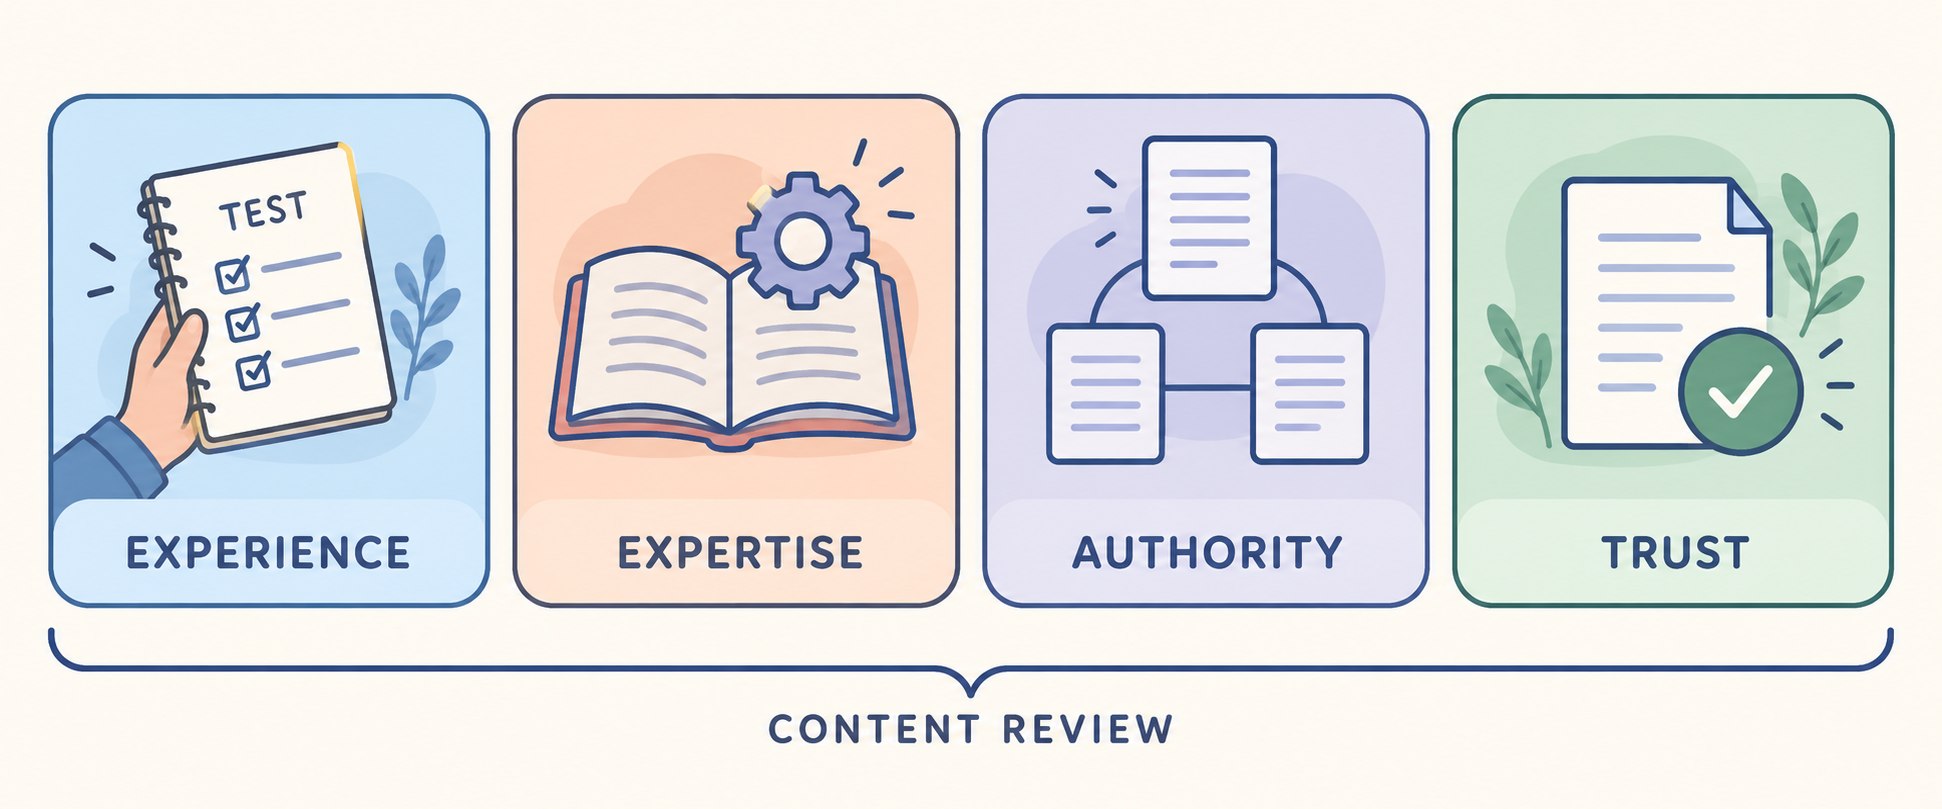
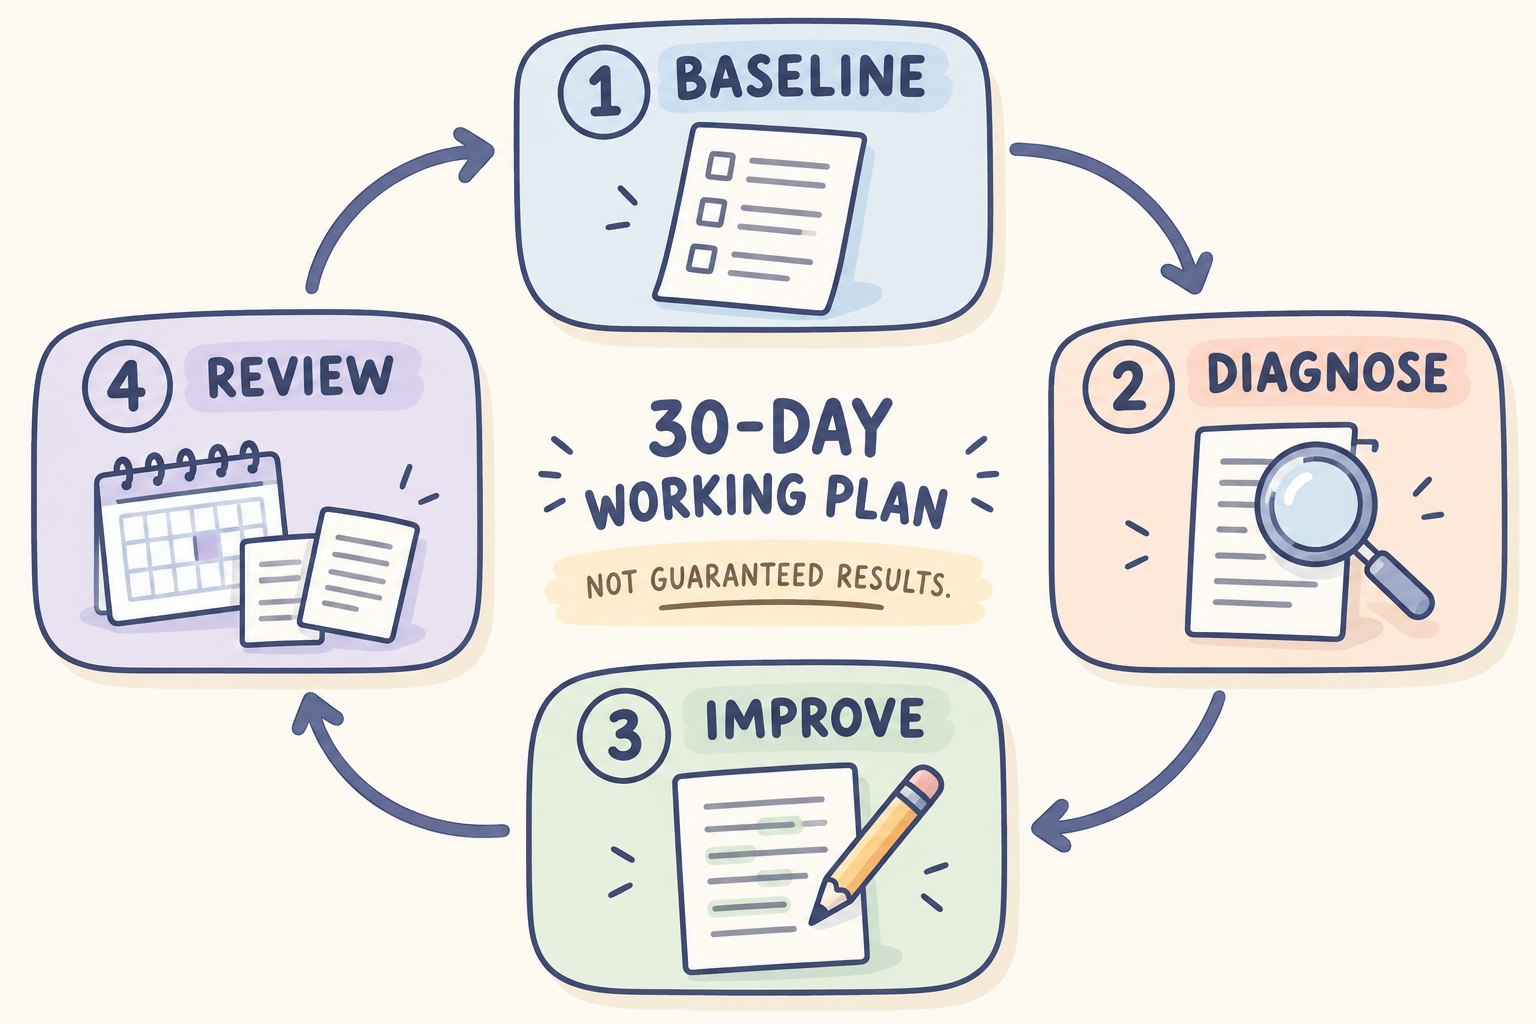
```
```
预格式化文本:
```
| First Header | Second Header |
| ------------- | ------------- |
| Content Cell | Content Cell |
| Content Cell | Content Cell |
```
#### JS代码
```javascript
function test(){
console.log("Hello world!");
}
(function(){
var box = function(){
return box.fn.init();
};
box.prototype = box.fn = {
init : function(){
console.log('box.init()');
return this;
},
add : function(str){
alert("add", str);
return this;
},
remove : function(str){
alert("remove", str);
return this;
}
};
box.fn.init.prototype = box.fn;
window.box =box;
})();
var testBox = box();
testBox.add("jQuery").remove("jQuery");
```
#### HTML代码 HTML codes
```html
Hello world!
Hello world!
```
### 图片 Images
Image:
> Follow your heart.
> 图为:厦门白城沙滩
图片加链接 (Image + Link):
[](https://pandao.github.io/editor.md/examples/images/7.jpg "李健首张专辑《似水流年》封面")
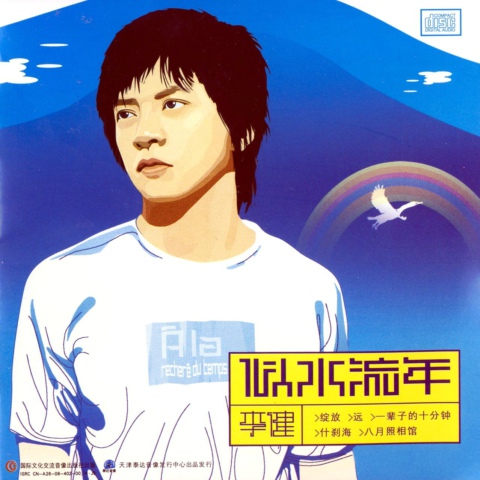
> 图为:李健首张专辑《似水流年》封面
* * *
### 列表 Lists
#### 无序列表(减号)Unordered Lists (-)
- 列表一
- 列表二
- 列表三
#### 无序列表(星号)Unordered Lists (\*)
- 列表一
- 列表二
- 列表三
#### 无序列表(加号和嵌套)Unordered Lists (+)
- 列表一
- 列表二
- 列表二-1
- 列表二-2
- 列表二-3
- 列表三
- 列表一
- 列表二
- 列表三
#### 有序列表 Ordered Lists (-)
1. 第一行
2. 第二行
3. 第三行
#### GFM task list
- [x] GFM task list 1
- [x] GFM task list 2
- [ ] GFM task list 3
- [ ] GFM task list 3-1
- [ ] GFM task list 3-2
- [ ] GFM task list 3-3
- [ ] GFM task list 4
- [ ] GFM task list 4-1
- [ ] GFM task list 4-2
* * *
### 绘制表格 Tables
| 项目 | 价格 | 数量 |
| --- | --: | :-: |
| 计算机 | $1600 | 5 |
| 手机 | $12 | 12 |
| 管线 | $1 | 234 |
| First Header | Second Header |
| --- | --- |
| Content Cell | Content Cell |
| Content Cell | Content Cell |
| First Header | Second Header |
| --- | --- |
| Content Cell | Content Cell |
| Content Cell | Content Cell |
| Function name | Description |
| --- | --- |
| `help()` | Display the help window. |
| `destroy()` | **Destroy your computer!** |
| Left-Aligned | Center Aligned | Right Aligned |
| :-- | :-: | --: |
| col 3 is | some wordy text | $1600 |
| col 2 is | centered | $12 |
| zebra stripes | are neat | $1 |
| Item | Value |
| --- | --: |
| Computer | $1600 |
| Phone | $12 |
| Pipe | $1 |
* * *
#### 特殊符号 HTML Entities Codes
© & ¨ ™ ¡ £
& < > ¥ € ® ± ¶ § ¦ ¯ « ·
X² Y³ ¾ ¼ × ÷ »
18ºC " '
### Emoji表情 :smiley:
> Blockquotes :star:
#### GFM task lists & Emoji & fontAwesome icon emoji & editormd logo emoji :editormd-logo-5x:
- [x] :smiley: @mentions, :smiley: #refs, [links](https://www.iowill.com/blog/2024/07/markdown-editor/), **formatting**, and ~tags~ supported :editormd-logo:;
- [x] list syntax required (any unordered or ordered list supported) :editormd-logo-3x:;
- [x] \[ \] :smiley: this is a complete item :smiley:;
- [ ] \[\]this is an incomplete item [test link](#) :fa-star: @pandao;
- [ ] \[ \]this is an incomplete item :fa-star: :fa-gear:;
- [ ] :smiley: this is an incomplete item [test link](#) :fa-star: :fa-gear:;
- [ ] :smiley: this is :fa-star: :fa-gear: an incomplete item [test link](#);
#### 反斜杠 Escape
\*literal asterisks\*
### 科学公式 TeX(KaTeX)
$$E=mc^2$$
行内的公式$$E=mc^2$$行内的公式,行内的$$E=mc^2$$公式。
$$(\\sqrt{3x-1}+(1+x)^2)$$
$$\\sin(\\alpha)^{\\theta}=\\sum\_{i=0}^{n}(x^i + \\cos(f))$$
多行公式:
```plaintext
\displaystyle
\left( \sum\_{k=1}^n a\_k b\_k \right)^2
\leq
\left( \sum\_{k=1}^n a\_k^2 \right)
\left( \sum\_{k=1}^n b\_k^2 \right)
```
```plaintext
\displaystyle
\frac{1}{
\Bigl(\sqrt{\phi \sqrt{5}}-\phi\Bigr) e^{
\frac25 \pi}} = 1+\frac{e^{-2\pi}} {1+\frac{e^{-4\pi}} {
1+\frac{e^{-6\pi}}
{1+\frac{e^{-8\pi}}
{1+\cdots} }
}
}
```
```latex
f(x) = \int_{-\infty}^\infty
\hat f(\xi)\,e^{2 \pi i \xi x}
\,d\xi
```
### 绘制流程图 Flowchart
```plaintext
st=>start: 用户登陆
op=>operation: 登陆操作
cond=>condition: 登陆成功 Yes or No?
e=>end: 进入后台
st->op->cond
cond(yes)->e
cond(no)->op
```
### 绘制序列图 Sequence Diagram
```plaintext
Andrew->China: Says Hello
Note right of China: China thinks\nabout it
China-->Andrew: How are you?
Andrew->>China: I am good thanks!
```
### End