GEO 效果监测怎么做?提及、引用、推荐与事实准确性的区别
GEO(生成式引擎优化)效果监测需要回答:在什么问题、平台入口和采样条件下,品牌如何出现在回答中,哪些信息得到引用,以及回答是否准确。一次出现品牌、一个引用链接或一条脚本成功日志,分别代表不同事实。
本文给出一套面向项目执行与客户复盘的监测方法,覆盖采样、标注、统计和解释。它可以用于建立基线和观察变化,不能单凭一组前后数字证明内容修改导致了效果提升。
文中“协页知识库”为虚构教学产品;全部样本编号、数量、回答片段与比例均为模拟数据。没有实际调用平台、运行品牌实验或获得项目效果。 方法中的问题数量、重复次数和字段是作者建议,须按实际平台能力、预算与授权调整。
提及、引用、推荐和准确性分别记录
四种结果可以同时出现,也可能互相分离。
| 维度 | 本文工作定义 | 不能据此推断什么 |
|---|---|---|
| 品牌提及 | 回答正文出现经人工确认的目标品牌或明确别名 | 不代表推荐,也不代表引用了官网 |
| 链接引用 | 回答可见来源中出现可归属到目标自有站点的链接 | 不代表链接支持了相邻论点或带来访问 |
| 正向推荐 | 回答在相应条件下明确把产品作为可选方案提出 | 不把负向评价、随口列名或条件不成立的表述算推荐 |
| 事实准确性 | 回答中的可核查品牌事实与事先确定的依据一致 | 无法核验或没有事实陈述时,不能自动记为全部正确 |
“协页知识库不适合这个场景”包含提及,但不是正向推荐。某篇第三方文章谈到协页,AI引用了它,属于第三方品牌相关来源;本文的“自有站点被引”不把它算进分子,应单独记录。
回答引用官网,也可能把“部分套餐支持”写成“所有套餐支持”。因此,看到链接后还要检查它支持了什么。
Evaluating Verifiability in Generative Search Engines在摘要中区分了引用的完整支持与准确支持问题。本文借用这一区分,不把其2023年样本结果当作当前平台表现,也不将本文简化指标称为复现论文实验。
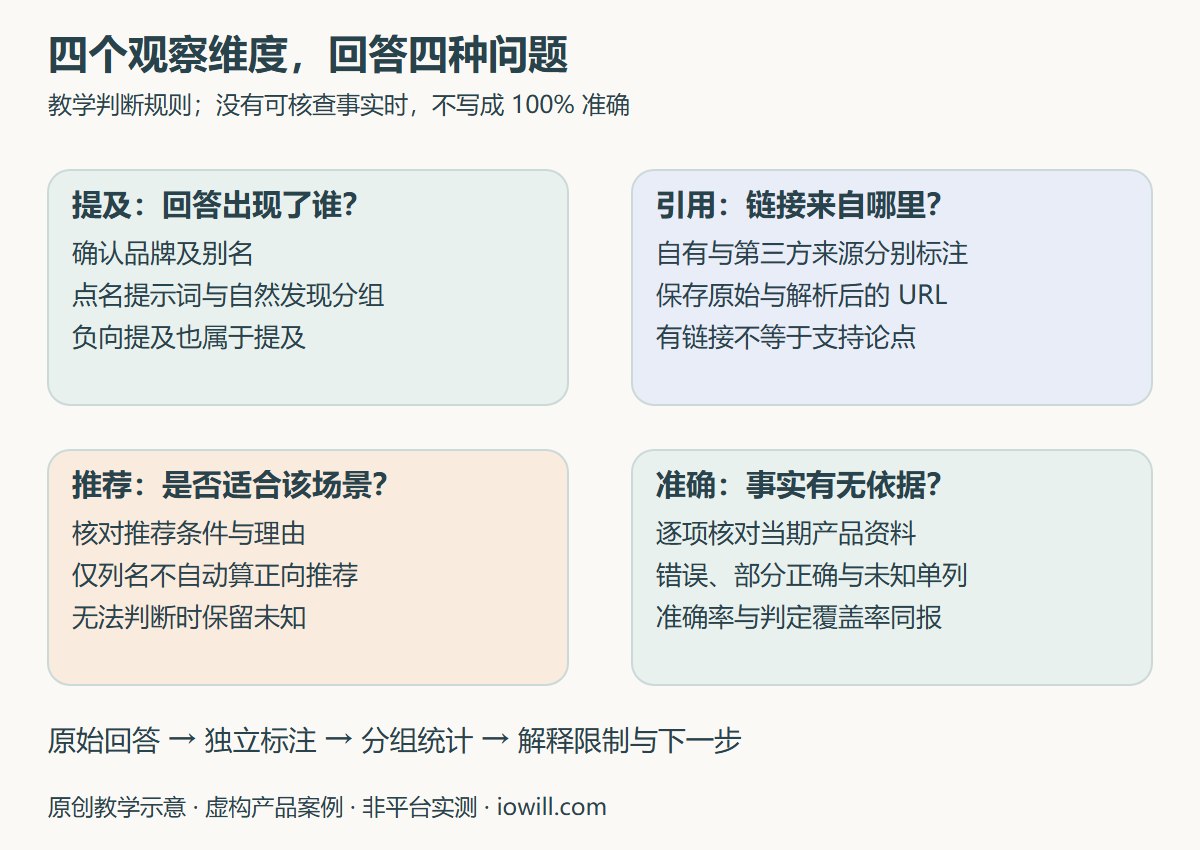
图1:原创教学示意:四个维度分别标注,不把品牌出现或有链接直接当作正向推荐与事实正确。
先确定监测单元与问题集版本
一次原始采样记录可以定义为:
一个问题版本,在指定平台和入口、明确环境与联网设置下,于一个时间点发起的一次请求。
一次请求失败后重新发起,属于另一次请求,关联原记录。若最终只选取一次重试回答用于分析,应预先约定“采用首个满足有效性规则的回答”等选择规则,同时公开总尝试数及重试数;不能反复请求直到出现品牌再保留。
问题集沿用台账中的三类意图,但单独标记是否点名品牌。泛搜索问题更适合观察非点名的自然发现;口碑与对比问题可以检查已知品牌场景下的解释和事实,不能与前者混成同一种曝光指标。
本教学项目假设共有12个问题。前后批次使用同一版本,提示词逐字保存。新增问题、修改关键条件或改用不同入口时,另建分组或版本;旧题与新题不能直接接成连续趋势。
固定采样环境并保留不可控条件
可以控制的条件尽量固定,无法控制的明确记录。建议保存以下字段。
| 字段组 | 需要记录的内容 |
|---|---|
| 问题 | 编号、版本、完整提示词、主要类型、是否点名品牌 |
| 平台 | 产品名称、网页或App入口、可见模型标识;未展示版本时写“未展示” |
| 运行环境 | 地区、语言、联网模式、脱敏账号环境编号、是否新会话及记忆设置 |
| 时间与批次 | 含时区时间、批次编号、采样顺序、重试关联 |
| 原始证据 | 回答全文、可见来源URL、截图或记录文件、采集方式 |
| 外部变化 | 内容发布与修改、站点故障、平台可见设置或产品变化 |
新的会话不一定消除账号个性化和记忆影响。能关闭的设置按计划关闭并记录;无法核实的限制写进报告。同一产品的API输出,也不能直接替代消费者网页端联网回答。
不要在采样前把品牌资料和llms.txt粘进同一会话,再把后续品牌复述称为独立搜索露出。涉及不同实验组时,还需要考虑账号、会话及采样过程之间的相互影响。
异常不应消失在统计表里
采样前先规定哪些记录可以用于回答内容分析。
| 状态 | 本文处理方式 |
|---|---|
| 回答完整、属于指定联网模式,未出现品牌 | 有效回答;保留为未提及、未引用等零结果 |
| 回答完整但没有引用链接 | 在平台不保证每次列来源的前提下仍可有效;记录未引用 |
| 超时、验证码、登录失效、页面无法读取 | 采样失败,不进入有效回答分母,但进入尝试和失败统计 |
| 拒答或限额提示 | 单独保留为非有效内容回答,不自动当作未提及或正确回答 |
| 截断、未完成或联网状态无法确认 | 标记不完整或模式不确定,按事先规则处理并报告数量 |
这是一套示例规则。若项目专门研究拒答,也可以将其作为独立研究结果,但不能看到数据之后才决定哪些记录算有效。
回答内容指标之外,再报告:
1 | 采样有效率 = 满足预定有效性规则的回答数 ÷ 全部尝试数 |
这样可以避免某个平台只成功采到很少回答,却因为剔除了大量失败而看上去表现很好。
以回答为单位计算可见性指标
设某个固定分组有N条有效回答。这里的分组应明确平台、问题类型和版本,不直接把所有记录相加后称为全平台水平。
1 | 品牌提及率 = 含目标品牌的有效回答数 ÷ N |
同一回答出现五次品牌,提及分子仍只加一;引用自有站点三个页面,被引回答分子也只加一。另行分析引用URL数量时,要重新定义链接、域名和页面的去重规则。
N=0时报告“无有效样本”,不能给出0%的效果指标。指定平台根本没有采样时则报告“未采样”,也不能写成零引用。
品牌别名需要事先核对。同名词或歧义缩写先标为待判,不能只靠字符串命中。对来源链接,原始URL与解析后的目标URL分别保存:跟踪链接、失效链接或无法确认归属的地址标为待核实,不因标题里出现品牌就算自有站点。
模拟数据怎样算,怎样解释
下面是人为构造的单个平台、同一组非点名问题数据,仅演示计算。
| 指标 | 模拟批次A | 模拟批次B |
|---|---|---|
| 全部采样尝试 | 30 | 30 |
| 有效回答 | 27 | 24 |
| 含品牌的有效回答 | 6 | 8 |
| 引用自有站点的有效回答 | 3 | 4 |
| 正向推荐的有效回答 | 2 | 3 |
由此可得:
- 有效率:
27/30=90.0%,变为24/30=80.0%。 - 提及率:
6/27≈22.2%,变为8/24≈33.3%。 - 自有站点被引回答率:
3/27≈11.1%,变为4/24≈16.7%。 - 正向推荐率:
2/27≈7.4%,变为3/24=12.5%。
按未四舍五入值计算,提及率相差约11.1个百分点。它不是“增加11.1%的曝光”,更不是新增用户量。相对变化与百分点变化是不同计算,报告应直接展示原始分子、分母和比例。
B批次有效率下降,缺失样本来自哪些问题会影响比较。即使两个批次名称相同,也需要检查问题覆盖、错误分布和环境是否匹配。不能只把比例变大解释成优化成功。
重复采样同一道题也不等于获得同样多的独立用户证据。数据有按问题、日期或账号聚集的结构;做置信区间或显著性分析时,应采用符合采样结构的方法,本文的小表不用于统计推断。
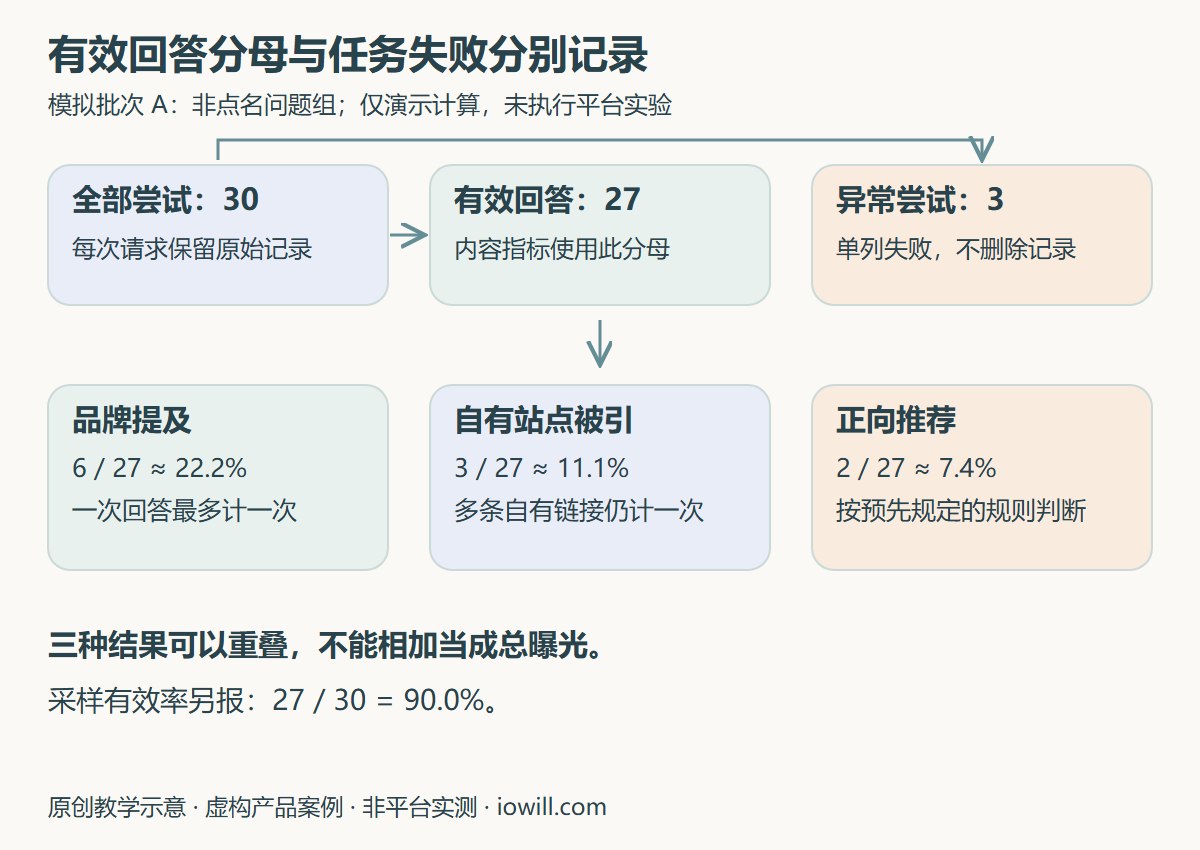
图2:原创模拟数据图:6/27约22.2%、3/27约11.1%、2/27约7.4%;三种结果可重叠,未执行平台实验。
准确性需要事实级审核
准确性建议单独建标注表。一条回答可能包含多个可核查陈述,每条保留原句、事实主题、参考版本和审核结论。
| 标注字段 | 教学示例 |
|---|---|
| 事实主题 | 导出能力与适用套餐 |
| 回答片段 | “所有套餐均支持完整导出。”——人为构造的句子 |
| 核查依据 | 该产品经确认的当期官方文档;本例未提供真实文档 |
| 结论 | 待核实;不能仅凭看起来合理标为正确 |
| 影响 | 若真实记录存在错误,说明影响哪些用户决策 |
实际使用时可标“正确、错误、无法核验、部分正确”等状态,并写明拆句和部分正确的处理规则。多个事实挤在一句话里时,宜拆成可分别核查的陈述,避免给复杂句硬打一个分数。
若报告确定性准确率,可以采用:
1 | 已判定事实准确率 = 正确事实数 ÷(正确事实数 + 错误事实数) |
部分正确、无法核验和待审核应另列数量,不放进上式的确定性分母;同时展示覆盖率,防止只核查容易的事实。没有品牌事实时写“无可评价事实”,不要写100%准确。
链接是否支持对应论点也可以单独审核,保留“支持、不支持、无法判定”和理由。有引用与引用正确,是两项检查。
官方后台与人工采样使用不同口径
Bing 在2026年2月的 AI Performance 公测介绍说明,它展示微软支持的相关体验中的引用次数、页面及部分检索词信息;引用数量不等同于排名或页面权威性。本文依据这份公开介绍解释口径,未登录后台实测,实际字段以使用时的产品为准。
后台“引用次数”与本文“含自有站点引用的有效回答比例”使用不同单位和分母,不可直接相加或比较。后台覆盖的产品也不能扩大解释为所有 AI 平台。
Google 的生成式搜索指导说明了其搜索索引与检索基础。这可以帮助解释可访问、被索引和最终展示之间的区别,但不能用 Google 的规则代替国内产品的具体实现。
站点日志里的抓取访问,可以支持“某个请求到达页面”的判断;确认机器人身份还需相应核验。它本身不能证明该页面进入了某次回答,更不能与咨询和订单直接画等号。
前后变化与因果效果分别报告
同一批问题前后表现不同,还可能受到平台更新、事件热度、其他媒体发布、站点故障以及账号环境影响。没有可比基线时只能报告当期观察,不能补造“优化前是零”。
如需评估某个动作,可以提前设计对照:选择条件相近、相互影响较小的页面或问题组,尽量随机分配改动,统一观察时段,记录并行活动。但同一站点的页面可能相互影响,问题之间也并非独立,分组本身不会自动产生可靠因果结论。
GEO 原始论文的v3摘要说明了可见性评估框架与领域差异;论文在特定实验条件下的结果不能转成客户的收益保证。本文借用“先定义指标再比较”的思路,没有复现该研究。
执行次数和内容数量作为过程指标单列;回答表现是观察结果,访问和咨询则需要独立的分析与归因依据。客户报告中应让这三层各自有清楚的证据。
可复制的监测与标注表
原始采样表,一行一次请求:
1 | sample_id,batch_id,question_id,question_set_version,brand_prompted,platform,surface,model_label,web_mode,environment_id,sampled_at,status,parent_sample_id,evidence_path |
回答级标注表,通过sample_id关联原始记录;真假标签只在核查后填写,未知值留空并说明原因:
1 | sample_id,mention,owned_site_cited,recommendation,raw_citation_urls,normalized_owned_urls,review_status,reviewer,notes |
事实级标注表,一行一个待核查事实:
1 | claim_id,sample_id,claim_text,reference_url,reference_version,verdict,reviewer,notes |
实际填写时,对包含英文逗号、双引号或换行的单元格按CSV规则转义,或直接使用表格工具导出。脱敏环境编号不包含账号密码,原始回答如含个人信息则限制访问;公开报告只展示获准的证据。
客户复盘报告应支持下一步决策
一页摘要可以包含:本期平台与问题范围、有效与失败样本量、分组的原始计数和比例、代表性证据、主要异常、已完成动作及后续负责人。完整原始记录作为受控附件,不把截图堆满正文。
对前面的模拟数据,可以这样写:
在模拟的同平台、非点名问题组中,B批次记录到8/24条有效回答提及品牌,A批次为6/27。两批次采样有效率分别为80.0%和90.0%;需核对缺失问题分布后再判断可比性。当前数字仅用于计算示范,不支持优化收益或因果结论。
真实项目还应写清未完成事项:某平台限额未采足,就报告缺口和恢复安排;某事实缺资料,就标为待核实。报告的完成标准,是让读者能回到证据、复算指标并判断下一步,而不是让每个数字都表现为增长。
参考资料
- Liu、Zhang、Liang:Evaluating Verifiability in Generative Search Engines(Findings of EMNLP 2023):核对出版页摘要中的引用支持概念,未复现研究。
- Aggarwal等:GEO: Generative Engine Optimization,v3(KDD 2024接收):核对摘要及版本,引用可见性框架和领域边界,不使用最高提升值作效果承诺。
- Bing:Introducing AI Performance in Bing Webmaster Tools Public Preview(2026-02-10):用于产品覆盖范围和引用统计单位,不宣称后台实测。
- Google:Optimizing your website for generative AI features on Google Search:用于说明 Google 搜索的检索基础,不代替其他平台机制。